Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Was ist die Varianz in der Statistik?
Was ist die Varianz in der Statistik? Die Varianz ist ein Maß für die Streuung oder Variation von Datenpunkten in einem Datensatz. Sie gibt an, wie weit die einzelnen Werte im Durchschnitt von dem Mittelwert abweichen. Eine hohe Varianz deutet darauf hin, dass die Datenpunkte weit verstreut sind, während eine niedrige Varianz darauf hindeutet, dass die Datenpunkte näher beieinander liegen. Die Varianz wird berechnet, indem die quadratische Abweichung jedes Datenpunktes vom Mittelwert summiert und durch die Anzahl der Datenpunkte geteilt wird. Sie ist ein wichtiges Maß in der Statistik, um die Verteilung von Daten zu verstehen und Muster oder Trends zu identifizieren. **
Könnten Sie in einfachen Worten erklären, was der Begriff "Varianz" in der Statistik bedeutet? Warum ist die Varianz eine wichtige Kennzahl in der Datenanalyse?
Die Varianz ist ein Maß dafür, wie weit die einzelnen Werte in einem Datensatz von ihrem Durchschnittswert abweichen. Je höher die Varianz, desto größer ist die Streuung der Daten. Die Varianz ist wichtig, um die Verteilung und die Unterschiede innerhalb eines Datensatzes zu verstehen und statistische Schlussfolgerungen zu ziehen. **

Ähnliche Suchbegriffe für Varianz
Top-Angebote
Produkte zum Begriff Varianz:
-
Grundkurs Machine Learning, Fachbücher von Paul WilmottMaschinelles Lernen – alle Grundlagen! Paul Wilmott ist für seine erhellende und unterhaltsame Darstellung angewandter Mathematik bekannt. Von der linearen Regression bis zu neuronalen Netzwerken führt er Sie durch alle Verfahren, und zwar komplett software-unabhängig. Der Vorteil dabei: Jeder Schritt ist schwarz auf weiss zu sehen, kein Framework kann etwas „verstecken“, es geht immer um die Sache selbst. Mit vielen Beispielen, Grafiken und Schritt-für-Schritt-Kästen. Für alle, die wirklich verstehen wollen, wie Maschinen lernen. Aus dem Inhalt: lineare Regression, k-nearest neighbors, naive Bayes-Klassifikatoren, k-Means-Algorithmus, Support Vector Machines, logistische Regression, selbstorganisierende Karten, Entscheidungsbäume, Reinforcement Learning, neuronale Netze.29,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Kochbuch, Fachbücher von Chris AlbonPython-Programmierer finden in diesem Kochbuch nahezu 200 wertvolle und jeweils in sich abgeschlossene Anleitungen zu Aufgabenstellungen aus dem Bereich des Machine Learning, wie sie für die tägliche Arbeit typisch sind – von der Vorverarbeitung der Daten bis zum Deep Learning. Entwickler, die mit Python und seinen Bibliotheken einschliesslich Pandas und Scikit-Learn vertraut sind, werden spezifische Probleme erfolgreich bewältigen – wie etwa Daten laden, Text und numerische Daten behandeln, Modelle auswählen, Dimensionalität reduzieren und vieles mehr. Jedes Rezept enthält Code, den Sie kopieren, zum Testen in eine kleine Beispieldatenmenge einfügen und dann anpassen können, um Ihre eigenen Anwendungen zu konstruieren. Darüber hinaus werden alle Lösungen diskutiert und wichtige Zusammenhänge hergestellt. Dieses Kochbuch unterstützt Sie dabei, den Schritt von der Theorie und den Konzepten hinein in die Praxis zu machen. Es liefert das praktische Rüstzeug, das Sie benötigen, um funktionierende Machine-Learning-Anwendungen zu entwickeln. In diesem Kochbuch finden Sie Rezepte für: - Vektoren, Matrizen und Arrays - den Umgang mit numerischen und kategorischen Daten, Texten, Bildern sowie Datum und Uhrzeit - das Reduzieren der Dimensionalität durch Merkmalsextraktion oder Merkmalsauswahl - Modellbewertung und -auswahl - lineare und logistische Regression, Bäume und Wälder und k-nächste Nachbarn - Support Vector Machine (SVM), naive Bayes, Clustering und neuronale Netze - das Speichern und Laden von trainierten Modellen Chris hat den Kochbuchcharakter seines Buchs genutzt, um nicht nur eine Referenz für erfahrene Profis zu bieten, sondern auch eine leicht zugängliche Reihe von kleinen Tutorials, die Anfänger schätzen werden. Dieses Buch ist eine wertvolle Ressource, egal ob man sein Wissen vor einem Vorstellungsgespräch als Data Scientist auffrischen möchte oder eine prägnante und dennoch gründliche Referenz für den Schreibtisch sucht.36,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Fundamentals, Fachbücher von Hui JiangDiese klare und kohärente Einführung in das überwachte maschinelle Lernen präsentiert die Kernkonzepte auf eine prägnante, logische und leicht verständliche Weise für Leser mit grundlegenden mathematischen Kenntnissen, aber ohne vorherige Erfahrung im maschinellen Lernen. Die Themen umfassen sowohl weit verbreitete traditionelle Methoden als auch die kürzlich populären Methoden des tiefen Lernens.72,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
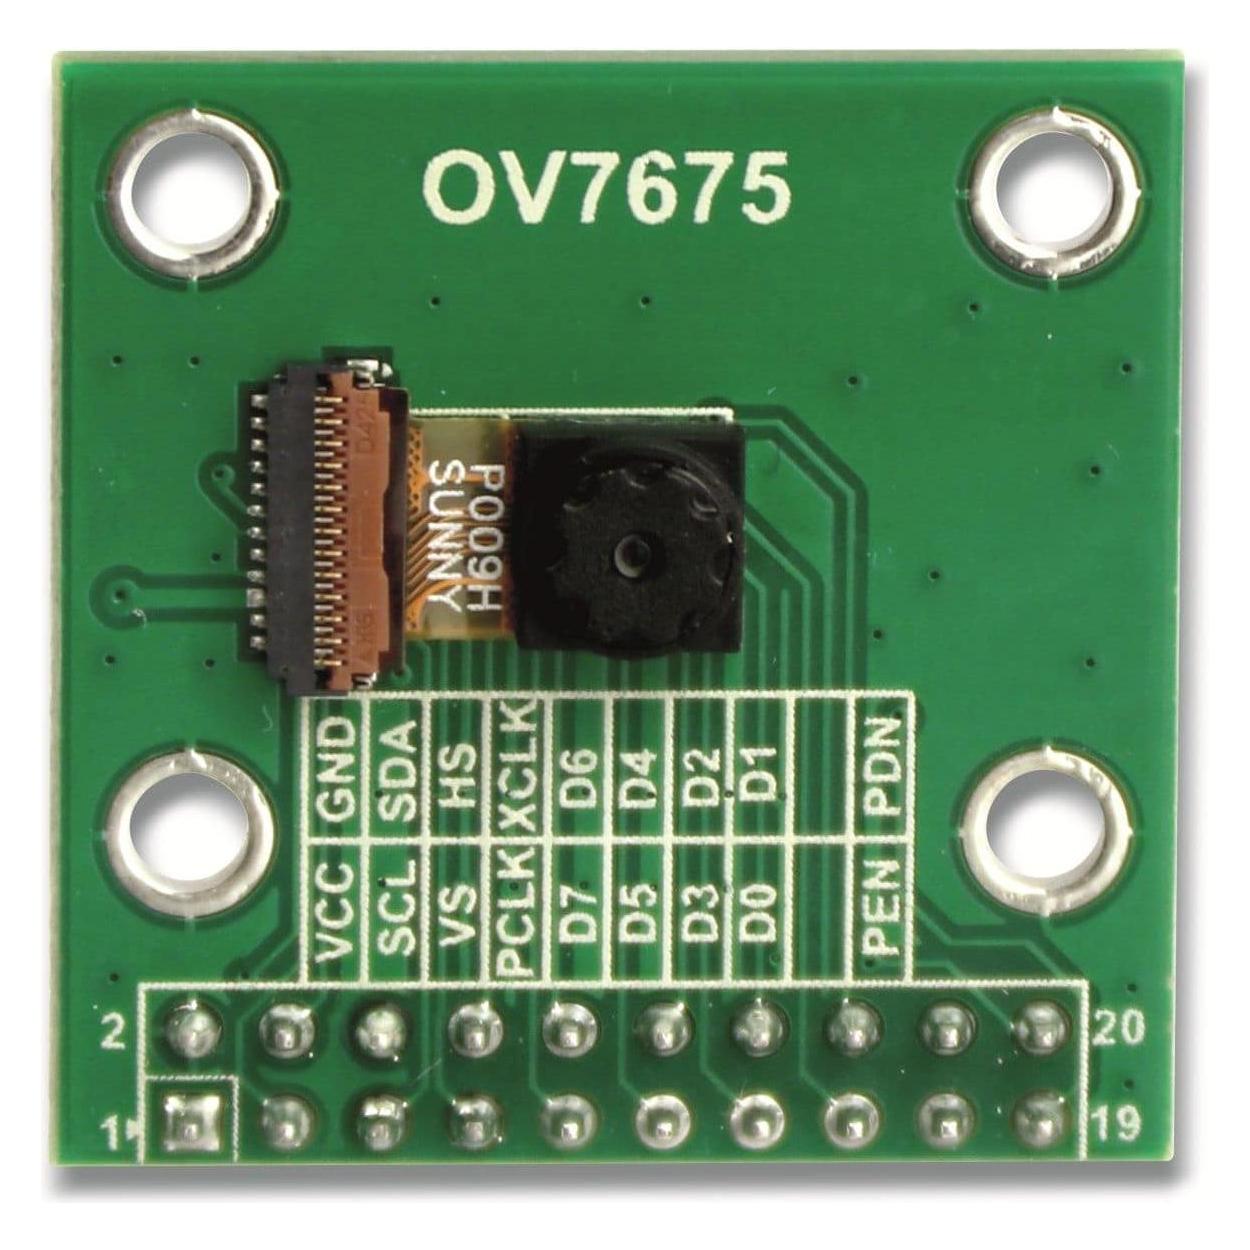
Arduino Tiny Machine Learning Kit, Entwicklungsboard + KitThe Tiny Machine Learning Kit, combined with the exciting TinyML applications and the delivery of TinyML on microcontroller courses that are part of EDX's TinyML Learning (TinyML Learning) specialization, gives you all the tools you need to bring your ML vision to life!. The kit consists of a powerful board with a microcontroller and a variety of sensors (Arduino Nano 33 BLE Sense). The board can move, accelerate, rotate, temperature, humidity, Record air pressure, noise, gestures, proximity, color, and light intensity. The kit also includes a camera module (OV7675) and a custom Arduino protective shield that makes it easy to install your components and create your own unique TinyML project. You can investigate practical ML use cases with classical algorithms as well as deep neural networks operated with TensorFlow Lite Micro. This text is machine translated.64,94 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sagt die Varianz in der Statistik aus?
Die Varianz in der Statistik gibt an, wie stark die einzelnen Werte eines Datensatzes um den Mittelwert streuen. Sie misst somit die durchschnittliche Abweichung der einzelnen Werte vom Mittelwert. Eine hohe Varianz deutet darauf hin, dass die Daten weit verstreut sind, während eine niedrige Varianz darauf hindeutet, dass die Daten nah beieinander liegen. Die Varianz wird oft als Maß für die Streuung oder die Unbeständigkeit der Daten verwendet und ist ein wichtiges Konzept in der statistischen Analyse. **
-
Wie berechne ich die Varianz in der Statistik?
Die Varianz in der Statistik wird berechnet, indem man die Differenz zwischen jedem einzelnen Datenpunkt und dem Durchschnitt der Datenpunkte quadriert. Diese quadrierten Abweichungen werden dann summiert und durch die Anzahl der Datenpunkte geteilt. Die Varianz gibt an, wie stark die einzelnen Datenpunkte um den Durchschnitt streuen. **
-
Was ist der Zusammenhang zwischen Varianz und Streuung in der Statistik?
Die Varianz ist ein Maß für die Streuung der Daten um den Mittelwert. Je größer die Varianz, desto größer ist die Streuung der Daten. Die Streuung beschreibt die Verteilung der Daten um den Mittelwert. **
-
Was ist die Bedeutung und Anwendung der Varianz in der Statistik?
Die Varianz ist ein Maß für die Streuung von Daten um den Mittelwert. Sie wird verwendet, um die Verteilung von Daten zu analysieren und Unterschiede zwischen Gruppen zu untersuchen. Je höher die Varianz, desto größer ist die Streuung der Daten. **
Was ist Varianz und wie wird sie in der Statistik verwendet?
Die Varianz ist ein Maß für die Streuung von Datenpunkten um den Mittelwert. In der Statistik wird die Varianz verwendet, um die Verteilung von Daten zu analysieren und die Abweichung der einzelnen Werte vom Durchschnitt zu quantifizieren. Sie dient auch dazu, die Genauigkeit von Vorhersagen und Schätzungen zu bewerten. **
Was sind die grundlegenden Charakteristiken und Anwendungen von Varianz in der Statistik?
Die Varianz ist ein Maß für die Streuung von Daten um den Mittelwert. Sie wird berechnet, indem die quadrierten Abweichungen der einzelnen Werte vom Mittelwert summiert werden. In der Statistik wird die Varianz verwendet, um die Homogenität einer Stichprobe zu überprüfen und um Unterschiede zwischen verschiedenen Gruppen oder Bedingungen zu analysieren. **
Top-Angebote
Produkte zum Begriff Varianz:
-
Grundkurs Machine Learning, Fachbücher von Paul WilmottMaschinelles Lernen – alle Grundlagen! Paul Wilmott ist für seine erhellende und unterhaltsame Darstellung angewandter Mathematik bekannt. Von der linearen Regression bis zu neuronalen Netzwerken führt er Sie durch alle Verfahren, und zwar komplett software-unabhängig. Der Vorteil dabei: Jeder Schritt ist schwarz auf weiss zu sehen, kein Framework kann etwas „verstecken“, es geht immer um die Sache selbst. Mit vielen Beispielen, Grafiken und Schritt-für-Schritt-Kästen. Für alle, die wirklich verstehen wollen, wie Maschinen lernen. Aus dem Inhalt: lineare Regression, k-nearest neighbors, naive Bayes-Klassifikatoren, k-Means-Algorithmus, Support Vector Machines, logistische Regression, selbstorganisierende Karten, Entscheidungsbäume, Reinforcement Learning, neuronale Netze.29,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Kochbuch, Fachbücher von Chris AlbonPython-Programmierer finden in diesem Kochbuch nahezu 200 wertvolle und jeweils in sich abgeschlossene Anleitungen zu Aufgabenstellungen aus dem Bereich des Machine Learning, wie sie für die tägliche Arbeit typisch sind – von der Vorverarbeitung der Daten bis zum Deep Learning. Entwickler, die mit Python und seinen Bibliotheken einschliesslich Pandas und Scikit-Learn vertraut sind, werden spezifische Probleme erfolgreich bewältigen – wie etwa Daten laden, Text und numerische Daten behandeln, Modelle auswählen, Dimensionalität reduzieren und vieles mehr. Jedes Rezept enthält Code, den Sie kopieren, zum Testen in eine kleine Beispieldatenmenge einfügen und dann anpassen können, um Ihre eigenen Anwendungen zu konstruieren. Darüber hinaus werden alle Lösungen diskutiert und wichtige Zusammenhänge hergestellt. Dieses Kochbuch unterstützt Sie dabei, den Schritt von der Theorie und den Konzepten hinein in die Praxis zu machen. Es liefert das praktische Rüstzeug, das Sie benötigen, um funktionierende Machine-Learning-Anwendungen zu entwickeln. In diesem Kochbuch finden Sie Rezepte für: - Vektoren, Matrizen und Arrays - den Umgang mit numerischen und kategorischen Daten, Texten, Bildern sowie Datum und Uhrzeit - das Reduzieren der Dimensionalität durch Merkmalsextraktion oder Merkmalsauswahl - Modellbewertung und -auswahl - lineare und logistische Regression, Bäume und Wälder und k-nächste Nachbarn - Support Vector Machine (SVM), naive Bayes, Clustering und neuronale Netze - das Speichern und Laden von trainierten Modellen Chris hat den Kochbuchcharakter seines Buchs genutzt, um nicht nur eine Referenz für erfahrene Profis zu bieten, sondern auch eine leicht zugängliche Reihe von kleinen Tutorials, die Anfänger schätzen werden. Dieses Buch ist eine wertvolle Ressource, egal ob man sein Wissen vor einem Vorstellungsgespräch als Data Scientist auffrischen möchte oder eine prägnante und dennoch gründliche Referenz für den Schreibtisch sucht.36,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist die Varianz in der Statistik?
Was ist die Varianz in der Statistik? Die Varianz ist ein Maß für die Streuung oder Variation von Datenpunkten in einem Datensatz. Sie gibt an, wie weit die einzelnen Werte im Durchschnitt von dem Mittelwert abweichen. Eine hohe Varianz deutet darauf hin, dass die Datenpunkte weit verstreut sind, während eine niedrige Varianz darauf hindeutet, dass die Datenpunkte näher beieinander liegen. Die Varianz wird berechnet, indem die quadratische Abweichung jedes Datenpunktes vom Mittelwert summiert und durch die Anzahl der Datenpunkte geteilt wird. Sie ist ein wichtiges Maß in der Statistik, um die Verteilung von Daten zu verstehen und Muster oder Trends zu identifizieren. **
-
Könnten Sie in einfachen Worten erklären, was der Begriff "Varianz" in der Statistik bedeutet? Warum ist die Varianz eine wichtige Kennzahl in der Datenanalyse?
Die Varianz ist ein Maß dafür, wie weit die einzelnen Werte in einem Datensatz von ihrem Durchschnittswert abweichen. Je höher die Varianz, desto größer ist die Streuung der Daten. Die Varianz ist wichtig, um die Verteilung und die Unterschiede innerhalb eines Datensatzes zu verstehen und statistische Schlussfolgerungen zu ziehen. **
-
Was sagt die Varianz in der Statistik aus?
Die Varianz in der Statistik gibt an, wie stark die einzelnen Werte eines Datensatzes um den Mittelwert streuen. Sie misst somit die durchschnittliche Abweichung der einzelnen Werte vom Mittelwert. Eine hohe Varianz deutet darauf hin, dass die Daten weit verstreut sind, während eine niedrige Varianz darauf hindeutet, dass die Daten nah beieinander liegen. Die Varianz wird oft als Maß für die Streuung oder die Unbeständigkeit der Daten verwendet und ist ein wichtiges Konzept in der statistischen Analyse. **
-
Wie berechne ich die Varianz in der Statistik?
Die Varianz in der Statistik wird berechnet, indem man die Differenz zwischen jedem einzelnen Datenpunkt und dem Durchschnitt der Datenpunkte quadriert. Diese quadrierten Abweichungen werden dann summiert und durch die Anzahl der Datenpunkte geteilt. Die Varianz gibt an, wie stark die einzelnen Datenpunkte um den Durchschnitt streuen. **
Ähnliche Suchbegriffe für Varianz
-
Machine Learning Fundamentals, Fachbücher von Hui JiangDiese klare und kohärente Einführung in das überwachte maschinelle Lernen präsentiert die Kernkonzepte auf eine prägnante, logische und leicht verständliche Weise für Leser mit grundlegenden mathematischen Kenntnissen, aber ohne vorherige Erfahrung im maschinellen Lernen. Die Themen umfassen sowohl weit verbreitete traditionelle Methoden als auch die kürzlich populären Methoden des tiefen Lernens.72,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Arduino Tiny Machine Learning Kit, Entwicklungsboard + KitThe Tiny Machine Learning Kit, combined with the exciting TinyML applications and the delivery of TinyML on microcontroller courses that are part of EDX's TinyML Learning (TinyML Learning) specialization, gives you all the tools you need to bring your ML vision to life!. The kit consists of a powerful board with a microcontroller and a variety of sensors (Arduino Nano 33 BLE Sense). The board can move, accelerate, rotate, temperature, humidity, Record air pressure, noise, gestures, proximity, color, and light intensity. The kit also includes a camera module (OV7675) and a custom Arduino protective shield that makes it easy to install your components and create your own unique TinyML project. You can investigate practical ML use cases with classical algorithms as well as deep neural networks operated with TensorFlow Lite Micro. This text is machine translated.64,94 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning für Zeitreihen, Fachbücher von Jochen Hirschle- Konzepte Schritt für Schritt erklärt - Die Eigenarten von Zeitreihendaten verstehen: Zeitfenster zum Anlernen einsetzen; mit latenten, saisonalen und Trend-Komponenten arbeiten - Anleitungen zur Umsetzung in Python mit ausführlichen Code-Kommentaren - Mit TensorFlow 2 Deep-Learning-Verfahren zur Prognose aufbauen, anlernen und produktiv einsetzen Daten über Vorgänge werden in der verarbeitenden Industrie, der Logistik oder im Finanzsektor im Sekundentakt aufgezeichnet: der Verlauf eines Aktienkurses, die Verkaufszahlen eines Produkts, die Sensordaten einer Turbine. Solche Daten informieren nicht nur über isolierte Zustände; sie sind wie Filme, die den Verlauf eines Vorgangs mit einer Serie einzelner Bilder nachzeichnen. Intelligente Algorithmen können die Muster dieser Verläufe analysieren, sie anlernen und über das Beobachtungsfenster hinaus fortschreiben: Zustände in der Zukunft werden prognostizierbar. Das Buch bietet eine leicht verständliche Einführung in die Konzepte und die Praxis der Zeitreihenanalyse. Es zeigt, wie bewährte und neuere Lernalgorithmen arbeiten und wie sie sich mit Python anlernen und produktiv einsetzen lassen. An einer Vielzahl von Anwendungsbeispielen werden die Vorbereitung der Daten, der Anlern- und Schätzprozess Schritt für Schritt erklärt. Aus dem Inhalt: - Zeitreihendaten mit pandas aufbereiten, fehlende Daten imputieren, mit Datumsangaben arbeiten - Grundprinzipien maschinellen Lernens: Konzepte und Umsetzung mit Python und Scikit-Learn - Feature-Preprocessing: Standardisierung, Dimensionsreduktion, Verarbeitung kategorialer Daten - ARIMA-Modelle zur Analyse univariater Zeitreihen: Vorbereitung, Anlernen und Prognose mit Python und Statsmodels - Komplexe Zeitreihen mit Deep-Learning-Verfahren analysieren: Rekurrente und konvolutionale Netze verstehen und mit Python und TensorFlow 2 aufbauen und anlernen - Mit Zeitfenstern arbeiten Vorkenntnisse in Machine-Learning-Verfahren sind nicht notwendig. Grundlegende Statistik- und.39,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
SparkFun MicroMod Machine Learning Carrier Board, Entwicklungsboard + KitDas MicroMod Machine Learning Carrier Board von SparkFun ist eine innovative Plattform, die es ermöglicht, mit verschiedenen Prozessoren der MicroMod-Reihe zu experimentieren. Es kombiniert die Funktionen des SparkFun Edge Boards und des SparkFun Artemis Boards und bietet die Möglichkeit, leistungsstarke Machine Learning-Anwendungen wie Spracherkennung, Gesten- und Bilderkennung lokal auszuführen. Durch die Nutzung von Edge Computing können Aufgaben wie die Audioanalyse direkt auf dem Board durchgeführt werden, was die Abhängigkeit von einer ständigen Internetverbindung verringert und gleichzeitig die Kosten und Komplexität reduziert. Das Board ist mit zwei MEMS-Mikrofonen, einem 3-Achsen-Beschleunigungsmesser und einem Anschluss für eine Kamera ausgestattet. Ein moderner USB-C-Anschluss erleichtert die Programmierung, während der JTAG-Anschluss fortgeschrittenen Nutzenden die Möglichkeit bietet, professionelle Tools zu verwenden. Ein praktischer Jumper ermöglicht zudem die Messung des Stromverbrauchs für Tests mit geringem Stromverbrauch. - Kombination von Edge- und Cloud-Computing-Funktionen - Zwei MEMS-Mikrofone für vielseitige Audioanwendungen - Eingebauter 3-Achsen-Beschleunigungsmesser für Bewegungserkennung - USB-C-Anschluss für einfache Programmierung.28,51 €*Versand: 3,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Zusammenhang zwischen Varianz und Streuung in der Statistik?
Die Varianz ist ein Maß für die Streuung der Daten um den Mittelwert. Je größer die Varianz, desto größer ist die Streuung der Daten. Die Streuung beschreibt die Verteilung der Daten um den Mittelwert. **
-
Was ist die Bedeutung und Anwendung der Varianz in der Statistik?
Die Varianz ist ein Maß für die Streuung von Daten um den Mittelwert. Sie wird verwendet, um die Verteilung von Daten zu analysieren und Unterschiede zwischen Gruppen zu untersuchen. Je höher die Varianz, desto größer ist die Streuung der Daten. **
-
Was ist Varianz und wie wird sie in der Statistik verwendet?
Die Varianz ist ein Maß für die Streuung von Datenpunkten um den Mittelwert. In der Statistik wird die Varianz verwendet, um die Verteilung von Daten zu analysieren und die Abweichung der einzelnen Werte vom Durchschnitt zu quantifizieren. Sie dient auch dazu, die Genauigkeit von Vorhersagen und Schätzungen zu bewerten. **
-
Was sind die grundlegenden Charakteristiken und Anwendungen von Varianz in der Statistik?
Die Varianz ist ein Maß für die Streuung von Daten um den Mittelwert. Sie wird berechnet, indem die quadrierten Abweichungen der einzelnen Werte vom Mittelwert summiert werden. In der Statistik wird die Varianz verwendet, um die Homogenität einer Stichprobe zu überprüfen und um Unterschiede zwischen verschiedenen Gruppen oder Bedingungen zu analysieren. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.