Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
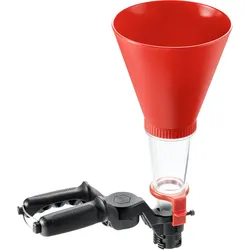
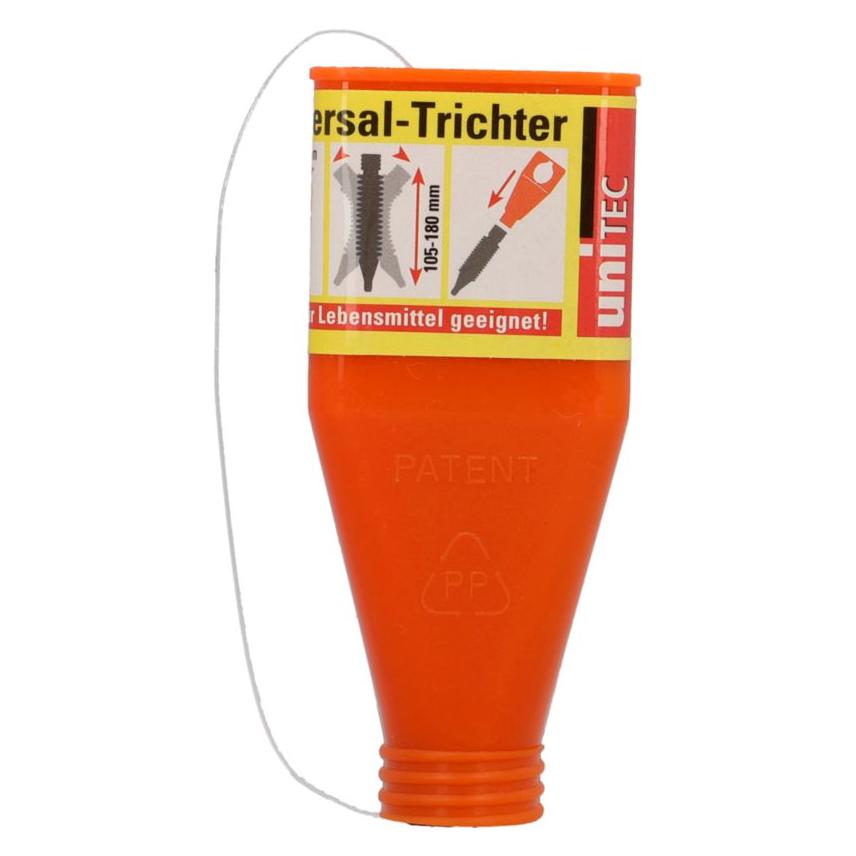
Ähnliche Suchbegriffe für FACOM-Universaltrichter
Top-Angebote
Produkte zum Begriff FACOM-Universaltrichter:
-
Cuisipro Universaltrichter 3 in EinemKüchentrichter 3-in-1 Trichter Das neue 3-in-1 Trichter-Set wird in drei Spezialtrichter zerlegt, die mit jedem Job in der Küche fertig werden. Der kleine Trichter ist für enge Flaschenhälse wie Essig- und Ölfläschchen, Seifenspender und...16,95 €*Versand: 6,82 €Sichere Weiterleitung zum Anbieter
-
Hünersdorff Universaltrichter, Ø 208 mm, Polyethylen (HDPE), lebensmittelecht, mit Sieb und ÜberlaufrandUmfüllen von flüssigen Rohstoffen leicht gemacht – mit diesem Universaltrichter in verschiedenen Größen und Ausführungen. Er ermöglicht es Ihnen, verschiedene flüssige Rohstoffe spielend einfach und sicher umzufüllen. Der aus Polyethylen gefertigte Universaltrichter ist lebensmittelbeständig und hält auch Säuren, Laugen, Kraftstoffen und Ölen stand. So eignet er sich für unterschiedliche Einsatzzwecke bspw. in der Lebensmittelindustrie oder in Werkstätten. Wichtige Details: * Universaltrichter für vielseitige Einsatzbereiche * Beständig gegen Säuren, Laugen, Kraftstoffe, Öle etc. * Temperaturbeständig: -20°C bis +70°C * Frei von Bisphenol A (BPA), lebensmittelecht * Aus Polyethylen (HDPE) * In verschiedenen Größen und Ausführungen Ø 80 mm, Ø 100 mm, Ø 140 mm und Ø 164 mm: * Mit einer Aufhängeöse und Entlüftungsrippen am Trichterende ausgestattet Ab Ø 208 mm: * Mit Überlaufrand (Spritzschutz) * Inkl. besonders feinmaschigem Siebeinsatz aus Edelstahl (auswechselbar) * Ø der Siebeinlage: 50 mm zu Trichter Ø 208 mm * Ø der Siebeinlage: 80 mm zu Trichter Ø 260 mm * Ø der Siebeinlage: 80 mm zu Trichter Ø 350 mm Ø 260 mm, Ø 350 mm: * Zusätzlich mit Griff6,89 €*Versand: 5,89 €Sichere Weiterleitung zum Anbieter


-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **

Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff FACOM-Universaltrichter:
-
FACOM UniversaltrichterUniversaltrichterProduktstärken:Universaltrichter, passt auf Öleinfüllstopfen von Motoren, Crimphülsen usw.KohlenstoffbeständigZum Einfüllen von Öl in den Motor, Kühlmittel usw.Technische Daten:Höhe [mm]: 275Dzrchmesser Tricher [mm]: min. 34 bis max. 6053,65 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Cuisipro Universaltrichter 3 in EinemKüchentrichter 3-in-1 Trichter Das neue 3-in-1 Trichter-Set wird in drei Spezialtrichter zerlegt, die mit jedem Job in der Küche fertig werden. Der kleine Trichter ist für enge Flaschenhälse wie Essig- und Ölfläschchen, Seifenspender und...16,95 €*Versand: 6,82 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für FACOM-Universaltrichter
-
Hünersdorff Universaltrichter, Ø 208 mm, Polyethylen (HDPE), lebensmittelecht, mit Sieb und ÜberlaufrandUmfüllen von flüssigen Rohstoffen leicht gemacht – mit diesem Universaltrichter in verschiedenen Größen und Ausführungen. Er ermöglicht es Ihnen, verschiedene flüssige Rohstoffe spielend einfach und sicher umzufüllen. Der aus Polyethylen gefertigte Universaltrichter ist lebensmittelbeständig und hält auch Säuren, Laugen, Kraftstoffen und Ölen stand. So eignet er sich für unterschiedliche Einsatzzwecke bspw. in der Lebensmittelindustrie oder in Werkstätten. Wichtige Details: * Universaltrichter für vielseitige Einsatzbereiche * Beständig gegen Säuren, Laugen, Kraftstoffe, Öle etc. * Temperaturbeständig: -20°C bis +70°C * Frei von Bisphenol A (BPA), lebensmittelecht * Aus Polyethylen (HDPE) * In verschiedenen Größen und Ausführungen Ø 80 mm, Ø 100 mm, Ø 140 mm und Ø 164 mm: * Mit einer Aufhängeöse und Entlüftungsrippen am Trichterende ausgestattet Ab Ø 208 mm: * Mit Überlaufrand (Spritzschutz) * Inkl. besonders feinmaschigem Siebeinsatz aus Edelstahl (auswechselbar) * Ø der Siebeinlage: 50 mm zu Trichter Ø 208 mm * Ø der Siebeinlage: 80 mm zu Trichter Ø 260 mm * Ø der Siebeinlage: 80 mm zu Trichter Ø 350 mm Ø 260 mm, Ø 350 mm: * Zusätzlich mit Griff6,89 €*Versand: 5,89 €Sichere Weiterleitung zum Anbieter
-
Wilmott, Paul: Grundkurs Machine LearningGrundkurs Machine Learning , Aus der Buchreihe »Informatik verstehen«. Ideal zum Selbststudium , Querlenker > Sportfederung , Erscheinungsjahr: 20200724, Produktform: Kartoniert, Titel der Reihe: Rheinwerk Computing##, Autoren: Wilmott, Paul, Seitenzahl/Blattzahl: 256, Themenüberschrift: COMPUTERS / General, Keyword: Hand-Buch Bücher lernen Studium Grundlagen Kurse Workshops Tutorials Wissen Anleitung Training Ausbildung; Robotik; Informatik verstehen; Programmierung programmieren; KI-Welt AI; Künstliche Intelligenz; Software-Entwicklung; Coder Coden; Neuronale Netze; Deep Learning; Mathematik, Fachschema: Informatik~Programmiersprachen~EDV / Theorie / Allgemeines, Fachkategorie: Informatik~Informationstechnik (IT), allgemeine Themen, Sprache: Deutsch, Warengruppe: HC/Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Länge: 228, Breite: 175, Höhe: 17, Gewicht: 480, Produktform: Klappenbroschur, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 232715029,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.