Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Wie kann man Duplicate Content einzeln markieren?
Um Duplicate Content einzeln zu markieren, kann man den Canonical-Tag verwenden. Dieser Tag wird in den Header einer Webseite eingefügt und gibt an, welche Version der Seite als die Hauptversion betrachtet werden soll. Dadurch wird vermieden, dass Suchmaschinen den Duplicate Content als separate Seiten indexieren und abstrafen. **
Was sind die möglichen Auswirkungen von Duplicate Content auf die SEO-Rankings einer Website? Wie kann man Duplicate Content vermeiden?
Duplicate Content kann zu einer Abwertung der SEO-Rankings führen, da Suchmaschinen Schwierigkeiten haben, die relevante Seite auszuwählen. Um Duplicate Content zu vermeiden, sollte man eindeutige und originale Inhalte erstellen, Canonical Tags verwenden und sicherstellen, dass keine Inhalte von anderen Websites kopiert werden. Außerdem ist es wichtig, interne Verlinkungen sorgfältig zu planen und Duplicate Content durch eine saubere URL-Struktur zu vermeiden. **
Ähnliche Suchbegriffe für Duplicate
Top-Angebote
Produkte zum Begriff Duplicate:
-
Machine Learning and Big Data-enabled Biotechnology, Fachbücher von Hal S. AlperDas Fachbuch 'Machine Learning and Big Data-enabled Biotechnology' bietet eine umfassende Darstellung der Anwendung von Machine Learning und Big Data in der Biotechnologie. Es gliedert sich in drei Hauptteile, die sich jeweils auf unterschiedliche Aspekte der Biotechnologie konzentrieren. Der erste Teil widmet sich der DNA, wobei Themen von der synthetischen Biologie, wie dem Design von Promotoren, bis hin zu Vorhersagen aus Genomsequenzen behandelt werden. Im zweiten Teil liegt der Fokus auf Proteinen, wobei sowohl Struktur- und Designwerkzeuge als auch die Entdeckung von Stoffwechselwegen und Retrobiosynthese thematisiert werden. Der abschliessende Teil befasst sich mit ganzen Zellen und beleuchtet Machine Learning Ansätze zur Genexpression sowie Vorhersagen von Phänotypen und der Leistung von Bioreaktoren. Das Buch bietet somit einen breiten Überblick über die Integration moderner Datenanalysemethoden in die biotechnologische Forschung und Entwicklung. Es richtet sich an Fachleute und Studierende, die an der Schnittstelle von Biotechnologie, Datenwissenschaft und Ingenieurwesen arbeiten.135,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Fundamentals, Fachbücher von Hui JiangDiese klare und kohärente Einführung in das überwachte maschinelle Lernen präsentiert die Kernkonzepte auf eine prägnante, logische und leicht verständliche Weise für Leser mit grundlegenden mathematischen Kenntnissen, aber ohne vorherige Erfahrung im maschinellen Lernen. Die Themen umfassen sowohl weit verbreitete traditionelle Methoden als auch die kürzlich populären Methoden des tiefen Lernens.72,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
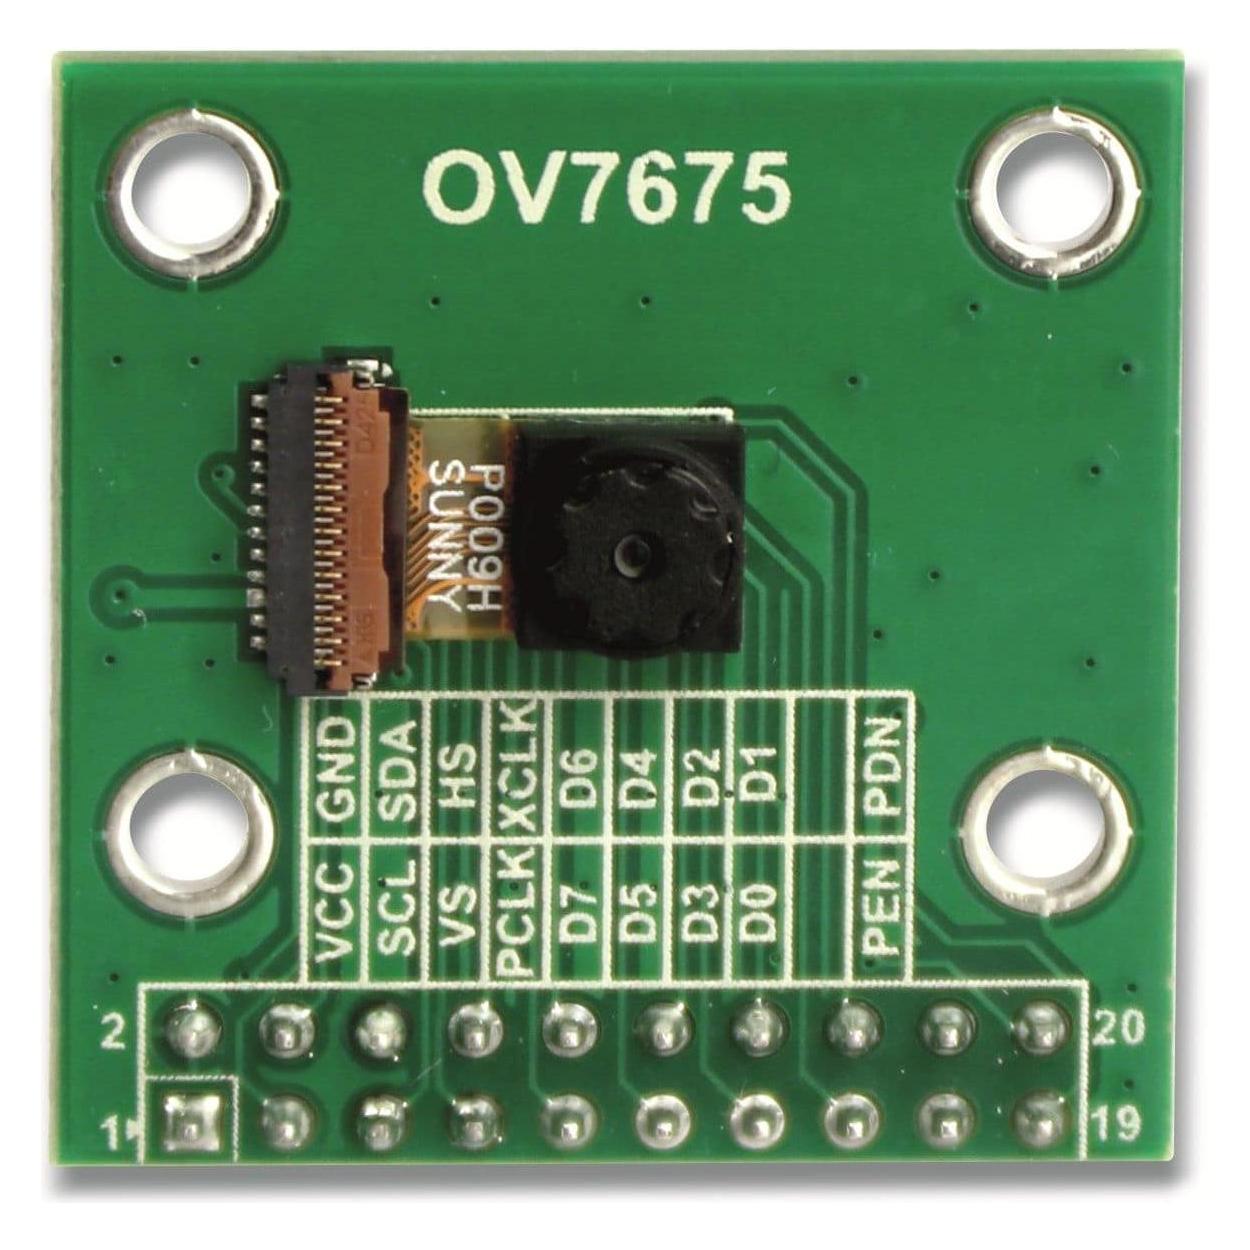
Arduino Tiny Machine Learning Kit, Entwicklungsboard + KitThe Tiny Machine Learning Kit, combined with the exciting TinyML applications and the delivery of TinyML on microcontroller courses that are part of EDX's TinyML Learning (TinyML Learning) specialization, gives you all the tools you need to bring your ML vision to life!. The kit consists of a powerful board with a microcontroller and a variety of sensors (Arduino Nano 33 BLE Sense). The board can move, accelerate, rotate, temperature, humidity, Record air pressure, noise, gestures, proximity, color, and light intensity. The kit also includes a camera module (OV7675) and a custom Arduino protective shield that makes it easy to install your components and create your own unique TinyML project. You can investigate practical ML use cases with classical algorithms as well as deep neural networks operated with TensorFlow Lite Micro. This text is machine translated.64,28 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die potenziellen Auswirkungen von Duplicate Content auf die Sichtbarkeit einer Webseite in Suchmaschinen? Wie kann man Duplicate Content vermeiden?
Duplicate Content kann dazu führen, dass Suchmaschinen die Seite abwerten oder sogar aus dem Index entfernen. Dies kann die Sichtbarkeit der Webseite in den Suchergebnissen erheblich beeinträchtigen. Um Duplicate Content zu vermeiden, sollten eindeutige und originelle Inhalte erstellt, Canonical Tags verwendet und interne Verlinkungen optimiert werden. **
-
Was ist Duplicate Code? Ich sehe oft in Foren, dass manche Leute ihren Code bezüglich Duplicate Code kritisieren, aber was soll das sein?
Duplicate Code bezieht sich auf Code, der an mehreren Stellen im Programm wiederholt wird. Das bedeutet, dass der gleiche Code an verschiedenen Stellen im Programm vorhanden ist, anstatt ihn an einer Stelle zu definieren und dann an verschiedenen Stellen aufzurufen. Duplicate Code kann zu Wartungsproblemen führen, da Änderungen an einer Stelle im Code an vielen anderen Stellen vorgenommen werden müssen. Es wird empfohlen, Duplicate Code zu vermeiden und stattdessen Funktionen oder Methoden zu verwenden, um den Code an einer Stelle zu definieren und an verschiedenen Stellen aufzurufen. **
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **


Was ist Duplicate Content und wie kann er vermieden werden?
Duplicate Content ist identischer Inhalt, der auf mehreren Webseiten erscheint und von Suchmaschinen als negativ bewertet wird. Um Duplicate Content zu vermeiden, sollte man eindeutige und originelle Inhalte erstellen, Canonical Tags verwenden, um die bevorzugte Version einer Seite festzulegen, und sicherstellen, dass interne Verlinkungen korrekt sind. **
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
Top-Angebote
Produkte zum Begriff Duplicate:
-
Duplicate Photo CleanerFotoduplikate in 3 Schritten finden und löschen Fotoduplikate in wenigen Minuten finden Ähnliche Fotos dank Merkmalerkennung finden Alle Bilder vergleichen und nebeneinander anzeigen Ordner vergleichen Duplikate in Adobe Lightroom finden Beschreibung Mit Duplicate Photo Cleaner werden Duplikate oder ähnliche Fotos auf Ihrem Computer in Sekunden gefunden. Die intelligent konzipierte Suchfunktion vergleicht Fotos so wie ein Mensch es tun würde, ist jedoch so schnell wie eine Maschine. Sie achtet auf Ähnlichkeiten zwischen Bildern und findet Fotoduplikate im Handumdrehen. Sie erkennt außerdem Fotos mit demselben Thema sowie in der Größe geänderte und bearbeitete Bilder. Funktionen Alben neu organisieren und Speicherplatz freigeben Die Zeiten, in denen man stundenlang Fotos durchsuchen musste, sind vorbei. Jetzt können Sie ähnliche Fotos ganz schnell finden und miteinander vergleichen. Anschließend löschen Sie die Bilder, die Sie nicht mehr brauchen und geben so Speicherplatz auf Ihrem Computer frei. Bilder nebeneinander anzeigen und vergleichen In der Mehrfachanzeige können alle Duplikate und ähnlichen Fotos auf einen Blick miteinander verglichen werden. Die Details der Bilder werden angezeigt, wenn Sie die Maus darüber führen. Duplikate in Adobe Lightroom finden Duplicate Photo Cleaner enthält eine Funktion, die die Verwaltung der Inhalte in Adobe Lightroom vereinfacht. Ein Bonus für Profi-Fotografen! Duplikate in 3 Schritten löschen 1. Ordner auswählen, in dem nach Duplikaten gesucht werden soll Wählen Sie zunächst den passenden Suchmodus. Importieren Sie dann einen oder mehrere Ordner, in denen nach Duplikaten gesucht werden soll. Sie können anhand Ihrer Einstellungen auch per Bild suchen. 2. Suche starten Klicken Sie auf 'Suchen' und warten Sie ein paar Sekunden, bis die Ergebnisse angezeigt werden. Die Anzahl der Treffer wird angezeigt. Klicken Sie erneut auf die grüne Schaltfläche, um die Duplikate anzuzeigen. 3. Duplikate löschen Die Duplikate werden nebeneinander angezeigt und Sie können sie sortieren, indem Sie die Originalfotos oder die Kopien auswählen. Mit einem Klick auf die Taste 'Löschen' werden die gewünschten Duplikate gelöscht. Bei Bedarf können gefundene Fotos auch in einen anderen Ordner verschoben werden. Mehrere Suchen Duplicate Photo Cleaner erlaubt die Wahl einer Suche je nach gewünschtem Ergebnis . Zur Auswahl einer Suchfunktion ändern Sie einfach den Suchmodus in der rechten oberen Ecke des Bildschirms und wählen den Modus aus, der Ihrem Bedarf entspricht. Klassische Suche: (Standard) Ein oder mehrere Ordner werden nach Duplikaten durchsucht. Detaillierte Suche zum Erkennen von ähnlichen Fotos: Importieren Sie ein Foto, zu dem alle Duplikate oder ähnlichen Bilder gefunden werden sollen. Sie können einen Bereich des Fotos auswählen, der analysiert werden soll. Anschließend werden alle ähnlichen Fotos im ausgewählten Ordner gesucht. Zwei Ordner vergleichen und Duplikate suchen: Je nach Arbeitsweise speichern Sie möglicherweise nicht alle Fotos im selben Ordner. Deshalb können Sie bei der Suche nach Duplikaten in zwei Ordnern ähnliche Bilder oder Duplikate an zwei verschiedenen Stellen suchen. Mediengerät durchsuchen: Sie können nicht nur Ihren PC, sondern auch Peripheriegeräte wie USB-Sticks oder Speicherkarten nach Duplikaten durchsuchen. Systemanforderungen Betriebssystem Windows: Windows 7, Windows 8, Windows 10 Mac: MacOS X 10.6 Snow Leopard, MacOS X 10.7 Lion, MacOS X 10.8 Mountain Lion, MacOS X 10.9 Mavericks, MacOS X 10.10 Yosemite, MacOS 10.11 El Capitan, MacOS 10.12 Sierra, MacOS 10.13 High Sierra, MacOS 10.14 Mojave49,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Nero Duplicate Manager Photo 2026Der Nero Duplicate Manager Photo im Detail: Eine technische Tour Der Nero Duplicate Manager Photo ist nicht einfach nur ein weiteres Tool zur Duplikatsuche. Es ist Ihre persönliche Bibliothekarin, die Ordnung in das Chaos bringt, das wir alle zu gut kennen. Hier sind die technischen Finessen, die es so unverzichtbar machen: Automatische Kategorisierung Die Software erkennt und kategorisiert Ihre Fotos automatisch nach Datum, Ort und sogar nach den abgebildeten Personen. So behalten Sie stets den Überblick über Ihre Erinnerungen. Visuelle Ähnlichkeitsanalyse Dank der fortschrittlichen Bilderkennungstechnologie kann der Nero Duplicate Manager Photo nicht nur exakte Kopien finden, sondern auch Bilder, die sich nur geringfügig unterscheiden. Ob es sich um leicht veränderte Bearbeitungen oder um Fotos handelt, die Sekunden auseinander aufgenommen wurden, das Tool spürt sie auf. Benutzerdefinierte Suchkriterien Nicht jeder hat dieselben Anforderungen, wenn es um Duplikate geht. Deshalb bietet der Nero Duplicate Manager Photo flexible Einstellungen, die es Ihnen ermöglichen, die Suchkriterien an Ihre persönlichen Bedürfnisse anzupassen. Sicherheitsnetz für Ihre Fotos Bevor irgendwelche Dateien entfernt werden, ermöglicht Ihnen die Software, eine Vorschau der identifizierten Duplikate anzusehen und zu entscheiden, welche behalten oder gelöscht werden sollen. So besteht keine Gefahr, dass wertvolle Fotos versehentlich verloren gehen. Einfaches Wiederherstellen Falls Sie sich umentscheiden, bietet der Nero Duplicate Manager Photo eine einfache Option zur Wiederherstellung gelöschter Bilder, sodass Sie immer auf der sicheren Seite sind. Cloud-Integration In der heutigen vernetzten Welt sind Fotos nicht nur auf physischen Laufwerken gespeichert. Nero hat dies erkannt und ermöglicht die Suche nach Duplikaten auch in populären Cloud-Speichern. Somit ist Ihr gesamter digitaler Fußabdruck abgedeckt. Es ist klar, dass der Nero Duplicate Manager Photo mehr als nur ein einfaches Tool zur Duplikatsuche ist. Es ist eine umfassende Lösung, die nicht nur dabei hilft, Speicherplatz freizugeben, sondern auch Ordnung und Struktur in Ihre Fotobibliothek bringt. Mit seiner benutzerfreundlichen Oberfläche, fortschrittlichen Technologie und flexiblen Funktionen steht es an der Spitze der Fotoverwaltungssoftware. Wenn Sie also Ihre digitale Fotoverwaltung ernst nehmen, ist der Kauf des Nero Duplicate Manager Photo eine Entscheidung, die Sie nicht bereuen werden. Organisieren Sie Ihre Fotos effizient, sparen Sie wertvollen Speicherplatz und genießen Sie Ihre schönsten Momente ohne die Sorge um Duplikate. Mit dem Nero Duplicate Manager Photo sind Sie bestens ausgerüstet, um das Beste aus Ihrer digitalen Fotowelt herauszuholen. Systemvoraussetzungen Systemvoraussetzung Anforderung Benötigter Arbeitsspeicher min. 1000 MB Benötigter Speicherplatz auf der Festplatte min. 150 MB Empfohlene Bildschirmauflösung min. 1024x76829,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning and Big Data-enabled Biotechnology, Fachbücher von Hal S. AlperDas Fachbuch 'Machine Learning and Big Data-enabled Biotechnology' bietet eine umfassende Darstellung der Anwendung von Machine Learning und Big Data in der Biotechnologie. Es gliedert sich in drei Hauptteile, die sich jeweils auf unterschiedliche Aspekte der Biotechnologie konzentrieren. Der erste Teil widmet sich der DNA, wobei Themen von der synthetischen Biologie, wie dem Design von Promotoren, bis hin zu Vorhersagen aus Genomsequenzen behandelt werden. Im zweiten Teil liegt der Fokus auf Proteinen, wobei sowohl Struktur- und Designwerkzeuge als auch die Entdeckung von Stoffwechselwegen und Retrobiosynthese thematisiert werden. Der abschliessende Teil befasst sich mit ganzen Zellen und beleuchtet Machine Learning Ansätze zur Genexpression sowie Vorhersagen von Phänotypen und der Leistung von Bioreaktoren. Das Buch bietet somit einen breiten Überblick über die Integration moderner Datenanalysemethoden in die biotechnologische Forschung und Entwicklung. Es richtet sich an Fachleute und Studierende, die an der Schnittstelle von Biotechnologie, Datenwissenschaft und Ingenieurwesen arbeiten.135,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann man Duplicate Content einzeln markieren?
Um Duplicate Content einzeln zu markieren, kann man den Canonical-Tag verwenden. Dieser Tag wird in den Header einer Webseite eingefügt und gibt an, welche Version der Seite als die Hauptversion betrachtet werden soll. Dadurch wird vermieden, dass Suchmaschinen den Duplicate Content als separate Seiten indexieren und abstrafen. **
-
Was sind die möglichen Auswirkungen von Duplicate Content auf die SEO-Rankings einer Website? Wie kann man Duplicate Content vermeiden?
Duplicate Content kann zu einer Abwertung der SEO-Rankings führen, da Suchmaschinen Schwierigkeiten haben, die relevante Seite auszuwählen. Um Duplicate Content zu vermeiden, sollte man eindeutige und originale Inhalte erstellen, Canonical Tags verwenden und sicherstellen, dass keine Inhalte von anderen Websites kopiert werden. Außerdem ist es wichtig, interne Verlinkungen sorgfältig zu planen und Duplicate Content durch eine saubere URL-Struktur zu vermeiden. **
-
Was sind die potenziellen Auswirkungen von Duplicate Content auf die Sichtbarkeit einer Webseite in Suchmaschinen? Wie kann man Duplicate Content vermeiden?
Duplicate Content kann dazu führen, dass Suchmaschinen die Seite abwerten oder sogar aus dem Index entfernen. Dies kann die Sichtbarkeit der Webseite in den Suchergebnissen erheblich beeinträchtigen. Um Duplicate Content zu vermeiden, sollten eindeutige und originelle Inhalte erstellt, Canonical Tags verwendet und interne Verlinkungen optimiert werden. **
-
Was ist Duplicate Code? Ich sehe oft in Foren, dass manche Leute ihren Code bezüglich Duplicate Code kritisieren, aber was soll das sein?
Duplicate Code bezieht sich auf Code, der an mehreren Stellen im Programm wiederholt wird. Das bedeutet, dass der gleiche Code an verschiedenen Stellen im Programm vorhanden ist, anstatt ihn an einer Stelle zu definieren und dann an verschiedenen Stellen aufzurufen. Duplicate Code kann zu Wartungsproblemen führen, da Änderungen an einer Stelle im Code an vielen anderen Stellen vorgenommen werden müssen. Es wird empfohlen, Duplicate Code zu vermeiden und stattdessen Funktionen oder Methoden zu verwenden, um den Code an einer Stelle zu definieren und an verschiedenen Stellen aufzurufen. **
Ähnliche Suchbegriffe für Duplicate
-
Machine Learning Fundamentals, Fachbücher von Hui JiangDiese klare und kohärente Einführung in das überwachte maschinelle Lernen präsentiert die Kernkonzepte auf eine prägnante, logische und leicht verständliche Weise für Leser mit grundlegenden mathematischen Kenntnissen, aber ohne vorherige Erfahrung im maschinellen Lernen. Die Themen umfassen sowohl weit verbreitete traditionelle Methoden als auch die kürzlich populären Methoden des tiefen Lernens.72,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Arduino Tiny Machine Learning Kit, Entwicklungsboard + KitThe Tiny Machine Learning Kit, combined with the exciting TinyML applications and the delivery of TinyML on microcontroller courses that are part of EDX's TinyML Learning (TinyML Learning) specialization, gives you all the tools you need to bring your ML vision to life!. The kit consists of a powerful board with a microcontroller and a variety of sensors (Arduino Nano 33 BLE Sense). The board can move, accelerate, rotate, temperature, humidity, Record air pressure, noise, gestures, proximity, color, and light intensity. The kit also includes a camera module (OV7675) and a custom Arduino protective shield that makes it easy to install your components and create your own unique TinyML project. You can investigate practical ML use cases with classical algorithms as well as deep neural networks operated with TensorFlow Lite Micro. This text is machine translated.64,28 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Kochbuch, Fachbücher von Chris AlbonPython-Programmierer finden in diesem Kochbuch nahezu 200 wertvolle und jeweils in sich abgeschlossene Anleitungen zu Aufgabenstellungen aus dem Bereich des Machine Learning, wie sie für die tägliche Arbeit typisch sind – von der Vorverarbeitung der Daten bis zum Deep Learning. Entwickler, die mit Python und seinen Bibliotheken einschliesslich Pandas und Scikit-Learn vertraut sind, werden spezifische Probleme erfolgreich bewältigen – wie etwa Daten laden, Text und numerische Daten behandeln, Modelle auswählen, Dimensionalität reduzieren und vieles mehr. Jedes Rezept enthält Code, den Sie kopieren, zum Testen in eine kleine Beispieldatenmenge einfügen und dann anpassen können, um Ihre eigenen Anwendungen zu konstruieren. Darüber hinaus werden alle Lösungen diskutiert und wichtige Zusammenhänge hergestellt. Dieses Kochbuch unterstützt Sie dabei, den Schritt von der Theorie und den Konzepten hinein in die Praxis zu machen. Es liefert das praktische Rüstzeug, das Sie benötigen, um funktionierende Machine-Learning-Anwendungen zu entwickeln. In diesem Kochbuch finden Sie Rezepte für: - Vektoren, Matrizen und Arrays - den Umgang mit numerischen und kategorischen Daten, Texten, Bildern sowie Datum und Uhrzeit - das Reduzieren der Dimensionalität durch Merkmalsextraktion oder Merkmalsauswahl - Modellbewertung und -auswahl - lineare und logistische Regression, Bäume und Wälder und k-nächste Nachbarn - Support Vector Machine (SVM), naive Bayes, Clustering und neuronale Netze - das Speichern und Laden von trainierten Modellen Chris hat den Kochbuchcharakter seines Buchs genutzt, um nicht nur eine Referenz für erfahrene Profis zu bieten, sondern auch eine leicht zugängliche Reihe von kleinen Tutorials, die Anfänger schätzen werden. Dieses Buch ist eine wertvolle Ressource, egal ob man sein Wissen vor einem Vorstellungsgespräch als Data Scientist auffrischen möchte oder eine prägnante und dennoch gründliche Referenz für den Schreibtisch sucht.36,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wilmott, Paul: Grundkurs Machine LearningGrundkurs Machine Learning , Aus der Buchreihe »Informatik verstehen«. Ideal zum Selbststudium , Querlenker > Sportfederung , Erscheinungsjahr: 20200724, Produktform: Kartoniert, Titel der Reihe: Rheinwerk Computing##, Autoren: Wilmott, Paul, Seitenzahl/Blattzahl: 256, Themenüberschrift: COMPUTERS / General, Keyword: Hand-Buch Bücher lernen Studium Grundlagen Kurse Workshops Tutorials Wissen Anleitung Training Ausbildung; Robotik; Informatik verstehen; Programmierung programmieren; KI-Welt AI; Künstliche Intelligenz; Software-Entwicklung; Coder Coden; Neuronale Netze; Deep Learning; Mathematik, Fachschema: Informatik~Programmiersprachen~EDV / Theorie / Allgemeines, Fachkategorie: Informatik~Informationstechnik (IT), allgemeine Themen, Sprache: Deutsch, Warengruppe: HC/Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Länge: 228, Breite: 175, Höhe: 17, Gewicht: 480, Produktform: Klappenbroschur, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 232715029,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was ist Duplicate Content und wie kann er vermieden werden?
Duplicate Content ist identischer Inhalt, der auf mehreren Webseiten erscheint und von Suchmaschinen als negativ bewertet wird. Um Duplicate Content zu vermeiden, sollte man eindeutige und originelle Inhalte erstellen, Canonical Tags verwenden, um die bevorzugte Version einer Seite festzulegen, und sicherstellen, dass interne Verlinkungen korrekt sind. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.