Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Was sind die gängigsten Methoden zur Datenerhebung und -analyse in der Statistik?
Die gängigsten Methoden zur Datenerhebung in der Statistik sind Umfragen, Experimente und Beobachtungen. Zur Datenanalyse werden häufig deskriptive Statistik, Inferenzstatistik und Regressionsanalysen verwendet. Diese Methoden helfen dabei, Muster, Trends und Beziehungen in den Daten zu identifizieren und Schlussfolgerungen zu ziehen. **
Was sind die grundlegenden Methoden zur Datenerhebung und -analyse in der Statistik?
Die grundlegenden Methoden zur Datenerhebung in der Statistik sind Umfragen, Experimente und Beobachtungen. Zur Datenanalyse werden häufig deskriptive Statistik, inferentielle Statistik und multivariate Analyse verwendet. Diese Methoden helfen, Muster, Trends und Beziehungen in den Daten zu identifizieren und Schlussfolgerungen zu ziehen. **
Ähnliche Suchbegriffe für Datenerhebung
Top-Angebote
Produkte zum Begriff Datenerhebung:
-
Machine Learning Fundamentals, Fachbücher von Hui JiangDiese klare und kohärente Einführung in das überwachte maschinelle Lernen präsentiert die Kernkonzepte auf eine prägnante, logische und leicht verständliche Weise für Leser mit grundlegenden mathematischen Kenntnissen, aber ohne vorherige Erfahrung im maschinellen Lernen. Die Themen umfassen sowohl weit verbreitete traditionelle Methoden als auch die kürzlich populären Methoden des tiefen Lernens.72,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Grundkurs Machine Learning, Fachbücher von Paul WilmottMaschinelles Lernen – alle Grundlagen! Paul Wilmott ist für seine erhellende und unterhaltsame Darstellung angewandter Mathematik bekannt. Von der linearen Regression bis zu neuronalen Netzwerken führt er Sie durch alle Verfahren, und zwar komplett software-unabhängig. Der Vorteil dabei: Jeder Schritt ist schwarz auf weiss zu sehen, kein Framework kann etwas „verstecken“, es geht immer um die Sache selbst. Mit vielen Beispielen, Grafiken und Schritt-für-Schritt-Kästen. Für alle, die wirklich verstehen wollen, wie Maschinen lernen. Aus dem Inhalt: lineare Regression, k-nearest neighbors, naive Bayes-Klassifikatoren, k-Means-Algorithmus, Support Vector Machines, logistische Regression, selbstorganisierende Karten, Entscheidungsbäume, Reinforcement Learning, neuronale Netze.29,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Kochbuch, Fachbücher von Chris AlbonPython-Programmierer finden in diesem Kochbuch nahezu 200 wertvolle und jeweils in sich abgeschlossene Anleitungen zu Aufgabenstellungen aus dem Bereich des Machine Learning, wie sie für die tägliche Arbeit typisch sind – von der Vorverarbeitung der Daten bis zum Deep Learning. Entwickler, die mit Python und seinen Bibliotheken einschliesslich Pandas und Scikit-Learn vertraut sind, werden spezifische Probleme erfolgreich bewältigen – wie etwa Daten laden, Text und numerische Daten behandeln, Modelle auswählen, Dimensionalität reduzieren und vieles mehr. Jedes Rezept enthält Code, den Sie kopieren, zum Testen in eine kleine Beispieldatenmenge einfügen und dann anpassen können, um Ihre eigenen Anwendungen zu konstruieren. Darüber hinaus werden alle Lösungen diskutiert und wichtige Zusammenhänge hergestellt. Dieses Kochbuch unterstützt Sie dabei, den Schritt von der Theorie und den Konzepten hinein in die Praxis zu machen. Es liefert das praktische Rüstzeug, das Sie benötigen, um funktionierende Machine-Learning-Anwendungen zu entwickeln. In diesem Kochbuch finden Sie Rezepte für: - Vektoren, Matrizen und Arrays - den Umgang mit numerischen und kategorischen Daten, Texten, Bildern sowie Datum und Uhrzeit - das Reduzieren der Dimensionalität durch Merkmalsextraktion oder Merkmalsauswahl - Modellbewertung und -auswahl - lineare und logistische Regression, Bäume und Wälder und k-nächste Nachbarn - Support Vector Machine (SVM), naive Bayes, Clustering und neuronale Netze - das Speichern und Laden von trainierten Modellen Chris hat den Kochbuchcharakter seines Buchs genutzt, um nicht nur eine Referenz für erfahrene Profis zu bieten, sondern auch eine leicht zugängliche Reihe von kleinen Tutorials, die Anfänger schätzen werden. Dieses Buch ist eine wertvolle Ressource, egal ob man sein Wissen vor einem Vorstellungsgespräch als Data Scientist auffrischen möchte oder eine prägnante und dennoch gründliche Referenz für den Schreibtisch sucht.36,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
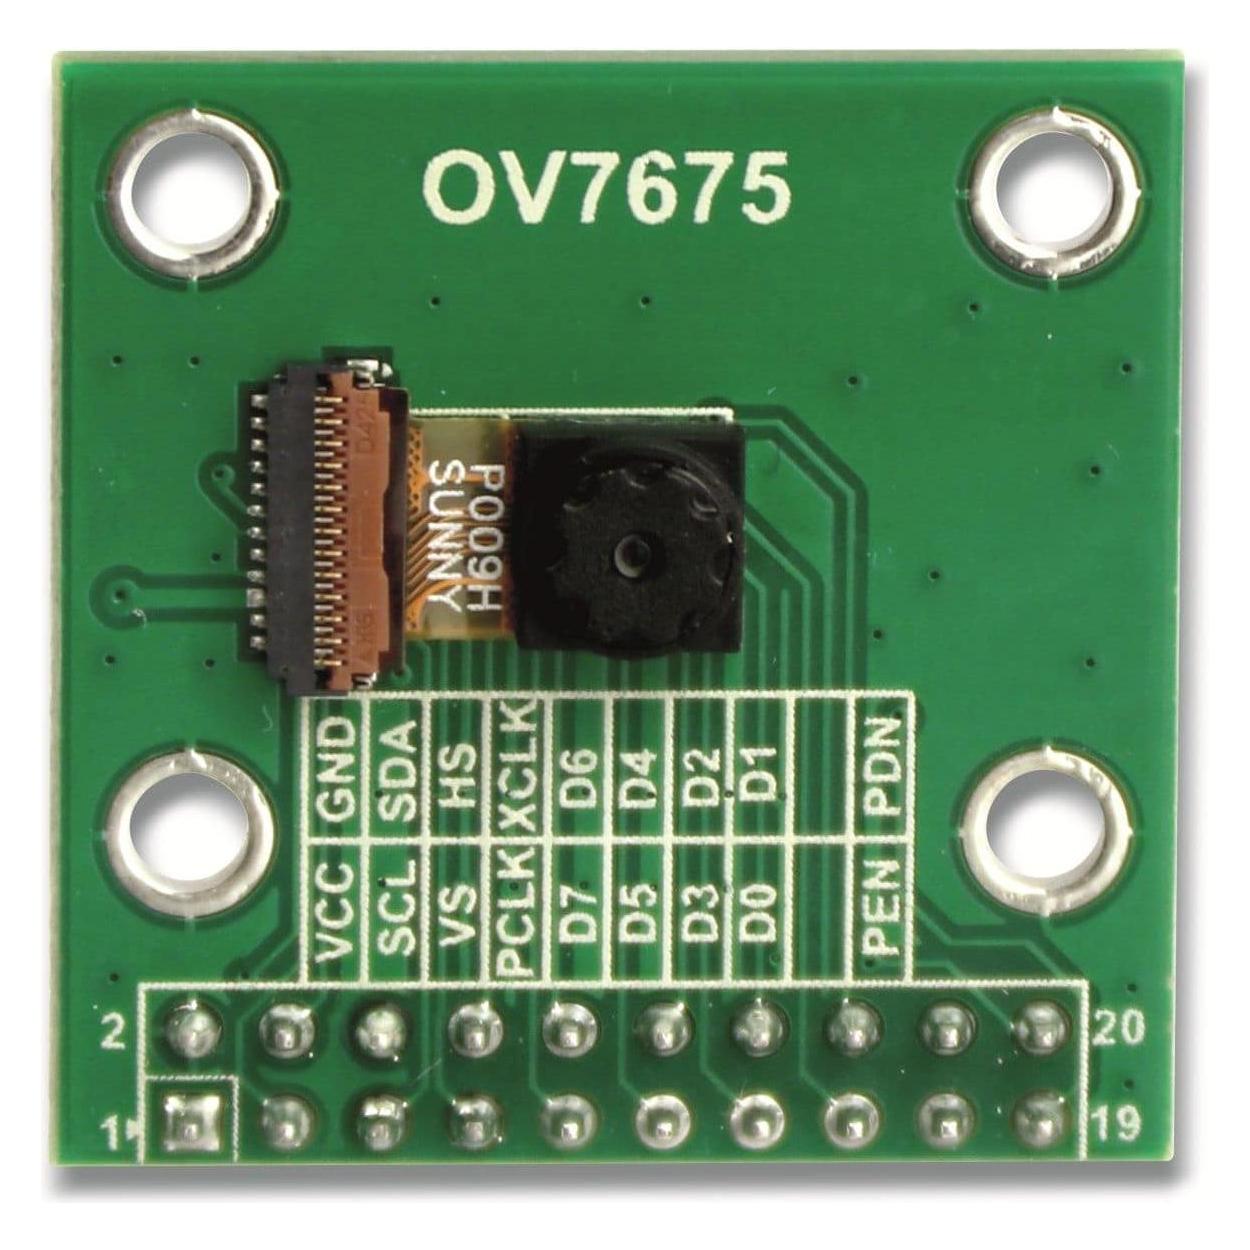
Arduino Tiny Machine Learning Kit, Entwicklungsboard + KitThe Tiny Machine Learning Kit, combined with the exciting TinyML applications and the delivery of TinyML on microcontroller courses that are part of EDX's TinyML Learning (TinyML Learning) specialization, gives you all the tools you need to bring your ML vision to life!. The kit consists of a powerful board with a microcontroller and a variety of sensors (Arduino Nano 33 BLE Sense). The board can move, accelerate, rotate, temperature, humidity, Record air pressure, noise, gestures, proximity, color, and light intensity. The kit also includes a camera module (OV7675) and a custom Arduino protective shield that makes it easy to install your components and create your own unique TinyML project. You can investigate practical ML use cases with classical algorithms as well as deep neural networks operated with TensorFlow Lite Micro. This text is machine translated.64,94 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die wichtigsten Methoden zur Datenerhebung und -analyse in der Statistik?
Die wichtigsten Methoden zur Datenerhebung in der Statistik sind Umfragen, Experimente und Beobachtungen. Zur Datenauswertung werden häufig deskriptive Statistik, Inferenzstatistik und Regressionsanalysen verwendet. Die Wahl der Methode hängt von der Art der Daten und der Forschungsfrage ab. **
-
Was sind die häufigsten Methoden der Datenerhebung und -analyse in der Statistik?
Die häufigsten Methoden der Datenerhebung in der Statistik sind Umfragen, Experimente und Beobachtungen. Zur Analyse der Daten werden statistische Verfahren wie Regression, Korrelation und Hypothesentests verwendet. Zudem werden oft Softwareprogramme wie SPSS oder R verwendet, um die Daten zu analysieren. **
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **

Was ist eine empirische Datenerhebung?
Eine empirische Datenerhebung bezieht sich auf die systematische Sammlung von Daten durch Beobachtung oder Experimente, um wissenschaftliche Erkenntnisse zu gewinnen. Dieser Prozess beinhaltet die Erfassung von Informationen aus der realen Welt, um Hypothesen zu überprüfen oder Forschungsfragen zu beantworten. Beispiele für empirische Datenerhebungen sind Umfragen, Interviews, Beobachtungen und Experimente. Durch die Verwendung empirischer Methoden können Forscher objektive und verlässliche Daten sammeln, um ihre Forschungsziele zu erreichen. Die Ergebnisse einer empirischen Datenerhebung dienen als Grundlage für die Analyse, Interpretation und Schlussfolgerungen in wissenschaftlichen Studien. **
Was versteht man unter Datenerhebung?
Was versteht man unter Datenerhebung? Datenerhebung bezieht sich auf den Prozess, bei dem Informationen gesammelt und aufgezeichnet werden, um sie später zu analysieren und zu interpretieren. Dies kann durch verschiedene Methoden wie Umfragen, Interviews, Beobachtungen oder Experimente erfolgen. Das Ziel der Datenerhebung ist es, relevante Daten zu sammeln, um fundierte Entscheidungen treffen zu können. Es ist wichtig, dass die Datenerhebung sorgfältig geplant und durchgeführt wird, um genaue und zuverlässige Ergebnisse zu erhalten. **
Top-Angebote
Produkte zum Begriff Datenerhebung:
-
Leistungsbezogene Datenerhebung im gesundheitsorientierten Trainingsalltag, Band 1, Ratgeber von Urs GeigerFachbuch aus dem Jahr 2023 im Fachbereich Sport - Sportmedizin, Therapie, Ernährung. In diesem ersten Band werden die statistischen Grundlagen strukturierter Datenerhebung übersichtlich beschrieben. Danach folgt das Schwerpunktthema der nicht apparativen Kraftmessverfahren. (Sport-)Physiotherapie und Sportmedizin, Bewegungswissenschaften, Leistungsdiagnostik und Training in Leistungs-, Fitness- und Breitensport verfolgen grundsätzlich über angewandte Nutzung der allgemeinen bzw. speziellen Trainingslehre das gleiche Hauptziel: die körperliche Leistungsfähigkeit von Trainierenden zu verbessern. Die jeweiligen wissensbasierten Ansätze innerhalb der Fachgruppen sind noch nicht immer kompatibel, was die unterschiedlichen Meinungen betreffend den jeweiligen Trainingsprozess erklärt. Grundlage für eine sachliche Diskussion über Trainingsmethoden, -inhalte und -mittel bietet die fundierte wissenschaftliche Analyse, namentlich der Indikation, Nützlichkeit bzw. Wirksamkeit verschiedenster Trainingsinhalte. Insbesondere das Gütekriterium der Validität ist bei diversen (Leistungs-)Tests und Übungen oftmals noch nicht untersucht. Mit dieser Arbeit wird an ausgesuchten Krafttests exemplarisch aufgezeigt, wie nach den anfangs genannten Kriterien die Aussagekraft von Testübungen genauer eingegrenzt werden kann. In diesem Sinne soll die Arbeit auch dazu anregen, dass künftig auf universitärer Ebene oder Fachhochschulen weitere empirische Forschung im Bereich der alltagsrelevanten Testverfahren betreffend die Gültigkeit und Evidenz erfolgt, zur Verbesserung des Nutzens für die praktisch tätigen Bewegungsexperten.52,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Fundamentals, Fachbücher von Hui JiangDiese klare und kohärente Einführung in das überwachte maschinelle Lernen präsentiert die Kernkonzepte auf eine prägnante, logische und leicht verständliche Weise für Leser mit grundlegenden mathematischen Kenntnissen, aber ohne vorherige Erfahrung im maschinellen Lernen. Die Themen umfassen sowohl weit verbreitete traditionelle Methoden als auch die kürzlich populären Methoden des tiefen Lernens.72,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Grundkurs Machine Learning, Fachbücher von Paul WilmottMaschinelles Lernen – alle Grundlagen! Paul Wilmott ist für seine erhellende und unterhaltsame Darstellung angewandter Mathematik bekannt. Von der linearen Regression bis zu neuronalen Netzwerken führt er Sie durch alle Verfahren, und zwar komplett software-unabhängig. Der Vorteil dabei: Jeder Schritt ist schwarz auf weiss zu sehen, kein Framework kann etwas „verstecken“, es geht immer um die Sache selbst. Mit vielen Beispielen, Grafiken und Schritt-für-Schritt-Kästen. Für alle, die wirklich verstehen wollen, wie Maschinen lernen. Aus dem Inhalt: lineare Regression, k-nearest neighbors, naive Bayes-Klassifikatoren, k-Means-Algorithmus, Support Vector Machines, logistische Regression, selbstorganisierende Karten, Entscheidungsbäume, Reinforcement Learning, neuronale Netze.29,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Datenerhebung und -analyse in der Statistik?
Die gängigsten Methoden zur Datenerhebung in der Statistik sind Umfragen, Experimente und Beobachtungen. Zur Datenanalyse werden häufig deskriptive Statistik, Inferenzstatistik und Regressionsanalysen verwendet. Diese Methoden helfen dabei, Muster, Trends und Beziehungen in den Daten zu identifizieren und Schlussfolgerungen zu ziehen. **
-
Was sind die grundlegenden Methoden zur Datenerhebung und -analyse in der Statistik?
Die grundlegenden Methoden zur Datenerhebung in der Statistik sind Umfragen, Experimente und Beobachtungen. Zur Datenanalyse werden häufig deskriptive Statistik, inferentielle Statistik und multivariate Analyse verwendet. Diese Methoden helfen, Muster, Trends und Beziehungen in den Daten zu identifizieren und Schlussfolgerungen zu ziehen. **
-
Was sind die wichtigsten Methoden zur Datenerhebung und -analyse in der Statistik?
Die wichtigsten Methoden zur Datenerhebung in der Statistik sind Umfragen, Experimente und Beobachtungen. Zur Datenauswertung werden häufig deskriptive Statistik, Inferenzstatistik und Regressionsanalysen verwendet. Die Wahl der Methode hängt von der Art der Daten und der Forschungsfrage ab. **
-
Was sind die häufigsten Methoden der Datenerhebung und -analyse in der Statistik?
Die häufigsten Methoden der Datenerhebung in der Statistik sind Umfragen, Experimente und Beobachtungen. Zur Analyse der Daten werden statistische Verfahren wie Regression, Korrelation und Hypothesentests verwendet. Zudem werden oft Softwareprogramme wie SPSS oder R verwendet, um die Daten zu analysieren. **
Ähnliche Suchbegriffe für Datenerhebung
-
Machine Learning Kochbuch, Fachbücher von Chris AlbonPython-Programmierer finden in diesem Kochbuch nahezu 200 wertvolle und jeweils in sich abgeschlossene Anleitungen zu Aufgabenstellungen aus dem Bereich des Machine Learning, wie sie für die tägliche Arbeit typisch sind – von der Vorverarbeitung der Daten bis zum Deep Learning. Entwickler, die mit Python und seinen Bibliotheken einschliesslich Pandas und Scikit-Learn vertraut sind, werden spezifische Probleme erfolgreich bewältigen – wie etwa Daten laden, Text und numerische Daten behandeln, Modelle auswählen, Dimensionalität reduzieren und vieles mehr. Jedes Rezept enthält Code, den Sie kopieren, zum Testen in eine kleine Beispieldatenmenge einfügen und dann anpassen können, um Ihre eigenen Anwendungen zu konstruieren. Darüber hinaus werden alle Lösungen diskutiert und wichtige Zusammenhänge hergestellt. Dieses Kochbuch unterstützt Sie dabei, den Schritt von der Theorie und den Konzepten hinein in die Praxis zu machen. Es liefert das praktische Rüstzeug, das Sie benötigen, um funktionierende Machine-Learning-Anwendungen zu entwickeln. In diesem Kochbuch finden Sie Rezepte für: - Vektoren, Matrizen und Arrays - den Umgang mit numerischen und kategorischen Daten, Texten, Bildern sowie Datum und Uhrzeit - das Reduzieren der Dimensionalität durch Merkmalsextraktion oder Merkmalsauswahl - Modellbewertung und -auswahl - lineare und logistische Regression, Bäume und Wälder und k-nächste Nachbarn - Support Vector Machine (SVM), naive Bayes, Clustering und neuronale Netze - das Speichern und Laden von trainierten Modellen Chris hat den Kochbuchcharakter seines Buchs genutzt, um nicht nur eine Referenz für erfahrene Profis zu bieten, sondern auch eine leicht zugängliche Reihe von kleinen Tutorials, die Anfänger schätzen werden. Dieses Buch ist eine wertvolle Ressource, egal ob man sein Wissen vor einem Vorstellungsgespräch als Data Scientist auffrischen möchte oder eine prägnante und dennoch gründliche Referenz für den Schreibtisch sucht.36,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Arduino Tiny Machine Learning Kit, Entwicklungsboard + KitThe Tiny Machine Learning Kit, combined with the exciting TinyML applications and the delivery of TinyML on microcontroller courses that are part of EDX's TinyML Learning (TinyML Learning) specialization, gives you all the tools you need to bring your ML vision to life!. The kit consists of a powerful board with a microcontroller and a variety of sensors (Arduino Nano 33 BLE Sense). The board can move, accelerate, rotate, temperature, humidity, Record air pressure, noise, gestures, proximity, color, and light intensity. The kit also includes a camera module (OV7675) and a custom Arduino protective shield that makes it easy to install your components and create your own unique TinyML project. You can investigate practical ML use cases with classical algorithms as well as deep neural networks operated with TensorFlow Lite Micro. This text is machine translated.64,94 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
SparkFun MicroMod Machine Learning Carrier Board, Entwicklungsboard + KitDas MicroMod Machine Learning Carrier Board von SparkFun ist eine innovative Plattform, die es ermöglicht, mit verschiedenen Prozessoren der MicroMod-Reihe zu experimentieren. Es kombiniert die Funktionen des SparkFun Edge Boards und des SparkFun Artemis Boards und bietet die Möglichkeit, leistungsstarke Machine Learning-Anwendungen wie Spracherkennung, Gesten- und Bilderkennung lokal auszuführen. Durch die Nutzung von Edge Computing können Aufgaben wie die Audioanalyse direkt auf dem Board durchgeführt werden, was die Abhängigkeit von einer ständigen Internetverbindung verringert und gleichzeitig die Kosten und Komplexität reduziert. Das Board ist mit zwei MEMS-Mikrofonen, einem 3-Achsen-Beschleunigungsmesser und einem Anschluss für eine Kamera ausgestattet. Ein moderner USB-C-Anschluss erleichtert die Programmierung, während der JTAG-Anschluss fortgeschrittenen Nutzenden die Möglichkeit bietet, professionelle Tools zu verwenden. Ein praktischer Jumper ermöglicht zudem die Messung des Stromverbrauchs für Tests mit geringem Stromverbrauch. - Kombination von Edge- und Cloud-Computing-Funktionen - Zwei MEMS-Mikrofone für vielseitige Audioanwendungen - Eingebauter 3-Achsen-Beschleunigungsmesser für Bewegungserkennung - USB-C-Anschluss für einfache Programmierung.28,51 €*Versand: 3,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning For Kids, Kinderbücher von Dale LaneEine praxisnahe, anwendungsorientierte Einführung in maschinelles Lernen und künstliche Intelligenz (KI). Erstellen Sie fesselnde KI-gestützte Spiele und Anwendungen mit der Scratch-Programmiersprache. KI leicht gemacht mit 13 Projekten. Maschinelles Lernen (auch bekannt als ML) ist einer der Grundpfeiler der KI oder künstlichen Intelligenz. KI basiert auf der Idee, dass Computer eigenständig lernen können, mit Ihrer Hilfe. Maschinelles Lernen für Kinder führt Sie schmerzlos in das Thema maschinelles Lernen ein. Mit diesem Buch und der kostenlosen, Scratch-basierten Begleitwebsite werden Sie sehen, wie einfach es ist, maschinelles Lernen in Ihre eigenen Projekte zu integrieren. Sie müssen nicht einmal wissen, wie man programmiert! Schritt für Schritt entdecken Sie, wie maschinelle Lernsysteme trainiert werden können, um Texte, Bilder, Zahlen und Geräusche zu erkennen, und wie Sie Ihre Modelle trainieren können, um sie zu verbessern. Sie verwandeln Ihre Modelle in 13 unterhaltsame Computerspiele und Apps, darunter: - Ein Spiel von Schere, Stein, Papier, das Ihre Handformen erkennt - Einen Computercharakter, der auf Beleidigungen und Komplimente reagiert - Einen interaktiven virtuellen Assistenten - Eine Filmempfehlungs-App - Eine KI-Version von Pac-Man Es sind keine Vorkenntnisse erforderlich, und die Schritt-für-Schritt-Anleitungen stellen sicher, dass jeder mitmachen kann! Keine Erfahrung notwendig! Ab 12 Jahren.28,30 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was ist eine empirische Datenerhebung?
Eine empirische Datenerhebung bezieht sich auf die systematische Sammlung von Daten durch Beobachtung oder Experimente, um wissenschaftliche Erkenntnisse zu gewinnen. Dieser Prozess beinhaltet die Erfassung von Informationen aus der realen Welt, um Hypothesen zu überprüfen oder Forschungsfragen zu beantworten. Beispiele für empirische Datenerhebungen sind Umfragen, Interviews, Beobachtungen und Experimente. Durch die Verwendung empirischer Methoden können Forscher objektive und verlässliche Daten sammeln, um ihre Forschungsziele zu erreichen. Die Ergebnisse einer empirischen Datenerhebung dienen als Grundlage für die Analyse, Interpretation und Schlussfolgerungen in wissenschaftlichen Studien. **
-
Was versteht man unter Datenerhebung?
Was versteht man unter Datenerhebung? Datenerhebung bezieht sich auf den Prozess, bei dem Informationen gesammelt und aufgezeichnet werden, um sie später zu analysieren und zu interpretieren. Dies kann durch verschiedene Methoden wie Umfragen, Interviews, Beobachtungen oder Experimente erfolgen. Das Ziel der Datenerhebung ist es, relevante Daten zu sammeln, um fundierte Entscheidungen treffen zu können. Es ist wichtig, dass die Datenerhebung sorgfältig geplant und durchgeführt wird, um genaue und zuverlässige Ergebnisse zu erhalten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.