Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Cycplus-R200-cycplus-R200
Top-Angebote
Produkte zum Begriff Cycplus-R200-cycplus-R200:
-
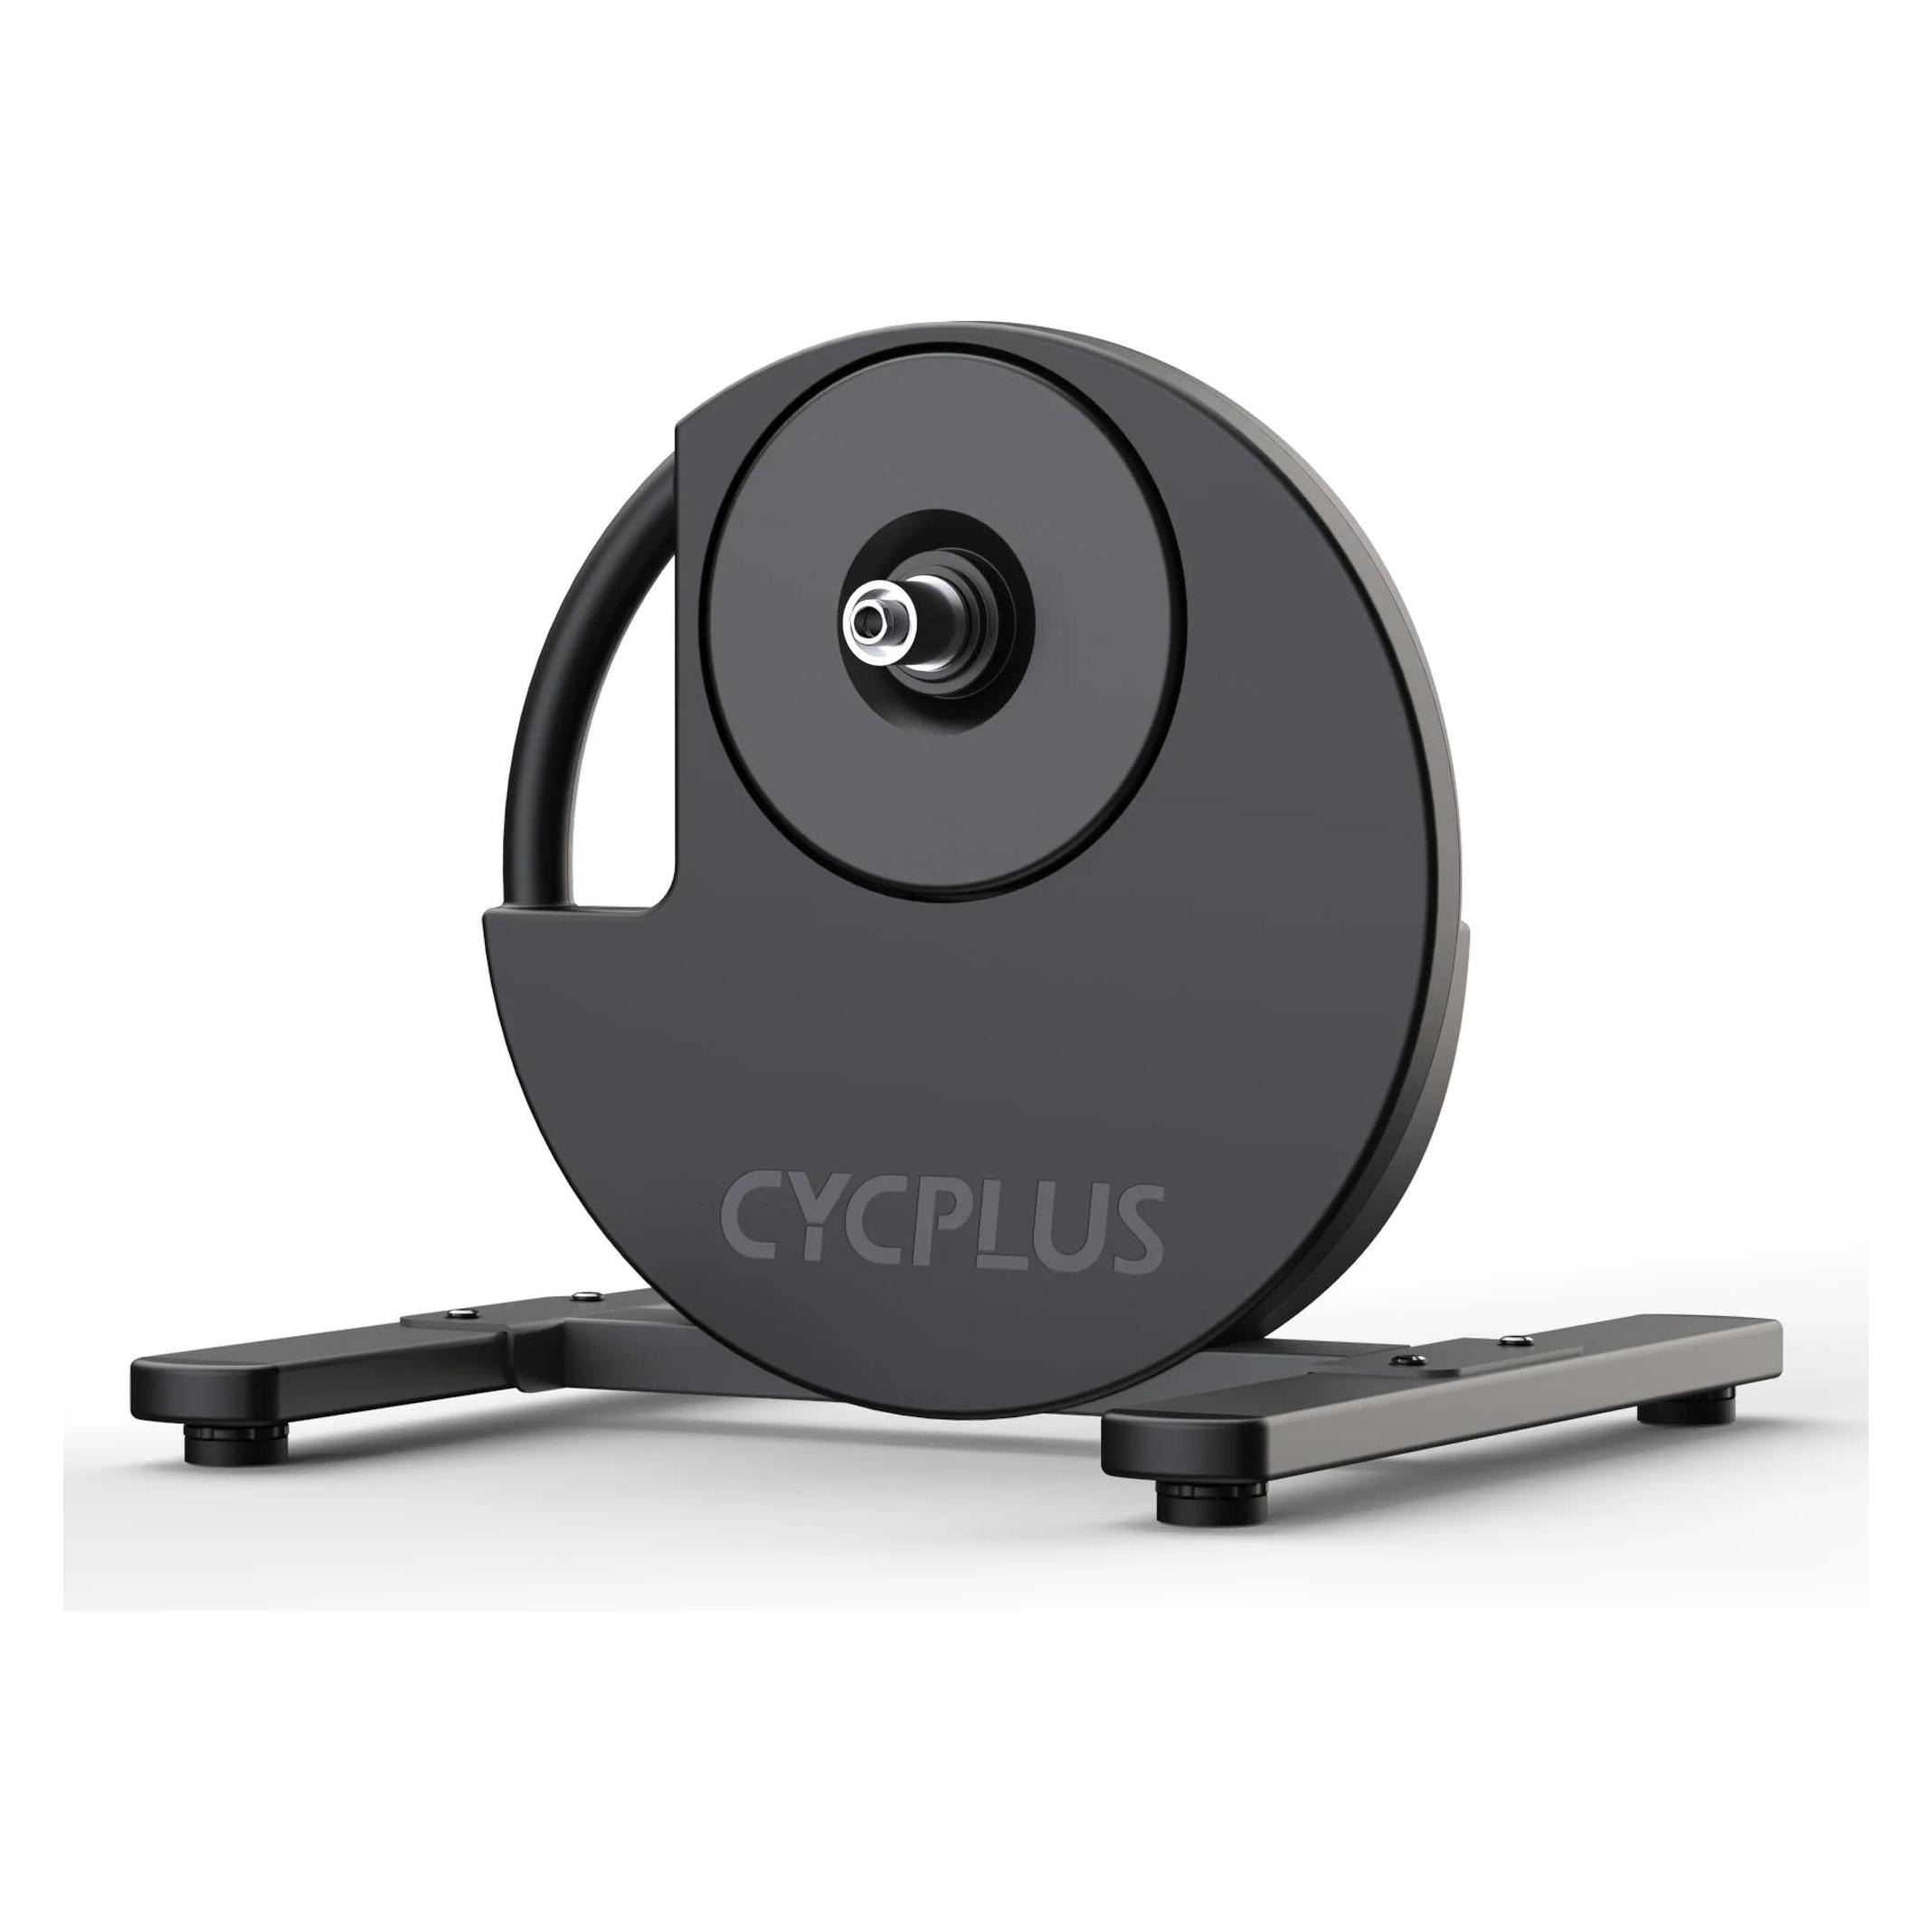
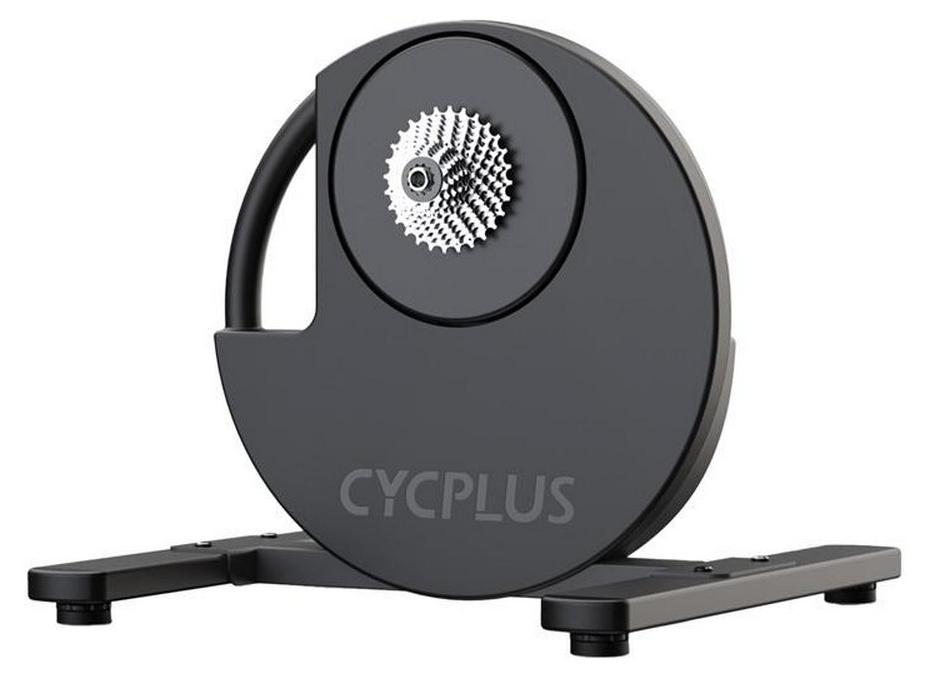
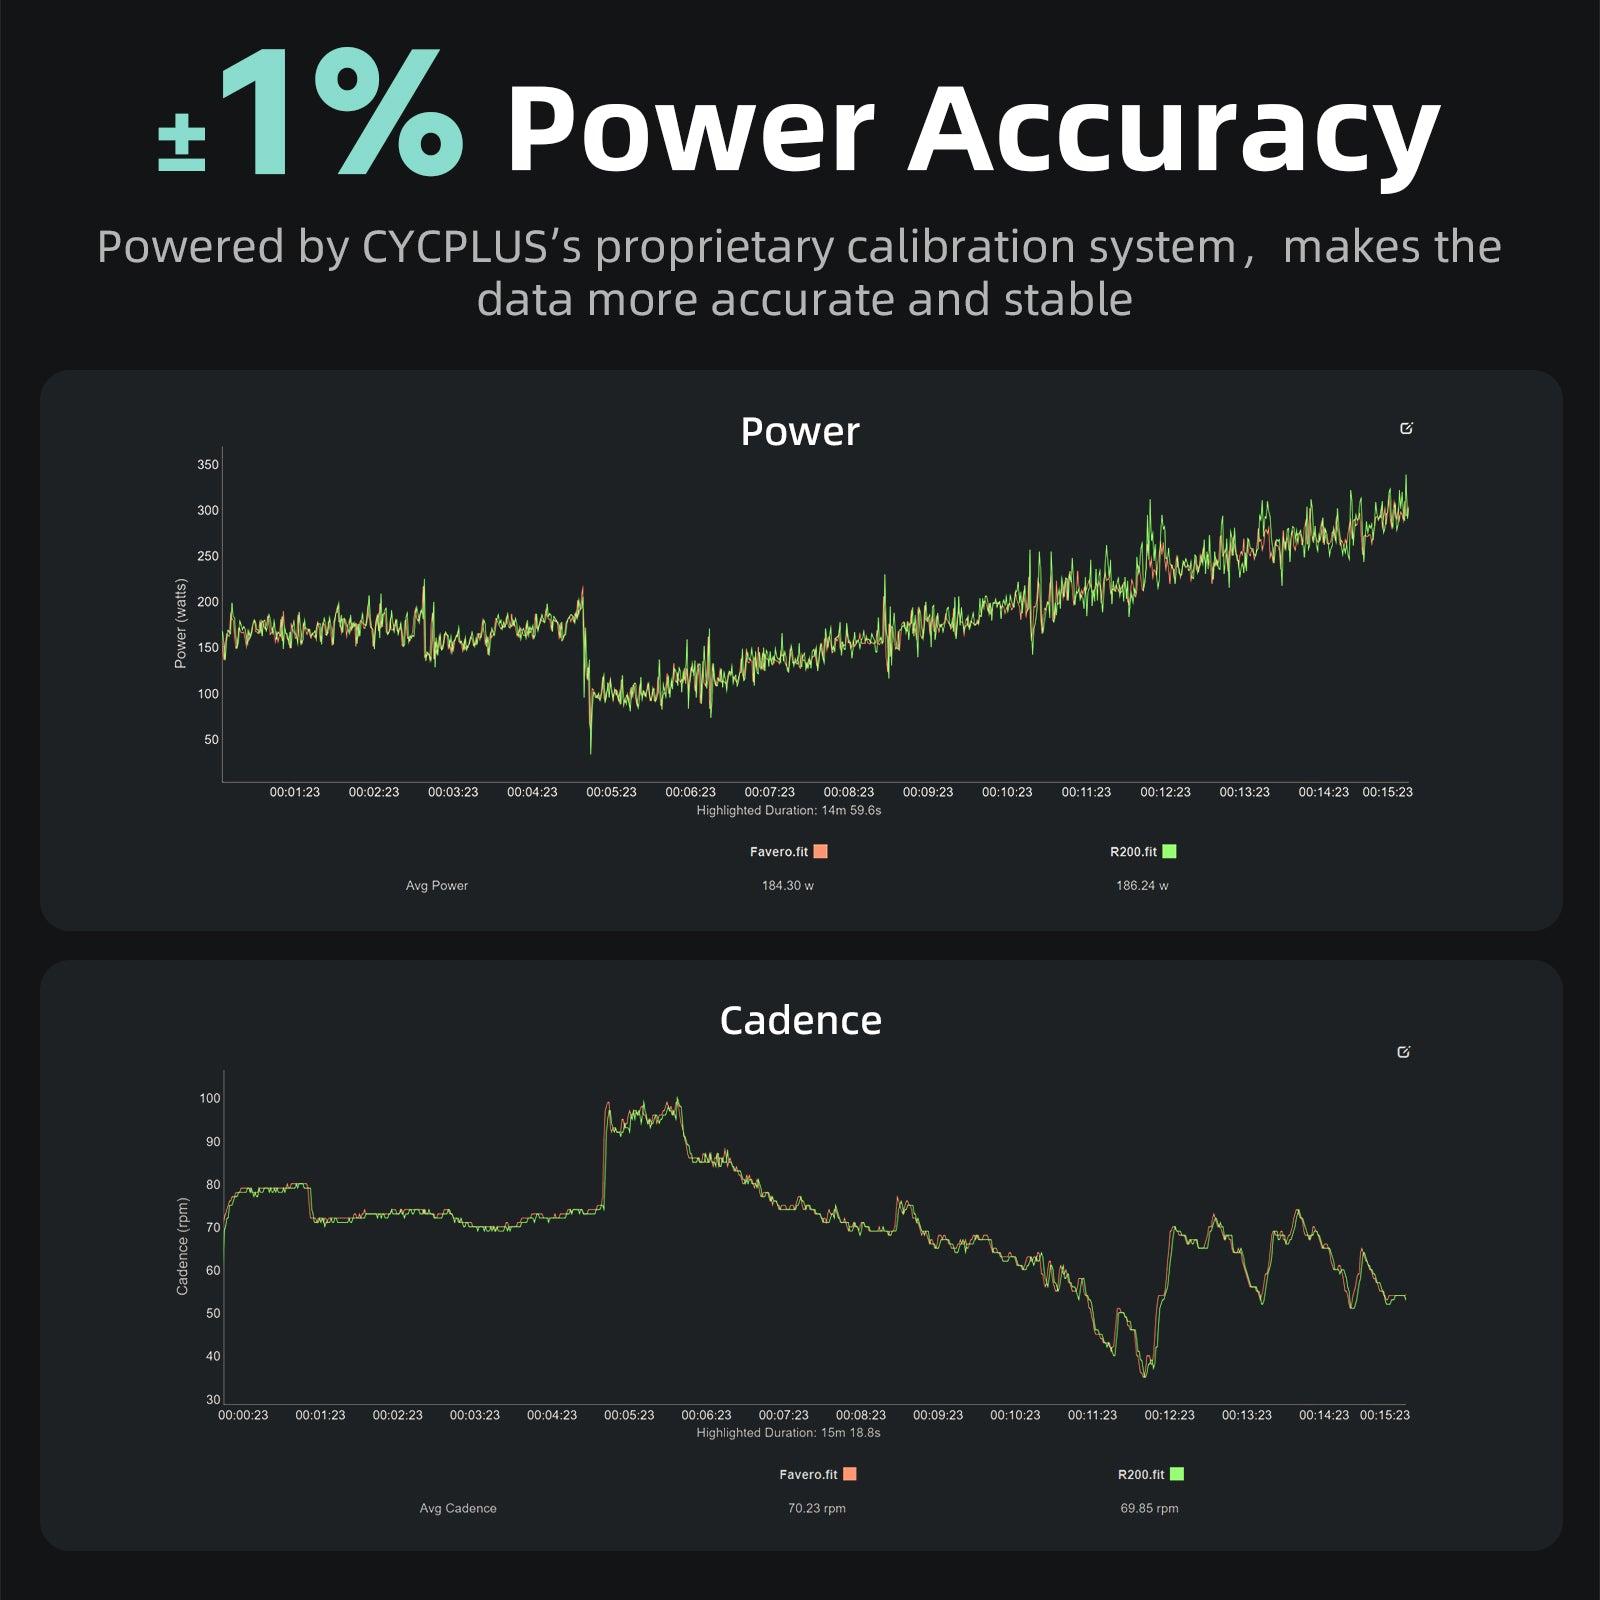
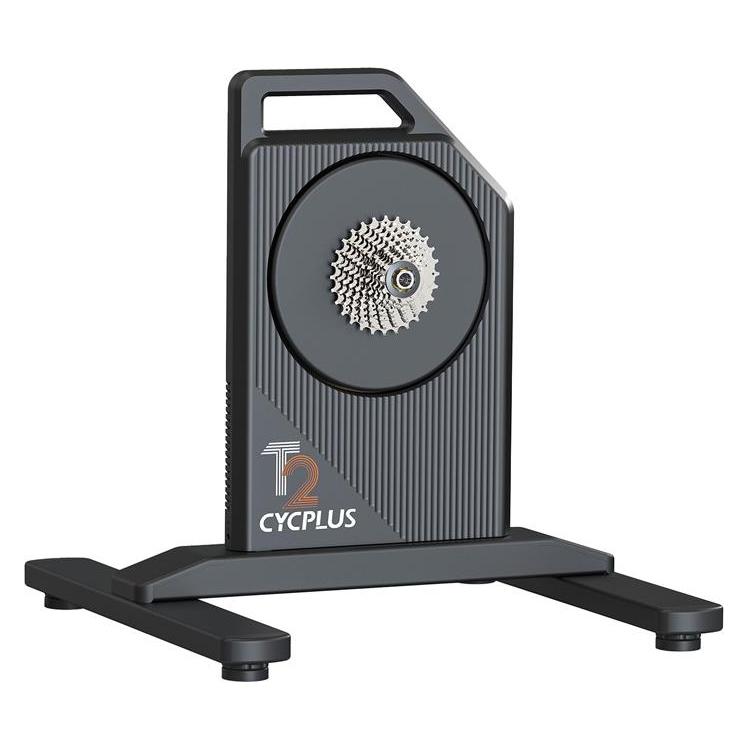
CYCPLUS R200 Smart Fahrrad Rollentrainer 2200W BLE/ANT+ Direktantrieb RollerCYCPLUS R200 Smart Fahrrad Rollentrainer 2200W BLE/ANT+ Direktantrieb RollerDirektantrieb Smart Trainer für realistisches Indoor-Cycling.- Bis 2200 W Spitzenleistung, max. 80 Nm Drehmoment- Leistungsgenauigkeit ±1 %- Steigungssimulation bis 19 %- BLE 5.0 und ANT+ (Zwift, MyWhoosh, TrainerRoad, Rouvy, Kinomap, FulGaz u. a.)- Selbstversorgender Betrieb ohne Steckdose möglich; Bergabfahrtssimulation mit Netzteil- Virtuelles Schalten (optional mit CYCPLUS BC2, separat erhältlich)- Daten: Leistung, Trittfrequenz, Geschwindigkeit- Achsen: Steckachse 12×142 / 12×148 mm und Schnellspanner 5×130 / 5×135 mm- Max. Belastung 120 kg- Kompakte Stellfläche ca. 0,27 m²Hinweis: Kassette und BC2-Schalthebel sind nicht im Lieferumfang enthalten und separat erhältlich.Lieferumfang:1x CYCPLUS R200 Smart Trainer2x Standbeine inkl. Schrauben und Unterlegscheiben1x HG-Nabe (vormontiert)Steckachsen-Adapter L/R (vormontiert)Schnellspanner-Adapter L/R inkl. SchnellspannerAbstandshalter Kassette / ScheibenbremseN429,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff Cycplus-R200-cycplus-R200:
-
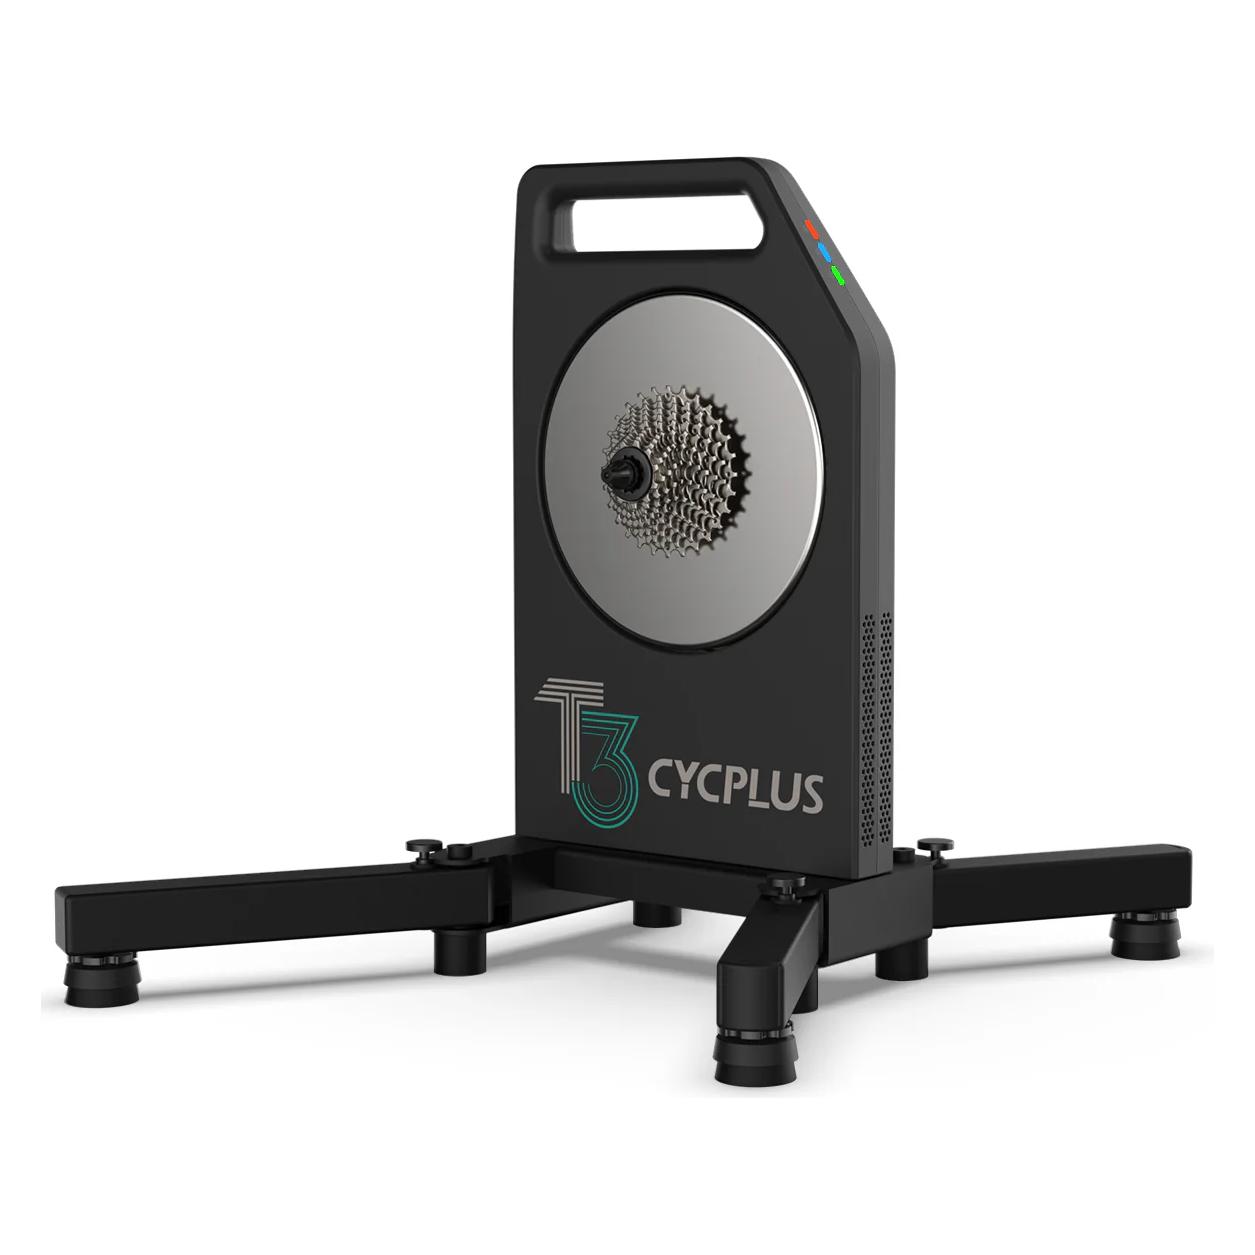
CYCPLUS - R200 - FahrradtrainerCycplus R200 FahrradtrainerCycplus R200 ist ein intelligenter Fahrradtrainer mit Direktantrieb, der für effektives und realistisches Training zu Hause entwickelt wurde. Es bietet eine maximale Leistung von 2.200 Watt, ein Drehmoment von 80 Nm und eine Steigungssimulation von bis zu 19 %, um steile Anstiege originalgetreu nachzubilden.Natürliches Fahrgefühl mit PMSM-MotorDas Herzstück des R200 ist ein maßgeschneiderter PMSM-Motor, der 52 Neodym-Magnete und 48 Elektromagnete verwendet. Diese Kombination ermöglicht eine sanfte und präzise Widerstandskontrolle und minimiert tote Zonen und unnatürliche Leistungsspitzen. Optimierte Motoralgorithmen sorgen für ein realistisches Fahrerlebnis, das dem einer echten Straße ähnelt, sowohl bei gemütlichen Fahrten als auch bei dynamischen Sprints.Training ohne Steckdose - volle Freiheit beim FahrenDer Cycplus R200 kann seine eigene Stromversorgung erzeugen, so dass er bei normaler Nutzung keinen dauerhaften Stromanschluss benötigt. Dadurch können Si571,78 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
CYCPLUS R200 Smart Fahrrad Rollentrainer 2200W BLE/ANT+ Direktantrieb RollerCYCPLUS R200 Smart Fahrrad Rollentrainer 2200W BLE/ANT+ Direktantrieb RollerDirektantrieb Smart Trainer für realistisches Indoor-Cycling.- Bis 2200 W Spitzenleistung, max. 80 Nm Drehmoment- Leistungsgenauigkeit ±1 %- Steigungssimulation bis 19 %- BLE 5.0 und ANT+ (Zwift, MyWhoosh, TrainerRoad, Rouvy, Kinomap, FulGaz u. a.)- Selbstversorgender Betrieb ohne Steckdose möglich; Bergabfahrtssimulation mit Netzteil- Virtuelles Schalten (optional mit CYCPLUS BC2, separat erhältlich)- Daten: Leistung, Trittfrequenz, Geschwindigkeit- Achsen: Steckachse 12×142 / 12×148 mm und Schnellspanner 5×130 / 5×135 mm- Max. Belastung 120 kg- Kompakte Stellfläche ca. 0,27 m²Hinweis: Kassette und BC2-Schalthebel sind nicht im Lieferumfang enthalten und separat erhältlich.Lieferumfang:1x CYCPLUS R200 Smart Trainer2x Standbeine inkl. Schrauben und Unterlegscheiben1x HG-Nabe (vormontiert)Steckachsen-Adapter L/R (vormontiert)Schnellspanner-Adapter L/R inkl. SchnellspannerAbstandshalter Kassette / ScheibenbremseN429,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Cycplus-R200-cycplus-R200
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.