Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **


Ähnliche Suchbegriffe für Ziele
Top-Angebote
Produkte zum Begriff Ziele:
-
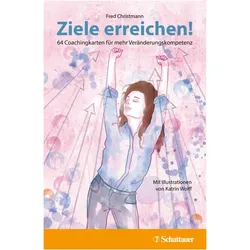
Ziele erreichen!, Fachbücher von Fred ChristmannEigene Vorhaben erfolgreich umsetzen - so gelingt es! Selbstcoaching: Unterstützt Jugendliche und Erwachsene mit unterschiedlichen Zielen auf ihrem Weg. Beratung und Therapie: Hilft Beraterinnen und Beratern sowie Therapeutinnen und Therapeuten, noch erfolgreicher zu werden bei der Förderung ihrer Ratsuchenden. Mit psychologischem Know-how, das sich wirklich anwenden lässt, können Sie im Leben viel mehr erreichen. Sie benötigen Impulse für die Bearbeitung Ihres Problems oder konkrete Anregungen für die Planung eines Veränderungsprojekts? Karte für Karte lernen Sie, wie eine gesunde Selbstveränderung in die Richtung, die Sie sich wünschen, möglich ist. Dr. Fred Christmann beschreibt ein grosses Spektrum höchst bewährter psychologischer Methoden wie z.B. subjektive Skalierungen, Übungen zur Selbstreflexion, Imaginationen, mentales Training, Selbstakzeptanz, emotionales Ausbalancieren, kognitives Neubewerten, soziale Proben, das Nutzen von Metaphern und vieles mehr. Die Illustrationen regen innere psychische Prozesse an und sorgen dafür, dass Sie das Gelernte auf einer tieferen Ebene für sich behalten und anwenden können. So gelangen Sie Schritt für Schritt an Ihr Ziel und gestalten Ihr Leben nach Ihren eigenen Vorstellungen. Dieses Kartenset richtet sich an: Jugendliche und Erwachsene, die etwas verändern möchten, Coaches, Beraterinnen und Berater sowie Psychotherapeutinnen und Psychotherapeuten, die für Coachingmethoden offen sind.30,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **

Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff Ziele:
-
Ziele erreichen!, Fachbücher von Fred ChristmannEigene Vorhaben erfolgreich umsetzen - so gelingt es! Selbstcoaching: Unterstützt Jugendliche und Erwachsene mit unterschiedlichen Zielen auf ihrem Weg. Beratung und Therapie: Hilft Beraterinnen und Beratern sowie Therapeutinnen und Therapeuten, noch erfolgreicher zu werden bei der Förderung ihrer Ratsuchenden. Mit psychologischem Know-how, das sich wirklich anwenden lässt, können Sie im Leben viel mehr erreichen. Sie benötigen Impulse für die Bearbeitung Ihres Problems oder konkrete Anregungen für die Planung eines Veränderungsprojekts? Karte für Karte lernen Sie, wie eine gesunde Selbstveränderung in die Richtung, die Sie sich wünschen, möglich ist. Dr. Fred Christmann beschreibt ein grosses Spektrum höchst bewährter psychologischer Methoden wie z.B. subjektive Skalierungen, Übungen zur Selbstreflexion, Imaginationen, mentales Training, Selbstakzeptanz, emotionales Ausbalancieren, kognitives Neubewerten, soziale Proben, das Nutzen von Metaphern und vieles mehr. Die Illustrationen regen innere psychische Prozesse an und sorgen dafür, dass Sie das Gelernte auf einer tieferen Ebene für sich behalten und anwenden können. So gelangen Sie Schritt für Schritt an Ihr Ziel und gestalten Ihr Leben nach Ihren eigenen Vorstellungen. Dieses Kartenset richtet sich an: Jugendliche und Erwachsene, die etwas verändern möchten, Coaches, Beraterinnen und Berater sowie Psychotherapeutinnen und Psychotherapeuten, die für Coachingmethoden offen sind.30,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Ziele
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.