Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Was sind die Herausforderungen und Chancen bei der Verarbeitung und Analyse von Big Data in Unternehmen?
Die Herausforderungen bei der Verarbeitung und Analyse von Big Data in Unternehmen sind die Bewältigung großer Datenmengen, die Sicherung der Datenintegrität und Datenschutzbedenken. Die Chancen liegen in der Möglichkeit, wertvolle Erkenntnisse aus den Daten zu gewinnen, Prozesse zu optimieren und Wettbewerbsvorteile zu erlangen. Eine effektive Nutzung von Big Data kann zu besser informierten Entscheidungen, verbessertem Kundenservice und innovativen Geschäftsmodellen führen. **
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **

Ähnliche Suchbegriffe für Verarbeitung
Top-Angebote
Produkte zum Begriff Verarbeitung:
-
Direct Verarbeitung Anti Vandal MatratzeDirect Verarbeitung Anti Vandal Matratze. Heavy Duty anti-vandal, Wasserdicht und leicht zu reinigende für Hygiene Ideal für anspruchsvolle Umgebungen wie es ist versiegelt, keine Öffnung. Größe – Single Matratze, 190,5 x 88,9 x 17,8 cm – 190 cm x 90 cm x 18 cm Farbe:Blau379,52 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Grundkurs Machine Learning, Fachbücher von Paul WilmottMaschinelles Lernen – alle Grundlagen! Paul Wilmott ist für seine erhellende und unterhaltsame Darstellung angewandter Mathematik bekannt. Von der linearen Regression bis zu neuronalen Netzwerken führt er Sie durch alle Verfahren, und zwar komplett software-unabhängig. Der Vorteil dabei: Jeder Schritt ist schwarz auf weiss zu sehen, kein Framework kann etwas „verstecken“, es geht immer um die Sache selbst. Mit vielen Beispielen, Grafiken und Schritt-für-Schritt-Kästen. Für alle, die wirklich verstehen wollen, wie Maschinen lernen. Aus dem Inhalt: lineare Regression, k-nearest neighbors, naive Bayes-Klassifikatoren, k-Means-Algorithmus, Support Vector Machines, logistische Regression, selbstorganisierende Karten, Entscheidungsbäume, Reinforcement Learning, neuronale Netze.29,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Kochbuch, Fachbücher von Chris AlbonPython-Programmierer finden in diesem Kochbuch nahezu 200 wertvolle und jeweils in sich abgeschlossene Anleitungen zu Aufgabenstellungen aus dem Bereich des Machine Learning, wie sie für die tägliche Arbeit typisch sind – von der Vorverarbeitung der Daten bis zum Deep Learning. Entwickler, die mit Python und seinen Bibliotheken einschliesslich Pandas und Scikit-Learn vertraut sind, werden spezifische Probleme erfolgreich bewältigen – wie etwa Daten laden, Text und numerische Daten behandeln, Modelle auswählen, Dimensionalität reduzieren und vieles mehr. Jedes Rezept enthält Code, den Sie kopieren, zum Testen in eine kleine Beispieldatenmenge einfügen und dann anpassen können, um Ihre eigenen Anwendungen zu konstruieren. Darüber hinaus werden alle Lösungen diskutiert und wichtige Zusammenhänge hergestellt. Dieses Kochbuch unterstützt Sie dabei, den Schritt von der Theorie und den Konzepten hinein in die Praxis zu machen. Es liefert das praktische Rüstzeug, das Sie benötigen, um funktionierende Machine-Learning-Anwendungen zu entwickeln. In diesem Kochbuch finden Sie Rezepte für: - Vektoren, Matrizen und Arrays - den Umgang mit numerischen und kategorischen Daten, Texten, Bildern sowie Datum und Uhrzeit - das Reduzieren der Dimensionalität durch Merkmalsextraktion oder Merkmalsauswahl - Modellbewertung und -auswahl - lineare und logistische Regression, Bäume und Wälder und k-nächste Nachbarn - Support Vector Machine (SVM), naive Bayes, Clustering und neuronale Netze - das Speichern und Laden von trainierten Modellen Chris hat den Kochbuchcharakter seines Buchs genutzt, um nicht nur eine Referenz für erfahrene Profis zu bieten, sondern auch eine leicht zugängliche Reihe von kleinen Tutorials, die Anfänger schätzen werden. Dieses Buch ist eine wertvolle Ressource, egal ob man sein Wissen vor einem Vorstellungsgespräch als Data Scientist auffrischen möchte oder eine prägnante und dennoch gründliche Referenz für den Schreibtisch sucht.36,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Fundamentals, Fachbücher von Hui JiangDiese klare und kohärente Einführung in das überwachte maschinelle Lernen präsentiert die Kernkonzepte auf eine prägnante, logische und leicht verständliche Weise für Leser mit grundlegenden mathematischen Kenntnissen, aber ohne vorherige Erfahrung im maschinellen Lernen. Die Themen umfassen sowohl weit verbreitete traditionelle Methoden als auch die kürzlich populären Methoden des tiefen Lernens.72,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **

Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Wie beeinflusst die Nutzung von Big Data die Geschäftsstrategien von Unternehmen? Welche Chancen und Risiken bringt die Verarbeitung großer Datenmengen mit sich?
Die Nutzung von Big Data ermöglicht Unternehmen, fundierte Entscheidungen auf Basis von Datenanalysen zu treffen und ihre Geschäftsstrategien zu optimieren. Chancen sind unter anderem die Identifizierung neuer Markttrends, die Personalisierung von Angeboten und die Steigerung der Effizienz. Risiken können Datenschutzverletzungen, ungenaue Analysen aufgrund fehlerhafter Daten oder eine Abhängigkeit von Technologien sein. **
Top-Angebote
Produkte zum Begriff Verarbeitung:
-
Direct Verarbeitung Anti Vandal MatratzeDirect Verarbeitung Anti Vandal Matratze. Heavy Duty anti-vandal, Wasserdicht und leicht zu reinigende für Hygiene Ideal für anspruchsvolle Umgebungen wie es ist versiegelt, keine Öffnung. Größe – Single Matratze, 190,5 x 88,9 x 17,8 cm – 190 cm x 90 cm x 18 cm Farbe:Blau379,52 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Grundkurs Machine Learning, Fachbücher von Paul WilmottMaschinelles Lernen – alle Grundlagen! Paul Wilmott ist für seine erhellende und unterhaltsame Darstellung angewandter Mathematik bekannt. Von der linearen Regression bis zu neuronalen Netzwerken führt er Sie durch alle Verfahren, und zwar komplett software-unabhängig. Der Vorteil dabei: Jeder Schritt ist schwarz auf weiss zu sehen, kein Framework kann etwas „verstecken“, es geht immer um die Sache selbst. Mit vielen Beispielen, Grafiken und Schritt-für-Schritt-Kästen. Für alle, die wirklich verstehen wollen, wie Maschinen lernen. Aus dem Inhalt: lineare Regression, k-nearest neighbors, naive Bayes-Klassifikatoren, k-Means-Algorithmus, Support Vector Machines, logistische Regression, selbstorganisierende Karten, Entscheidungsbäume, Reinforcement Learning, neuronale Netze.29,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die Herausforderungen und Chancen bei der Verarbeitung und Analyse von Big Data in Unternehmen?
Die Herausforderungen bei der Verarbeitung und Analyse von Big Data in Unternehmen sind die Bewältigung großer Datenmengen, die Sicherung der Datenintegrität und Datenschutzbedenken. Die Chancen liegen in der Möglichkeit, wertvolle Erkenntnisse aus den Daten zu gewinnen, Prozesse zu optimieren und Wettbewerbsvorteile zu erlangen. Eine effektive Nutzung von Big Data kann zu besser informierten Entscheidungen, verbessertem Kundenservice und innovativen Geschäftsmodellen führen. **
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
Ähnliche Suchbegriffe für Verarbeitung
-
Machine Learning Kochbuch, Fachbücher von Chris AlbonPython-Programmierer finden in diesem Kochbuch nahezu 200 wertvolle und jeweils in sich abgeschlossene Anleitungen zu Aufgabenstellungen aus dem Bereich des Machine Learning, wie sie für die tägliche Arbeit typisch sind – von der Vorverarbeitung der Daten bis zum Deep Learning. Entwickler, die mit Python und seinen Bibliotheken einschliesslich Pandas und Scikit-Learn vertraut sind, werden spezifische Probleme erfolgreich bewältigen – wie etwa Daten laden, Text und numerische Daten behandeln, Modelle auswählen, Dimensionalität reduzieren und vieles mehr. Jedes Rezept enthält Code, den Sie kopieren, zum Testen in eine kleine Beispieldatenmenge einfügen und dann anpassen können, um Ihre eigenen Anwendungen zu konstruieren. Darüber hinaus werden alle Lösungen diskutiert und wichtige Zusammenhänge hergestellt. Dieses Kochbuch unterstützt Sie dabei, den Schritt von der Theorie und den Konzepten hinein in die Praxis zu machen. Es liefert das praktische Rüstzeug, das Sie benötigen, um funktionierende Machine-Learning-Anwendungen zu entwickeln. In diesem Kochbuch finden Sie Rezepte für: - Vektoren, Matrizen und Arrays - den Umgang mit numerischen und kategorischen Daten, Texten, Bildern sowie Datum und Uhrzeit - das Reduzieren der Dimensionalität durch Merkmalsextraktion oder Merkmalsauswahl - Modellbewertung und -auswahl - lineare und logistische Regression, Bäume und Wälder und k-nächste Nachbarn - Support Vector Machine (SVM), naive Bayes, Clustering und neuronale Netze - das Speichern und Laden von trainierten Modellen Chris hat den Kochbuchcharakter seines Buchs genutzt, um nicht nur eine Referenz für erfahrene Profis zu bieten, sondern auch eine leicht zugängliche Reihe von kleinen Tutorials, die Anfänger schätzen werden. Dieses Buch ist eine wertvolle Ressource, egal ob man sein Wissen vor einem Vorstellungsgespräch als Data Scientist auffrischen möchte oder eine prägnante und dennoch gründliche Referenz für den Schreibtisch sucht.36,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Fundamentals, Fachbücher von Hui JiangDiese klare und kohärente Einführung in das überwachte maschinelle Lernen präsentiert die Kernkonzepte auf eine prägnante, logische und leicht verständliche Weise für Leser mit grundlegenden mathematischen Kenntnissen, aber ohne vorherige Erfahrung im maschinellen Lernen. Die Themen umfassen sowohl weit verbreitete traditionelle Methoden als auch die kürzlich populären Methoden des tiefen Lernens.72,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
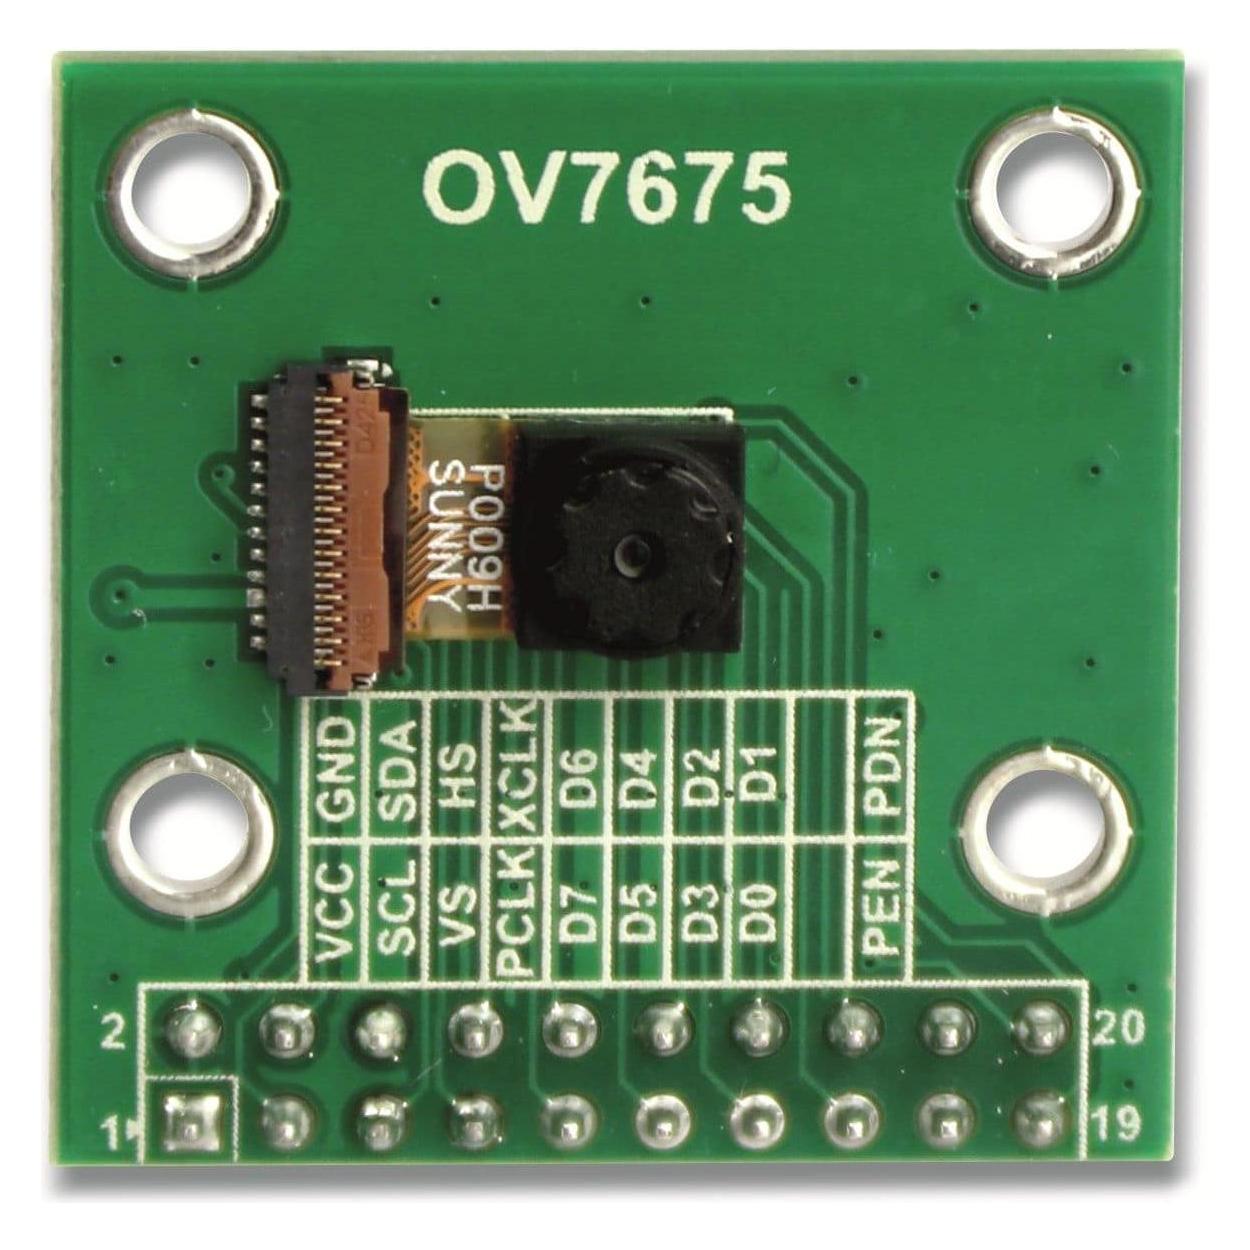
Arduino Tiny Machine Learning Kit, Entwicklungsboard + KitThe Tiny Machine Learning Kit, combined with the exciting TinyML applications and the delivery of TinyML on microcontroller courses that are part of EDX's TinyML Learning (TinyML Learning) specialization, gives you all the tools you need to bring your ML vision to life!. The kit consists of a powerful board with a microcontroller and a variety of sensors (Arduino Nano 33 BLE Sense). The board can move, accelerate, rotate, temperature, humidity, Record air pressure, noise, gestures, proximity, color, and light intensity. The kit also includes a camera module (OV7675) and a custom Arduino protective shield that makes it easy to install your components and create your own unique TinyML project. You can investigate practical ML use cases with classical algorithms as well as deep neural networks operated with TensorFlow Lite Micro. This text is machine translated.64,94 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning für Zeitreihen, Fachbücher von Jochen Hirschle- Konzepte Schritt für Schritt erklärt - Die Eigenarten von Zeitreihendaten verstehen: Zeitfenster zum Anlernen einsetzen; mit latenten, saisonalen und Trend-Komponenten arbeiten - Anleitungen zur Umsetzung in Python mit ausführlichen Code-Kommentaren - Mit TensorFlow 2 Deep-Learning-Verfahren zur Prognose aufbauen, anlernen und produktiv einsetzen Daten über Vorgänge werden in der verarbeitenden Industrie, der Logistik oder im Finanzsektor im Sekundentakt aufgezeichnet: der Verlauf eines Aktienkurses, die Verkaufszahlen eines Produkts, die Sensordaten einer Turbine. Solche Daten informieren nicht nur über isolierte Zustände; sie sind wie Filme, die den Verlauf eines Vorgangs mit einer Serie einzelner Bilder nachzeichnen. Intelligente Algorithmen können die Muster dieser Verläufe analysieren, sie anlernen und über das Beobachtungsfenster hinaus fortschreiben: Zustände in der Zukunft werden prognostizierbar. Das Buch bietet eine leicht verständliche Einführung in die Konzepte und die Praxis der Zeitreihenanalyse. Es zeigt, wie bewährte und neuere Lernalgorithmen arbeiten und wie sie sich mit Python anlernen und produktiv einsetzen lassen. An einer Vielzahl von Anwendungsbeispielen werden die Vorbereitung der Daten, der Anlern- und Schätzprozess Schritt für Schritt erklärt. Aus dem Inhalt: - Zeitreihendaten mit pandas aufbereiten, fehlende Daten imputieren, mit Datumsangaben arbeiten - Grundprinzipien maschinellen Lernens: Konzepte und Umsetzung mit Python und Scikit-Learn - Feature-Preprocessing: Standardisierung, Dimensionsreduktion, Verarbeitung kategorialer Daten - ARIMA-Modelle zur Analyse univariater Zeitreihen: Vorbereitung, Anlernen und Prognose mit Python und Statsmodels - Komplexe Zeitreihen mit Deep-Learning-Verfahren analysieren: Rekurrente und konvolutionale Netze verstehen und mit Python und TensorFlow 2 aufbauen und anlernen - Mit Zeitfenstern arbeiten Vorkenntnisse in Machine-Learning-Verfahren sind nicht notwendig. Grundlegende Statistik- und.39,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Wie beeinflusst die Nutzung von Big Data die Geschäftsstrategien von Unternehmen? Welche Chancen und Risiken bringt die Verarbeitung großer Datenmengen mit sich?
Die Nutzung von Big Data ermöglicht Unternehmen, fundierte Entscheidungen auf Basis von Datenanalysen zu treffen und ihre Geschäftsstrategien zu optimieren. Chancen sind unter anderem die Identifizierung neuer Markttrends, die Personalisierung von Angeboten und die Steigerung der Effizienz. Risiken können Datenschutzverletzungen, ungenaue Analysen aufgrund fehlerhafter Daten oder eine Abhängigkeit von Technologien sein. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.