Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **

Ähnliche Suchbegriffe für Status
Top-Angebote
Produkte zum Begriff Status:
-
STATUS URBANO 6600208Vakuumiergerät - für Lebensmittel, Folienschweissgerät, automatisch, Schweißnahtstärke: 2,5 mm, Schweißnahtbreite: 30 cm, Leistung: 125 W, Saugdruck: 0,6 bar, Saugleistung: 10 l/m, Lärmpegel: 63 dB, Mögliche externe Luftabsaugung, Thermosicherung und Sous-Vide geeignet, 5 Folien in der Packung, Auffangschale, Beutel in der Packung, Abmessungen: 7 × 39,1 × 11,4 cm (H×B×T), Gewicht: 1,3 kg Vakuumiergerät STATUS URBANO 6600208 Das elegante und platzsparende Folienschweißgerät Status Urbano ist wie geschaffen für den täglichen Gebrauch in modernen und kleineren städtischen Küchen. Ein zuv60,59 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter

-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff Status:
-
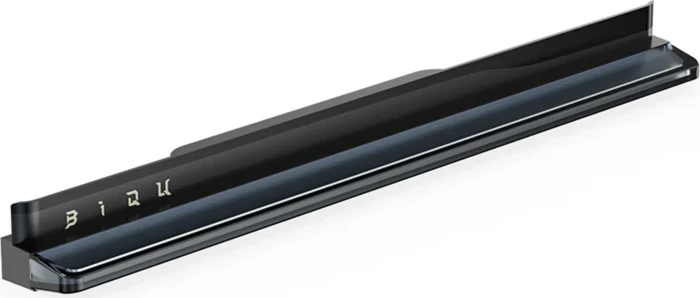
BIQU Status3D-Drucker-Zubehör - intelligente visuelle Erweiterung für 3D-Drucker Bambu Lab X1, P1 und A1, farbige Anzeige des Druckfortschritts und von Fehlern, Beleuchtung mit Rhythm-Light-Sync-Funktion reagierend auf Ton, vollständig einstellbar über Webschnittstelle, hitzebeständige Abdeckung gewährleistet sicheren Betrieb am Heizbett, Stromversorgung über USB-C, Packung enthält Panda Status, Controller, USB-C Netzkabel, Verbindungskabel 1 m, Acetat-Klebeband, doppelseitiges 3M-Klebeband, Reinigungstuch, Alkoholtücher Das BIQU Panda Status ist ein intelligentes RGB-Statusmodul für Bambu Lab 3D-Drucker, mit dem Sie den Druckstatus jederzeit im Blick behalten können, ohne die App öffnen zu müssen. Über Wi-Fi zeigt es25,39 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Specialized Lagerschraubenset Hinterbau Status 2 MY24 (Status 140 / 170)Specialized Lagerschraubenset Hinterbau Status 2 MY24 (Status 140 / 170)Komplettes Schraubenset für die Hinterbau-Lagerpunkte des Status 140 2 und Status 170 2 aus dem Modelljahr 2024, inklusive aller Lager-Spacer.MerkmaleHauptlagerachse: M15 x 1,0 x 83 mm, 1 Stück, mit Scheibe 15,15 x 21 x 0,5 mmHorst-Link-Schrauben: M6 x 1,0 x 32,5 mm, 2 StückUmlenkhebel-Schrauben: M12 x 1,0 x 17 mm / 14 mm / 27 mm, je 2 StückDämpferschrauben: vorne M8 x 1,0 x 20 mm, hinten M8 x 1,25 x 26 mm mit ScheibeLieferumfang: inkl. aller Lager-Spacer, Details im Status-2-HandbuchProduktdatenPassend für laut Specialized: Status 140 2 MY24, Status 170 2 MY24Hersteller-Artikelnummer: S220500019Häufige FragenWofür ist das Teil gedacht? Laut Specialized für Status 140 2 MY24, Status 170 2 MY24.Du bist unsicher, ob das Teil passt? Ruf uns an unter 07171 929 556. Nenne uns Modell und Modelljahr deines Bikes, dann prüfen wir das für dich.Weitere Teile findest du unter Specialized Ersatzteile und in der Specialized-Markenwelt. Den Einbau übernimmt auf Wunsch unsere Werkstatt in Schwäbisch Gmünd.75,00 €*Versand: 7,99 €Sichere Weiterleitung zum Anbieter
-
STATUS URBANO 6600208Vakuumiergerät - für Lebensmittel, Folienschweissgerät, automatisch, Schweißnahtstärke: 2,5 mm, Schweißnahtbreite: 30 cm, Leistung: 125 W, Saugdruck: 0,6 bar, Saugleistung: 10 l/m, Lärmpegel: 63 dB, Mögliche externe Luftabsaugung, Thermosicherung und Sous-Vide geeignet, 5 Folien in der Packung, Auffangschale, Beutel in der Packung, Abmessungen: 7 × 39,1 × 11,4 cm (H×B×T), Gewicht: 1,3 kg Vakuumiergerät STATUS URBANO 6600208 Das elegante und platzsparende Folienschweißgerät Status Urbano ist wie geschaffen für den täglichen Gebrauch in modernen und kleineren städtischen Küchen. Ein zuv60,59 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Status
-
STATUS BVP300 Gastro-VakuumpumpePumpe - für den professionellen Einsatz, Fördermenge 22 l/min, Material ABS-Kunststoff, drahtloser Betrieb, leistungsstarker Lithium-Ionen-Akku, hergestellt in Slowenien Die Gastro-Vakuumpumpe Status BVP300 ist für den professionellen Einsatz konzipiert und eignet sich für das schnelle und zuverlässige Vakuumieren von sperrigen Gastro-Behältern. Sie eignet sich für Re132,90 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
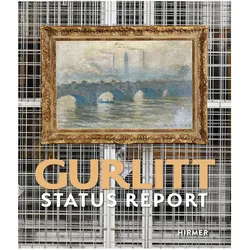
Gurlitt: Status Report.Engl., FachbücherDas Buch "Gurlitt: Status Report" bietet eine umfassende Dokumentation über die bemerkenswerte Sammlung von über 1000 Kunstwerken, die 2012 entdeckt wurden und von bedeutenden Künstlern wie Otto Dix, Franz Marc und Wassily Kandinsky stammen. Es beleuchtet die komplexe Geschichte des Kunstfundes Gurlitt, der im Kontext von NS-Raubkunst steht. Die Autorenschaft setzt sich intensiv mit den Provenienzen der Werke auseinander und thematisiert die Biografien jüdischer Sammler und Künstler, die unter dem NS-Regime litten. Durch die Analyse der Sammlung wird ein differenziertes Verständnis für die rechtlichen und moralischen Fragen rund um die Kunstwerke geschaffen. Dieses Fachbuch ist nicht nur ein Katalog der Ausstellung, sondern auch ein wichtiger Beitrag zur Aufklärung über die dunkle Geschichte des Kunstraubs und die Rückführung geraubter Werke nach 1945.27,50 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.