Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **

Ähnliche Suchbegriffe für Stakeholder-Zufriedenheit
Top-Angebote
Produkte zum Begriff Stakeholder-Zufriedenheit:
-
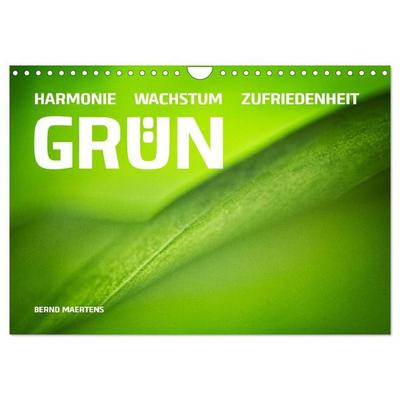
GRÜN Harmonie Wachstum Zufriedenheit (Wandkalender 2027 DIN A4 quer), CALVENDO MonatskalenderDie Farbe Grün Ist Die Farbe Der Lebendigen Natur. Grün Symbolisiert Hoffnung, Lebendigkeit, Frische, Die Jugend, Die Natürlichkeit. Grün Wirkt Beruhigend, Entspannend Und Harmonisierend. Ein Spaziergang Im Grünen Wald Bringt Entspannung Und...21,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Entdeckend: Natur - Energie - Zufriedenheit (Wandkalender 2027 DIN A3 quer), CALVENDO MonatskalenderMeine Kalender Umsetzung Entsprang Einer Alljährlichen Gegebenheit: Weihnachtsgeschenke Für Meine Lieben, Nahen Verwandten Und Bekannten, Sowie Auserwählten Geschäftspartnern. Mein Jahreskalender Soll Die Menschen - Immer Wieder - Zum Innehalten In...31,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind Stakeholder?
Stakeholder sind Personen oder Gruppen, die von den Handlungen und Entscheidungen eines Unternehmens oder einer Organisation betroffen sind oder Einfluss darauf haben. Sie können Kunden, Mitarbeiter, Lieferanten, Investoren, Regierungen, NGOs und die Gesellschaft im Allgemeinen umfassen. Die Einbeziehung und Berücksichtigung der Interessen und Bedürfnisse der Stakeholder ist wichtig für eine nachhaltige und verantwortungsvolle Unternehmensführung. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **


Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Top-Angebote
Produkte zum Begriff Stakeholder-Zufriedenheit:
-
Gesundheitsforschung kommunizieren, Stakeholder Engagement gestalten, FachbücherAngesichts einer gesellschaftlichen Entwicklung hin zu mehr Transparenz und Partizipation wird Kommunikation in der Gesundheitsforschung immer wichtiger. Vertrauen zwischen Forschungseinrichtungen und ihren Stakeholdern sowie zwischen Forschung und Gesellschaft muss immer wieder neu geschaffen werden. Dieser Sammelband gibt Anregungen, wie erfolgreiche Kommunikation in der Gesundheitsforschung gestaltet werden kann, und ist ein Nachschlagewerk, das den Lesern Hilfestellung und Tipps für die eigene Arbeit bietet. Die wichtigsten Facetten der Wissenschaftskommunikation in der Gesundheitsforschung werden vorgestellt: von der Entwicklung einer Kommunikationsstrategie über das Verhältnis von Wissenschaft und Medien, auch in Krisenzeiten, bis zur Erstellung evidenzbasierter Informationen für Patienten, von Fragen der Organisationskommunikation über das Stakeholder-Engagement bis zum Fundraising.49,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind Stakeholder?
Stakeholder sind Personen oder Gruppen, die von den Handlungen und Entscheidungen eines Unternehmens oder einer Organisation betroffen sind oder Einfluss darauf haben. Sie können Kunden, Mitarbeiter, Lieferanten, Investoren, Regierungen, NGOs und die Gesellschaft im Allgemeinen umfassen. Die Einbeziehung und Berücksichtigung der Interessen und Bedürfnisse der Stakeholder ist wichtig für eine nachhaltige und verantwortungsvolle Unternehmensführung. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
Ähnliche Suchbegriffe für Stakeholder-Zufriedenheit
-
GRÜN Harmonie Wachstum Zufriedenheit (Wandkalender 2027 DIN A4 quer), CALVENDO MonatskalenderDie Farbe Grün Ist Die Farbe Der Lebendigen Natur. Grün Symbolisiert Hoffnung, Lebendigkeit, Frische, Die Jugend, Die Natürlichkeit. Grün Wirkt Beruhigend, Entspannend Und Harmonisierend. Ein Spaziergang Im Grünen Wald Bringt Entspannung Und...21,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Entdeckend: Natur - Energie - Zufriedenheit (Wandkalender 2027 DIN A3 quer), CALVENDO MonatskalenderMeine Kalender Umsetzung Entsprang Einer Alljährlichen Gegebenheit: Weihnachtsgeschenke Für Meine Lieben, Nahen Verwandten Und Bekannten, Sowie Auserwählten Geschäftspartnern. Mein Jahreskalender Soll Die Menschen - Immer Wieder - Zum Innehalten In...31,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Joos, Klemens: Politische Stakeholder überzeugenPolitische Stakeholder überzeugen , Der Gründer einer der erfolgreichsten Interessenvertretungen in der Europäischen Union (EU), Prof. Dr. Klemens Joos, bündelt in der Neuauflage seines Standardwerks die Erfahrungen aus mehr als drei Jahrzehnten zu einer wissenschaftlichen Theorie der Governmental Relations. Im Mittelpunkt steht die Erkenntnis, dass angesichts der immer komplexeren Entscheidungsstrukturen der EU die möglichst genaue Kenntnis von Entscheidern und Entscheidungsprozessen mindestens genauso wichtig sind für den Erfolg wie die inhaltlichen Aspekte einer Interessenvertretung. In einem neuen Kapitel legt der Autor die von ihm aus der Praxis entwickelte Formel für eine wissenschaftsbasierte Interessenvertretung dar. Mit dem am 1. Dezember 2009 in Kraft getretenen Vertrag von Lissabon ist die EU de facto zu einem von Portugal bis Finnland und von Irland bis Zypern reichenden Staatsgebiet geworden. Das Europäische Parlament wurde neben dem Rat der Europäischen Union (Rat) zu einem gleichberechtigten Entscheider. Das Mitentscheidungsverfahren wurde zum Regelverfahren ("ordentliches Gesetzgebungsverfahren") erhoben. Im Rat wurde die sogenannte qualifizierte Mehrheit (55 Prozent der EU-Mitgliedstaaten, die gleichzeitig mindestens 65 Prozent der EU-Bevölkerung repräsentieren) für alle wichtigen Bereiche eingeführt. Als Resultat ist für die Akteure auf der "Bühne der Europäischen Union" - EU-Mitgliedstaaten, EU-Regionen, Unternehmen, Verbände und Organisationen - der Ausgang von Entscheidungsprozessen weitgehend unkalkulierbar geworden. Die zweite Auflage enthält ein neues Kapitel, in dem Prof. Dr. Klemens Joos die Variablen einer erfolgreichen Interessenvertretung anhand seiner wissenschaftlichen Formel noch greifbarer macht: Für eine erfolgreiche Interessenvertretung in der EU ist spätestens seit dem Vertrag von Lissabon eine dauerhafte und enge Verzahnung der Inhaltskompetenz des Betroffenen (der vier "klassischen Instrumente" der Interessenvertretung: Unternehmensrepräsentanzen, Verbände, Public-Affairs-Agenturen, Anwaltskanzleien) mit der Prozessstrukturkompetenz (das heißt, dem EU-weiten Vorhalten der erforderlichen räumlichen, personellen und organisatorischen Kapazitäten sowie der belastbaren institutions-, fraktions- und mitgliedstaatenübergreifenden Netzwerke) eines neutralen, objektiven Intermediärs die Grundvoraussetzung. Die Erfolgsaussichten lassen sich potenzieren, wenn es erstens gelingt, sich durch einen Perspektivenwechsel so für das Anliegen eines Betroffenen einzusetzen, dass die positiven Auswirkungen auf das Gemeinwohl für die Entscheidungsträger in der EU in den Vordergrund rücken (Perspektivenwechselkompetenz) und es zweitens gelingt, das Anliegen in die maßgeblichen Entscheidungsprozesse auf politischer Ebene erfolgreich einzubringen und fortlaufend zu begleiten (Prozessbegleitkompetenz). , Sonstige > Ansaug- & Kraftstoffsysteme , Auflage: 2. überarb. und ergänzte Auflage, Erscheinungsjahr: 20230906, Autoren: Joos, Klemens, Auflage: 23002, Auflage/Ausgabe: 2. überarb. und ergänzte Auflage, Seitenzahl/Blattzahl: 624, Themenüberschrift: POLITICAL SCIENCE / World / European, Keyword: Europa /Politische Theorie, Geschichtsschreibung; Europäische Union; Interessenverband; Interessenvertretung; Lobbyismus; Politik; Politik / Europa; Politikberatung; Politiker; Politikerin; Politikwissenschaft; Politische Entscheidung; Politische Institution; Politische Meinungsbildung; Politisches Engagement; Politisches System; Politisches Ziel; Prozess; Verband; Verfassung, Regierung, Staatswesen, Fachschema: Europa~Politik / Politikwissenschaft~Politikwissenschaft~Politologie~Stakeholder (ökonomisch), Warengruppe: HC/Politikwissenschaft, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 250, Breite: 177, Höhe: 50, Gewicht: 1204, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft,42,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wilmott, Paul: Grundkurs Machine LearningGrundkurs Machine Learning , Aus der Buchreihe »Informatik verstehen«. Ideal zum Selbststudium , Querlenker > Sportfederung , Erscheinungsjahr: 20200724, Produktform: Kartoniert, Titel der Reihe: Rheinwerk Computing##, Autoren: Wilmott, Paul, Seitenzahl/Blattzahl: 256, Themenüberschrift: COMPUTERS / General, Keyword: Hand-Buch Bücher lernen Studium Grundlagen Kurse Workshops Tutorials Wissen Anleitung Training Ausbildung; Robotik; Informatik verstehen; Programmierung programmieren; KI-Welt AI; Künstliche Intelligenz; Software-Entwicklung; Coder Coden; Neuronale Netze; Deep Learning; Mathematik, Fachschema: Informatik~Programmiersprachen~EDV / Theorie / Allgemeines, Fachkategorie: Informatik~Informationstechnik (IT), allgemeine Themen, Sprache: Deutsch, Warengruppe: HC/Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Länge: 228, Breite: 175, Höhe: 17, Gewicht: 480, Produktform: Klappenbroschur, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 232715029,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.