Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **

Ähnliche Suchbegriffe für Sortier-Code
Top-Angebote
Produkte zum Begriff Sortier-Code:
-
Janod Pure Sortier - und SteckspielJanod Sortier- und Steckspiel 6tlg. Eine hübsche Sortierschachtel in zarten und hochaktuellen Farbtönen mit niedlichen Tieren. Die sechs Formen, die in das Zelt gesteckt werden sollen, helfen den ganz Kleinen, ihre Geschicklichkeit auf spielerische Weise zu entwickeln.53,33 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Gibt es alte Louis Vuitton Taschen ohne Data Code?
Ja, es gibt alte Louis Vuitton Taschen, die keinen Data Code haben. Der Data Code wurde erst ab den 1980er Jahren eingeführt, daher können ältere Taschen davor keinen haben. Es ist jedoch wichtig zu beachten, dass das Fehlen eines Data Codes nicht unbedingt bedeutet, dass die Tasche gefälscht ist, da es viele andere Faktoren gibt, die bei der Authentifizierung einer Louis Vuitton Tasche berücksichtigt werden sollten. **
-
Was ist der Data Code von Louis Vuitton 2?
Es tut mir leid, aber ich kann keinen spezifischen Data Code für Louis Vuitton 2 finden. Der Data Code ist normalerweise eine Kombination aus Buchstaben und Zahlen, die in Louis Vuitton-Produkten eingestanzt sind und Informationen über das Herstellungsdatum und den Produktionsort geben. Es ist möglich, dass es verschiedene Data Codes für verschiedene Produkte oder Kollektionen gibt. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **

Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Top-Angebote
Produkte zum Begriff Sortier-Code:
-
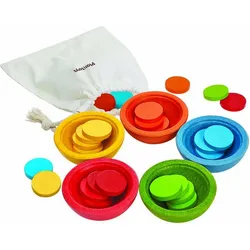
Plantoys Sortier- und ZählbecherDie Firma PlanToys bezieht das Holz für ihre Spielzeugproduktion von der eigenen Gummibaumplantage. Kann ein Baum aufgrund seines hohen Alters keinen Kautschuk mehr produzieren, wird er gefällt und zur Weiterverarbeitung in die Fabrik gebracht. Aufgrund des eingeführten Wiederaufforstungsprogramms wird pro gefälltem Baum ein neuer Baum gepflanzt, um die entstandene ökologische Lücke wieder zu schliessen. In der Fabrik wird das Vollholz der gefällten Gummibäume schliesslich zur Herstellung der Spielwaren benutzt. Für deren Bemalung werden hierbei ausnahmslos wasserbasierte Farbstoffe verwendet.26,95 €*Versand: 3,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Gibt es alte Louis Vuitton Taschen ohne Data Code?
Ja, es gibt alte Louis Vuitton Taschen, die keinen Data Code haben. Der Data Code wurde erst ab den 1980er Jahren eingeführt, daher können ältere Taschen davor keinen haben. Es ist jedoch wichtig zu beachten, dass das Fehlen eines Data Codes nicht unbedingt bedeutet, dass die Tasche gefälscht ist, da es viele andere Faktoren gibt, die bei der Authentifizierung einer Louis Vuitton Tasche berücksichtigt werden sollten. **
Ähnliche Suchbegriffe für Sortier-Code
-
Janod Pure Sortier - und SteckspielJanod Sortier- und Steckspiel 6tlg. Eine hübsche Sortierschachtel in zarten und hochaktuellen Farbtönen mit niedlichen Tieren. Die sechs Formen, die in das Zelt gesteckt werden sollen, helfen den ganz Kleinen, ihre Geschicklichkeit auf spielerische Weise zu entwickeln.53,33 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Tolo Classic Tolo Bio Formen-Sortier-BallTolo Bio Formensortierer Ball Weisst du, welches Formteil in welches Loch im Ball gehört? Ein vielseitiger Formensortierer, der auch als Ball verwendet werden kann. Die einfache Drehöffnung des Balls erleichtert das Entfernen der Formteile aus dem Ball, indem man die beiden Hälften voneinander trennt. Enthält sechs Formteile, die ein rasselndes Geräusch machen. Grösse: 14 cm. Geeignet ab einem Alter von 12 Monaten. Die Tolo Bio Kollektion zeichnet sich aus durch: - Neue Biokunststoffe aus Weizenstroh, recycelbare Verpackungen und Sojatinte für den Druck. - Spielzeug, das mit Blick auf Nachhaltigkeit entworfen wurde und nur Materialien von höchster Qualität verwendet. - Attraktiv gestaltetes Spielzeug mit klaren und deutlichen Farben, die von Kindern leicht verstanden werden können. - Spielzeug, das Bildungs- und Entwicklungs-Vorteile bietet und Kindern spielerisch beibringt. - Spielzeug, das die kreative Entwicklung von Kindern fördert. - International preisgekröntes Spielzeug.60,46 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Data Code von Louis Vuitton 2?
Es tut mir leid, aber ich kann keinen spezifischen Data Code für Louis Vuitton 2 finden. Der Data Code ist normalerweise eine Kombination aus Buchstaben und Zahlen, die in Louis Vuitton-Produkten eingestanzt sind und Informationen über das Herstellungsdatum und den Produktionsort geben. Es ist möglich, dass es verschiedene Data Codes für verschiedene Produkte oder Kollektionen gibt. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.