Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **

Ähnliche Suchbegriffe für Sainz
Top-Angebote
Produkte zum Begriff Sainz:
-
Puma, Herren, Sportshirt, SF Sainz Tee (L), MehrfarbigProduktgeschichte Wenn du in der Boxengasse, auf der Tribüne oder in der Stadt bist, siehst du aus wie ein Teil des Scuderia Ferrari Teams. Die Farben Rosso Corsa und Schwarz bringen den modernen Twist in diese Ära des Rennsports, während das Logo der Scuderia Ferrari auf der Vorderseite zu sehen ist, damit du deine Unterstützung für die Marke zeigen kannst. Diese Sonderedition des Shirts ehrt den Fahrer Carlos Sainz und ist mit seinen spezifischen Details wie seiner Fahrernummer und Unterschrift versehen. Details - Normale Passform - 160 g/m2, Single-Jersey - Rundhalsausschnitt - Kurze Ärmel - Fahrernummer und Unterschriftengrafik - Scuderia Ferrari Logo.62,71 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Ferrari F1 Sf-23 #55 Carlos Sainz BBURAGODas Ferrari F1 SF-23 Modellauto von Bburago ist eine detailgetreue Nachbildung des Formel 1 Fahrzeugs, das von Carlos Sainz gefahren wird. Im Massstab 1:24 gefertigt, bietet dieses Modell eine präzise Darstellung der Originaldetails und ist aus hochwertigen Materialien wie Zink-Spritzguss und Plastik hergestellt. Die edle Verpackung in Plexiglas schützt das Modell und macht es zu einem ansprechenden Sammlerstück. Mit einer Höhe von 8,8 cm, einer Länge von 26 cm und einer Breite von 11,8 cm ist es ideal für die Präsentation in Vitrinen oder auf Regalen. Dieses Modell ist nicht nur ein tolles Geschenk für Formel 1-Fans, sondern auch eine wertvolle Ergänzung für jede Sammlung. - Detailgetreue Nachbildung im Massstab 1:24 - Hochwertige Materialien: Zink-Spritzguss und Plastik - Edle Plexiglas-Verpackung mit graviertem Schild - Geeignet für Sammler ab 14 Jahren.41,36 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **


Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff Sainz:
-
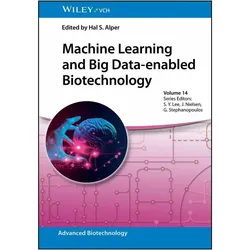
Machine Learning and Big Data-enabled Biotechnology, Fachbücher von Hal S. AlperDas Fachbuch 'Machine Learning and Big Data-enabled Biotechnology' bietet eine umfassende Darstellung der Anwendung von Machine Learning und Big Data in der Biotechnologie. Es gliedert sich in drei Hauptteile, die sich jeweils auf unterschiedliche Aspekte der Biotechnologie konzentrieren. Der erste Teil widmet sich der DNA, wobei Themen von der synthetischen Biologie, wie dem Design von Promotoren, bis hin zu Vorhersagen aus Genomsequenzen behandelt werden. Im zweiten Teil liegt der Fokus auf Proteinen, wobei sowohl Struktur- und Designwerkzeuge als auch die Entdeckung von Stoffwechselwegen und Retrobiosynthese thematisiert werden. Der abschliessende Teil befasst sich mit ganzen Zellen und beleuchtet Machine Learning Ansätze zur Genexpression sowie Vorhersagen von Phänotypen und der Leistung von Bioreaktoren. Das Buch bietet somit einen breiten Überblick über die Integration moderner Datenanalysemethoden in die biotechnologische Forschung und Entwicklung. Es richtet sich an Fachleute und Studierende, die an der Schnittstelle von Biotechnologie, Datenwissenschaft und Ingenieurwesen arbeiten.135,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Nazarena, Belletristik von Karina Sainz BorgoNazarena ist ein fesselnder Roman von Karina Sainz Borgo, der die komplexen Dynamiken einer Familie beleuchtet, die von Schuld, Verrat und Wahnsinn geprägt ist. In der familiären Residenz von La Araira leben acht Schwestern unter dem Schatten einer traumatisierten Mutter und einer von Konflikten geprägten Vergangenheit. Die Protagonistin Nazarena ist besessen davon, den Hof zu fegen, um Unglück abzuwenden, doch die wahren Bedrohungen liegen in den unausgesprochenen Rivalitäten und den Geistern der Vergangenheit, die in den Erinnerungen der Schwestern weiterleben. Sainz Borgos eindringliche Prosa, die mit intensiven Bildern und tiefen kulturellen Resonanzen durchzogen ist, enthüllt schrittweise die Geheimnisse und Ängste, die jede dieser Frauen plagen. Mit Anklängen an literarische Grössen wie Rulfo und García Márquez erforscht dieser Roman die Zerbrechlichkeit des menschlichen Daseins und die komplexen Beziehungen zwischen Schuld, Macht und Überleben. Nazarena ist eine eindringliche Erzählung über familiäre Brüche und die Kunst der Autorin, Traditionen neu zu interpretieren.26,50 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Puma, Herren, Sportshirt, SF Sainz Tee (L), MehrfarbigProduktgeschichte Wenn du in der Boxengasse, auf der Tribüne oder in der Stadt bist, siehst du aus wie ein Teil des Scuderia Ferrari Teams. Die Farben Rosso Corsa und Schwarz bringen den modernen Twist in diese Ära des Rennsports, während das Logo der Scuderia Ferrari auf der Vorderseite zu sehen ist, damit du deine Unterstützung für die Marke zeigen kannst. Diese Sonderedition des Shirts ehrt den Fahrer Carlos Sainz und ist mit seinen spezifischen Details wie seiner Fahrernummer und Unterschrift versehen. Details - Normale Passform - 160 g/m2, Single-Jersey - Rundhalsausschnitt - Kurze Ärmel - Fahrernummer und Unterschriftengrafik - Scuderia Ferrari Logo.62,71 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Sainz
-
Ferrari F1 Sf-23 #55 Carlos Sainz BBURAGODas Ferrari F1 SF-23 Modellauto von Bburago ist eine detailgetreue Nachbildung des Formel 1 Fahrzeugs, das von Carlos Sainz gefahren wird. Im Massstab 1:24 gefertigt, bietet dieses Modell eine präzise Darstellung der Originaldetails und ist aus hochwertigen Materialien wie Zink-Spritzguss und Plastik hergestellt. Die edle Verpackung in Plexiglas schützt das Modell und macht es zu einem ansprechenden Sammlerstück. Mit einer Höhe von 8,8 cm, einer Länge von 26 cm und einer Breite von 11,8 cm ist es ideal für die Präsentation in Vitrinen oder auf Regalen. Dieses Modell ist nicht nur ein tolles Geschenk für Formel 1-Fans, sondern auch eine wertvolle Ergänzung für jede Sammlung. - Detailgetreue Nachbildung im Massstab 1:24 - Hochwertige Materialien: Zink-Spritzguss und Plastik - Edle Plexiglas-Verpackung mit graviertem Schild - Geeignet für Sammler ab 14 Jahren.41,36 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wilmott, Paul: Grundkurs Machine LearningGrundkurs Machine Learning , Aus der Buchreihe »Informatik verstehen«. Ideal zum Selbststudium , Querlenker > Sportfederung , Erscheinungsjahr: 20200724, Produktform: Kartoniert, Titel der Reihe: Rheinwerk Computing##, Autoren: Wilmott, Paul, Seitenzahl/Blattzahl: 256, Themenüberschrift: COMPUTERS / General, Keyword: Hand-Buch Bücher lernen Studium Grundlagen Kurse Workshops Tutorials Wissen Anleitung Training Ausbildung; Robotik; Informatik verstehen; Programmierung programmieren; KI-Welt AI; Künstliche Intelligenz; Software-Entwicklung; Coder Coden; Neuronale Netze; Deep Learning; Mathematik, Fachschema: Informatik~Programmiersprachen~EDV / Theorie / Allgemeines, Fachkategorie: Informatik~Informationstechnik (IT), allgemeine Themen, Sprache: Deutsch, Warengruppe: HC/Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Länge: 228, Breite: 175, Höhe: 17, Gewicht: 480, Produktform: Klappenbroschur, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 232715029,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Huyen, Chip: Designing Machine Learning SystemsDesigning Machine Learning Systems , An Iterative Process for Production-Ready Applications , > , Erscheinungsjahr: 202207, Produktform: Kartoniert, Autoren: Huyen, Chip, Themenüberschrift: COMPUTERS / Intelligence (AI) & Semantics~COMPUTERS / Enterprise Applications / Business Intelligence Tools~COMPUTERS / Data Science / Machine Learning, Fachschema: Datenverarbeitung / Anwendungen / Betrieb, Verwaltung~Intelligenz / Künstliche Intelligenz~KI~Künstliche Intelligenz - AI~Management / Strategisches Management~Strategisches Management~Unternehmensstrategie / Strategisches Management, Fachkategorie: Unternehmenssoftware~Strategisches Management, Warengruppe: TB/Informatik, Fachkategorie: Maschinelles Lernen, Text Sprache: eng, Seitenanzahl: XVI, Seitenanzahl: 367, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: O'Reilly Media, Verlag: O'Reilly Media, Länge: 229, Breite: 175, Höhe: 21, Gewicht: 678, Produktform: Kartoniert, Genre: Importe, Genre: Importe, Katalog: Gesamtkatalog, Katalog: Internationale Lagertitel, Katalog: internationale Titel, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0020, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch,53,84 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.