Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **

Ähnliche Suchbegriffe für Privatization
Top-Angebote
Produkte zum Begriff Privatization:
-
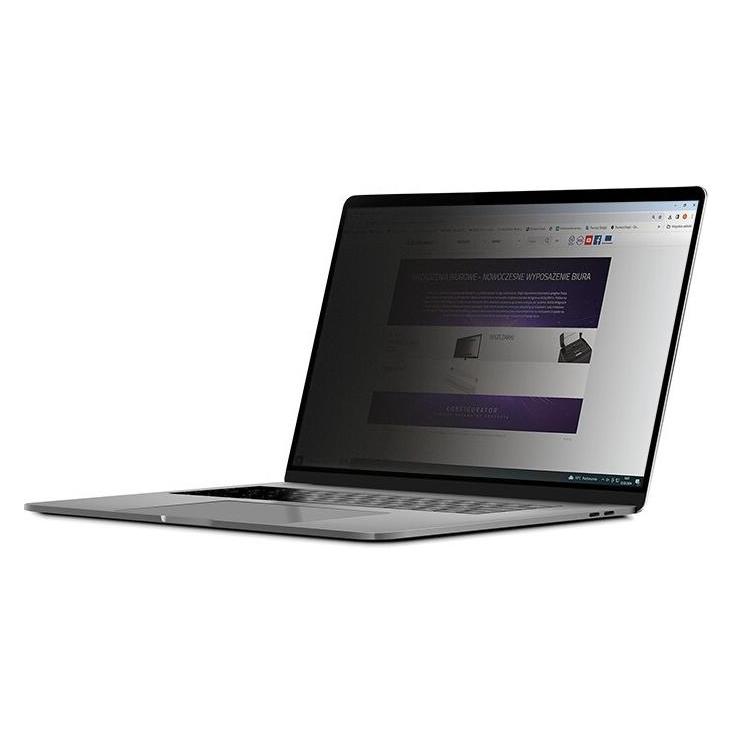
3M privatization of the filter 35.6cm 14 "16: 9 175X310MM - BSF35.6W (14", 16:9), Notebook SchutzfolieDie Blickschutzfilter BSF35.6W sind für 16:9-Breitbild-Notebooks mit einer sichtbaren Bildschirmgrösse von 14,0 Zoll ausgelegt. Unter Verwendung der 3M Mikrolamellen-Technologie bietet der Filter vollen 60-Grad-Schutz der Privatsphäre auf beiden Seiten und schützt sensible Informationen vor unbefugter Betrachtung. Der Filter kann an Ort und Stelle bleiben, wenn das Notebook nicht verwendet wird, und stellt zusätzlichen Bildschirmschutz dar. Mit einer leicht matten Oberfläche kann der Filter dazu beitragen, die Bildschirmreflexion zu reduzieren.53,60 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Fundamentals, Fachbücher von Hui JiangDiese klare und kohärente Einführung in das überwachte maschinelle Lernen präsentiert die Kernkonzepte auf eine prägnante, logische und leicht verständliche Weise für Leser mit grundlegenden mathematischen Kenntnissen, aber ohne vorherige Erfahrung im maschinellen Lernen. Die Themen umfassen sowohl weit verbreitete traditionelle Methoden als auch die kürzlich populären Methoden des tiefen Lernens.72,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **


Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff Privatization:
-
The Privatization of Israeli Security, Sachbücher von Shir HeverThe Privatization of Israeli Security" von Shir Hever bietet eine tiefgehende Analyse der Transformation des israelischen Sicherheitsdienstes zwischen 1994 und 2014. In dieser Zeit entwickelte sich Israel zu einem der extremsten Beispiele für privatisierte Sicherheit weltweit. Hever untersucht die Entstehung von "Occupation Inc.", einem privaten militärisch-sicherheitlichen Komplex, und beleuchtet die zunehmende staatlich geförderte Gewalt, die aus dieser Securitisation resultiert. Das Buch analysiert die Auswirkungen des anhaltenden palästinensischen Widerstands gegen die israelische Besatzung, den Einfluss der US-Militärhilfe sowie den Aufstieg des Neoliberalismus in Israel. Durch die Perspektive der politischen Ökonomie wird aufgezeigt, wie israelische Sicherheitseliten Gewalt in eine Ware verwandeln, um ihren Status und Reichtum zu bewahren. Diese Untersuchung bietet einen frischen Blick auf die israelische Besatzung und deren komplexe Dynamiken.32,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
3MK Privacy 2way für Apple iPad Pro 11 M4/M5 (horizontal privatization)Schutzfolie - für Apple iPad Pro M4 13" (2024), auf das Display, Reinigungstuch, Flüßigkeit zur Applikation, Alkohol-Tuch und Sticker zur Entfernung von Staub im Lieferumfang44,90 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
3M privatization of the filter 35.6cm 14 "16: 9 175X310MM - BSF35.6W (14", 16:9), Notebook SchutzfolieDie Blickschutzfilter BSF35.6W sind für 16:9-Breitbild-Notebooks mit einer sichtbaren Bildschirmgrösse von 14,0 Zoll ausgelegt. Unter Verwendung der 3M Mikrolamellen-Technologie bietet der Filter vollen 60-Grad-Schutz der Privatsphäre auf beiden Seiten und schützt sensible Informationen vor unbefugter Betrachtung. Der Filter kann an Ort und Stelle bleiben, wenn das Notebook nicht verwendet wird, und stellt zusätzlichen Bildschirmschutz dar. Mit einer leicht matten Oberfläche kann der Filter dazu beitragen, die Bildschirmreflexion zu reduzieren.53,60 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Privatization
-
Machine Learning Fundamentals, Fachbücher von Hui JiangDiese klare und kohärente Einführung in das überwachte maschinelle Lernen präsentiert die Kernkonzepte auf eine prägnante, logische und leicht verständliche Weise für Leser mit grundlegenden mathematischen Kenntnissen, aber ohne vorherige Erfahrung im maschinellen Lernen. Die Themen umfassen sowohl weit verbreitete traditionelle Methoden als auch die kürzlich populären Methoden des tiefen Lernens.72,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Grundkurs Machine Learning, Fachbücher von Paul WilmottMaschinelles Lernen – alle Grundlagen! Paul Wilmott ist für seine erhellende und unterhaltsame Darstellung angewandter Mathematik bekannt. Von der linearen Regression bis zu neuronalen Netzwerken führt er Sie durch alle Verfahren, und zwar komplett software-unabhängig. Der Vorteil dabei: Jeder Schritt ist schwarz auf weiss zu sehen, kein Framework kann etwas „verstecken“, es geht immer um die Sache selbst. Mit vielen Beispielen, Grafiken und Schritt-für-Schritt-Kästen. Für alle, die wirklich verstehen wollen, wie Maschinen lernen. Aus dem Inhalt: lineare Regression, k-nearest neighbors, naive Bayes-Klassifikatoren, k-Means-Algorithmus, Support Vector Machines, logistische Regression, selbstorganisierende Karten, Entscheidungsbäume, Reinforcement Learning, neuronale Netze.29,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Kochbuch, Fachbücher von Chris AlbonPython-Programmierer finden in diesem Kochbuch nahezu 200 wertvolle und jeweils in sich abgeschlossene Anleitungen zu Aufgabenstellungen aus dem Bereich des Machine Learning, wie sie für die tägliche Arbeit typisch sind – von der Vorverarbeitung der Daten bis zum Deep Learning. Entwickler, die mit Python und seinen Bibliotheken einschliesslich Pandas und Scikit-Learn vertraut sind, werden spezifische Probleme erfolgreich bewältigen – wie etwa Daten laden, Text und numerische Daten behandeln, Modelle auswählen, Dimensionalität reduzieren und vieles mehr. Jedes Rezept enthält Code, den Sie kopieren, zum Testen in eine kleine Beispieldatenmenge einfügen und dann anpassen können, um Ihre eigenen Anwendungen zu konstruieren. Darüber hinaus werden alle Lösungen diskutiert und wichtige Zusammenhänge hergestellt. Dieses Kochbuch unterstützt Sie dabei, den Schritt von der Theorie und den Konzepten hinein in die Praxis zu machen. Es liefert das praktische Rüstzeug, das Sie benötigen, um funktionierende Machine-Learning-Anwendungen zu entwickeln. In diesem Kochbuch finden Sie Rezepte für: - Vektoren, Matrizen und Arrays - den Umgang mit numerischen und kategorischen Daten, Texten, Bildern sowie Datum und Uhrzeit - das Reduzieren der Dimensionalität durch Merkmalsextraktion oder Merkmalsauswahl - Modellbewertung und -auswahl - lineare und logistische Regression, Bäume und Wälder und k-nächste Nachbarn - Support Vector Machine (SVM), naive Bayes, Clustering und neuronale Netze - das Speichern und Laden von trainierten Modellen Chris hat den Kochbuchcharakter seines Buchs genutzt, um nicht nur eine Referenz für erfahrene Profis zu bieten, sondern auch eine leicht zugängliche Reihe von kleinen Tutorials, die Anfänger schätzen werden. Dieses Buch ist eine wertvolle Ressource, egal ob man sein Wissen vor einem Vorstellungsgespräch als Data Scientist auffrischen möchte oder eine prägnante und dennoch gründliche Referenz für den Schreibtisch sucht.36,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.