Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **

Ähnliche Suchbegriffe für Piles
Top-Angebote
Produkte zum Begriff Piles:
-
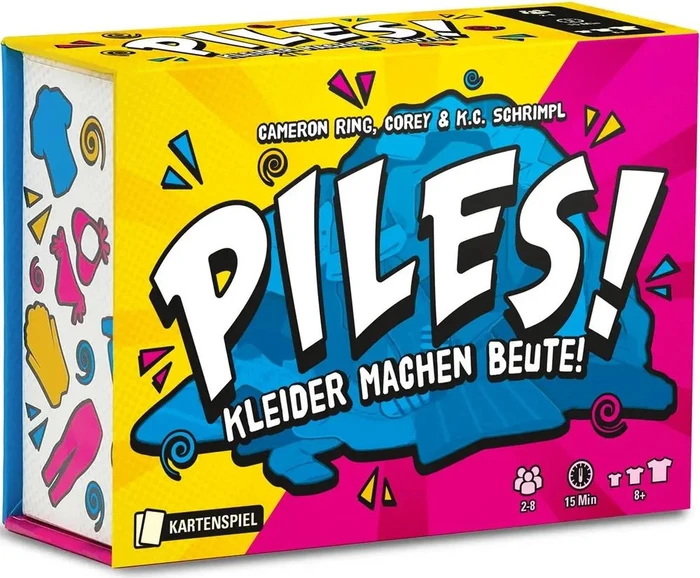
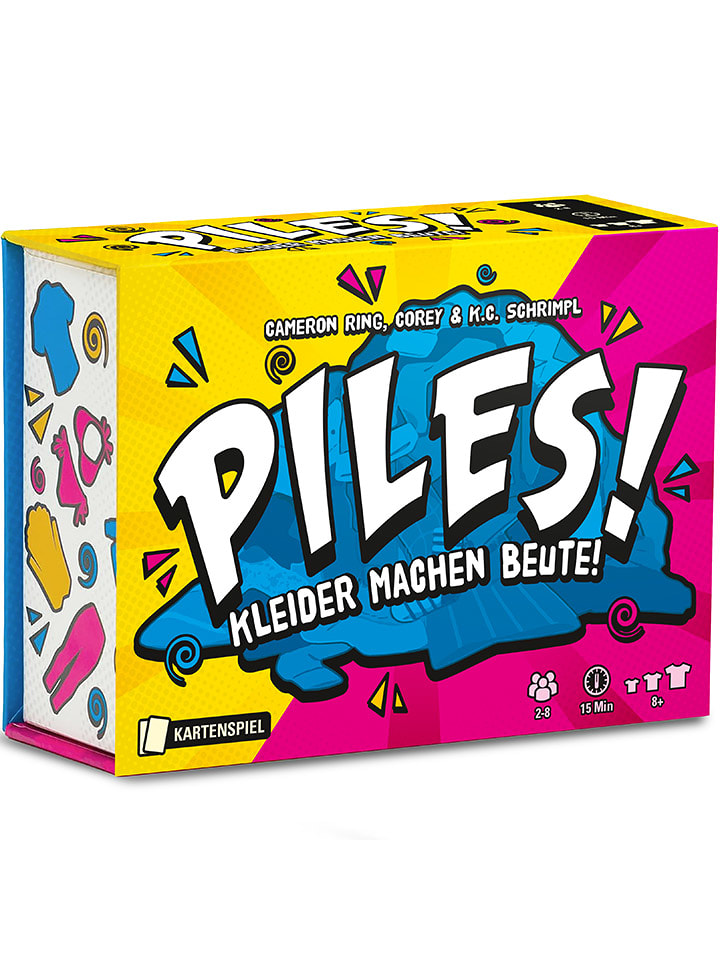
Game Factory Kartenspiel "Piles" - ab 8 Jahren - onesizeKartenspiel "Piles" - ab 8 Jahren von Game Factory - Finde passende Kleidungsstücke schneller als die anderen. - Inhalt: 200 Karten, 1 Spielanleitung - Spieleranzahl: 2 - 4 - Altersempfehlung: ab 8 Jahren Achtung! Nicht geeignet für Kinder unter 3 Jahren. Erstickungsgefahr durch verschluckbare Kleinteile.17,99 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
Piles of Earth and Rubble, Fachbücher von Ina Kwon"Piles of Earth and Rubble" von Ina Kwon ist ein eindrucksvolles Fachbuch, das sich mit der Geschichte und der kulturellen Bedeutung von Grabhügeln in Gyeongju, Südkorea, und dem Grossen Schuttberg in München auseinandersetzt. Kwon, eine erfahrene Grafik-Designerin, kombiniert Fotografien und Texte, um die Verbindungen zwischen diesen beiden Orten zu erkunden, die durch künstliche Hügel geprägt sind. Diese Hügel sind nicht nur archäologische Stätten, sondern auch Symbole für die Konstruktion und Rekonstruktion von Geschichte. Das Buch gliedert sich in zwei Teile, die Gyeongju und München gegenüberstellen und dabei die Themen Erinnerung, Vergessen und kulturelle Identität beleuchten. Mit einer ansprechenden Gestaltung und tiefgründigen Analysen bietet dieses Werk einen einzigartigen Einblick in die Art und Weise, wie Geschichte durch Landschaften und Monumente geformt wird.28,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff Piles:
-
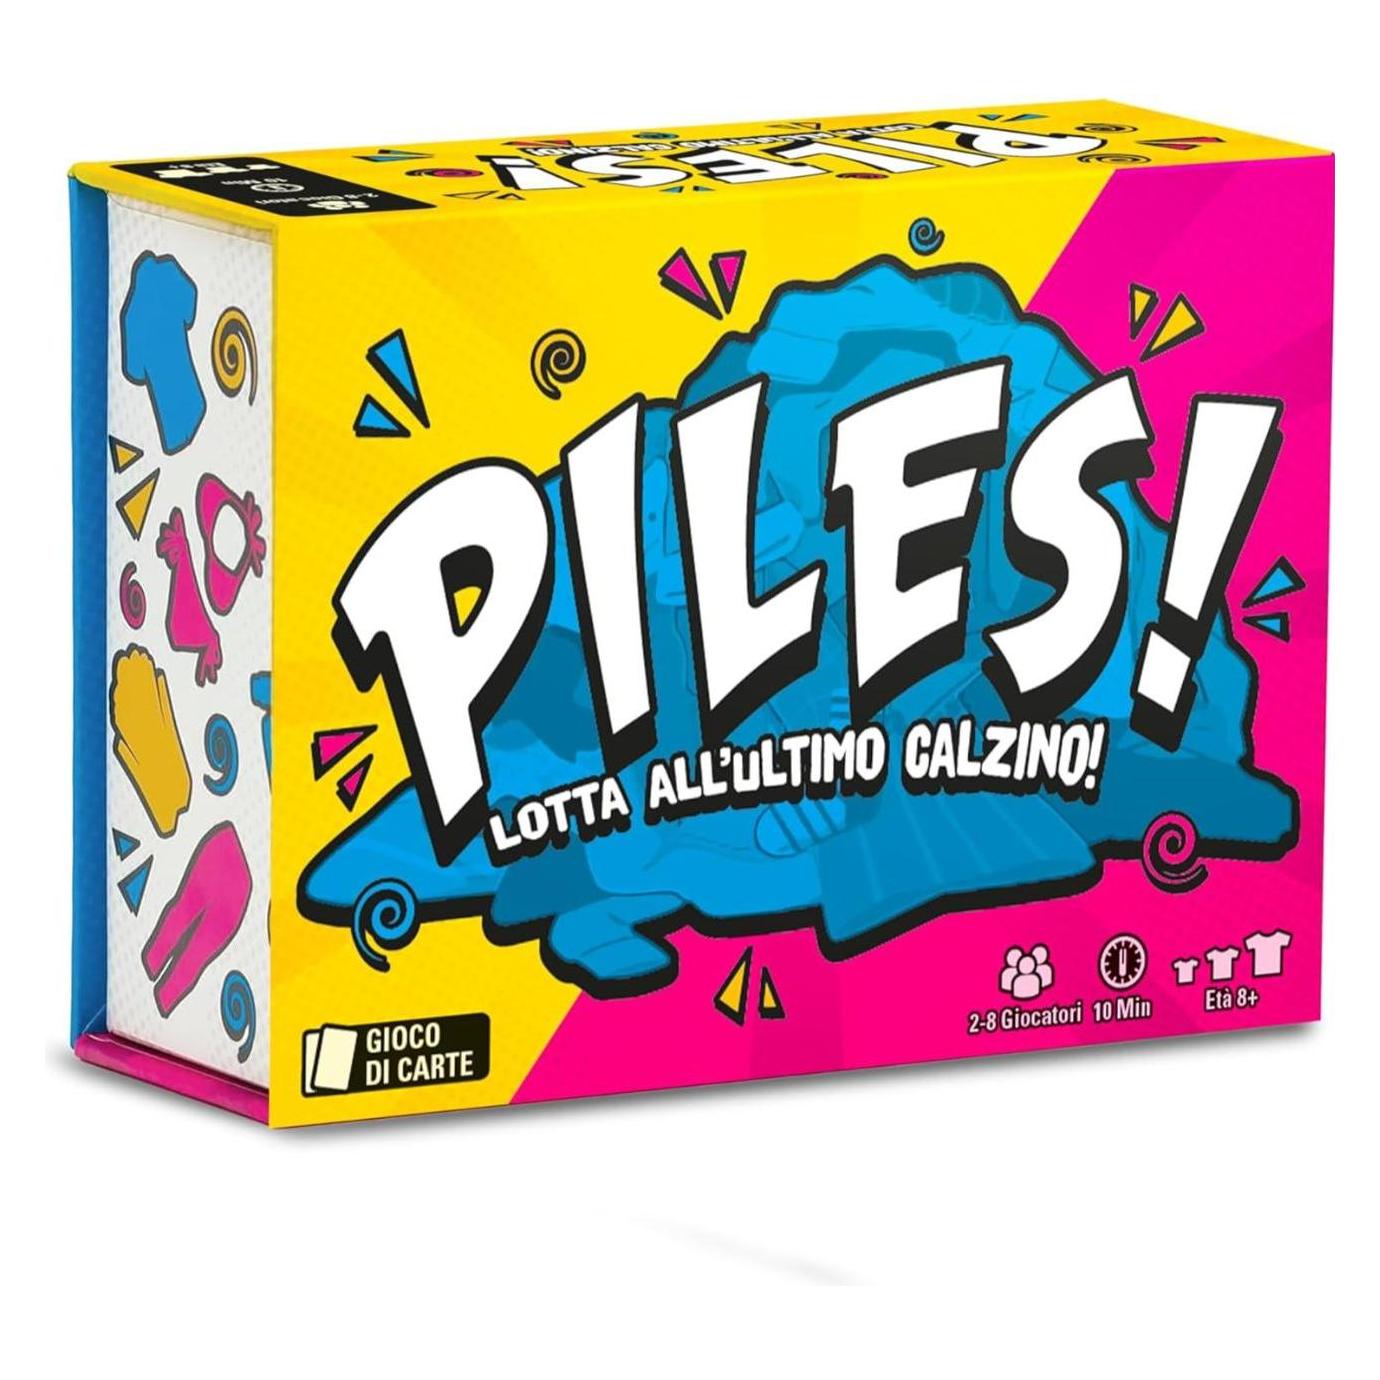
Asmodée Piles (Spanisch, 2 - 8 Spieler)Das Kartenspiel "Piles" von Asmodée bietet ein unterhaltsames und interaktives Spielerlebnis für die ganze Familie. Es ist für eine Vielzahl von Altersgruppen geeignet, wobei das empfohlene Mindestalter bei 8 Jahren liegt. Das Spiel fördert die soziale Interaktion und kann mit bis zu 8 Spielern gespielt werden, was es ideal für Familienabende oder gesellige Zusammenkünfte macht. Die Spielregeln sind klar und verständlich, sodass sowohl Kinder als auch Erwachsene schnell in das Spiel einsteigen können. Mit einer Spielzeit von etwa 10 Minuten ist "Piles" perfekt für kurze Spielrunden oder als Aufwärmspiel für längere Spielabende. Die Sprache des Spiels ist Spanisch, was es zu einer interessanten Wahl für spanischsprachige Familien oder für diejenigen macht, die ihre Sprachkenntnisse verbessern möchten. - Maximale Spieleranzahl: 8 - Minimale Spieleranzahl: 2 - Spielregeln sind im Lieferumfang enthalten - Geeignet für Erwachsene und Kinder.31,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Game Factory Kartenspiel "Piles" - ab 8 Jahren - onesizeKartenspiel "Piles" - ab 8 Jahren von Game Factory - Finde passende Kleidungsstücke schneller als die anderen. - Inhalt: 200 Karten, 1 Spielanleitung - Spieleranzahl: 2 - 4 - Altersempfehlung: ab 8 Jahren Achtung! Nicht geeignet für Kinder unter 3 Jahren. Erstickungsgefahr durch verschluckbare Kleinteile.17,99 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Piles
-
Piles of Earth and Rubble, Fachbücher von Ina Kwon"Piles of Earth and Rubble" von Ina Kwon ist ein eindrucksvolles Fachbuch, das sich mit der Geschichte und der kulturellen Bedeutung von Grabhügeln in Gyeongju, Südkorea, und dem Grossen Schuttberg in München auseinandersetzt. Kwon, eine erfahrene Grafik-Designerin, kombiniert Fotografien und Texte, um die Verbindungen zwischen diesen beiden Orten zu erkunden, die durch künstliche Hügel geprägt sind. Diese Hügel sind nicht nur archäologische Stätten, sondern auch Symbole für die Konstruktion und Rekonstruktion von Geschichte. Das Buch gliedert sich in zwei Teile, die Gyeongju und München gegenüberstellen und dabei die Themen Erinnerung, Vergessen und kulturelle Identität beleuchten. Mit einer ansprechenden Gestaltung und tiefgründigen Analysen bietet dieses Werk einen einzigartigen Einblick in die Art und Weise, wie Geschichte durch Landschaften und Monumente geformt wird.28,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.