Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Nachbarschaft
Top-Angebote
Produkte zum Begriff Nachbarschaft:
-
1000 Jahre Nachbarschaft, Sachbücher von Arnold SuppanDas Buch "1000 Jahre Nachbarschaft" bietet eine umfassende Analyse der nachbarschaftlichen Entwicklung der deutsch- und tschechischsprachigen Bevölkerung im Donau- und Sudetenraum über einen Zeitraum von mehr als tausend Jahren. Es beleuchtet die politischen, wirtschaftlichen und sozialen Veränderungen, die diese Region geprägt haben, und geht dabei auf die kulturellen und mentalitätsgeschichtlichen Aspekte ein. Die Darstellung umfasst die Kontinuitäten und Diskontinuitäten im Heiligen Römischen Reich sowie die gemeinsame Geschichte in der Habsburgermonarchie. Besondere Aufmerksamkeit wird den nationalen Konflikten zwischen 1848 und 1948 gewidmet, die sowohl die Zeit Franz Josephs als auch die beiden Weltkriege und deren Folgen umfassen. Das Buch schliesst mit einer Betrachtung der gesellschaftlichen Veränderungen nach dem Fall des Eisernen Vorhangs und der neuen Nachbarschaft innerhalb der Europäischen Union ab.39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie ist die Nachbarschaft?
Die Nachbarschaft ist sehr freundlich und ruhig. Die Menschen sind hilfsbereit und es gibt viele Grünflächen und Parks in der Umgebung. Es gibt auch eine gute Auswahl an Geschäften und Restaurants in der Nähe. **
Top-Angebote
Produkte zum Begriff Nachbarschaft:
-
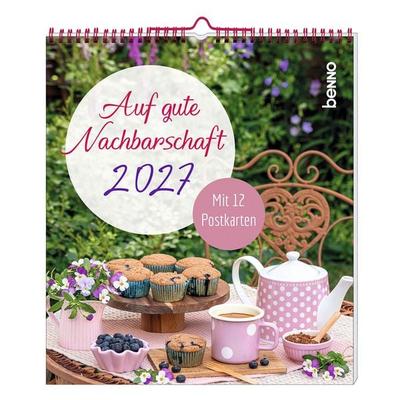
Auf gute Nachbarschaft 2027Jeder Der Sie Hat, Weiß Es – Gute Nachbarn Sind Gold Wert. Nicht Selten Helfen Sie In Notlagen Aus, Betreuen Haustiere Und Pflanzen Während Der Urlaubszeit Oder Stehen Uns Mit Einem Guten Rat Und Einem Offenen Ohr Zur Seite. Feiern Sie Dieses...8,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Potenziale guter Nachbarschaft, FachbücherKulturelle Bildung ist eine Notwendigkeit, eine Haltung, ein Ziel. Im zweiten Buch der Schriftenreihe Kunst- und Kulturvermittlung in Europa stellt die Stiftung Genshagen zusammen mit ihrem polnischen Partner Narodowe Centrum Kultury eine Bestandsaufnahme der Entwicklungen auf dem breiten Feld der Kulturellen Bildung seit 1989 dar. Die Publikation enthält eine Sammlung der aktuell repräsentierten Meinungen und Standpunkte sowie der neuesten Erkenntnisse, entscheidenden Veränderungen und innovativsten Forschungen der Experten zu dem Thema, die einem breiteren interessierten Publikum in beiden Ländern vorgelegt werden kann.29,80 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
1000 Jahre Nachbarschaft, Sachbücher von Arnold SuppanDas Buch "1000 Jahre Nachbarschaft" bietet eine umfassende Analyse der nachbarschaftlichen Entwicklung der deutsch- und tschechischsprachigen Bevölkerung im Donau- und Sudetenraum über einen Zeitraum von mehr als tausend Jahren. Es beleuchtet die politischen, wirtschaftlichen und sozialen Veränderungen, die diese Region geprägt haben, und geht dabei auf die kulturellen und mentalitätsgeschichtlichen Aspekte ein. Die Darstellung umfasst die Kontinuitäten und Diskontinuitäten im Heiligen Römischen Reich sowie die gemeinsame Geschichte in der Habsburgermonarchie. Besondere Aufmerksamkeit wird den nationalen Konflikten zwischen 1848 und 1948 gewidmet, die sowohl die Zeit Franz Josephs als auch die beiden Weltkriege und deren Folgen umfassen. Das Buch schliesst mit einer Betrachtung der gesellschaftlichen Veränderungen nach dem Fall des Eisernen Vorhangs und der neuen Nachbarschaft innerhalb der Europäischen Union ab.39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Nachbarschaft
-
Die Ausrottung der Nachbarschaft - Kai Magnus Sting, Audio, 9783864845635Die Ausrottung Der Nachbarschaft Von Kai Magnus Sting, Tacheles!, 978-3-86484-563-5, Sprecher: Kai Magnus Sting,henning Venske,hans Korte,jochen Busse,gerburg Jahnke, Sprache: Deutsch13,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie ist die Nachbarschaft?
Die Nachbarschaft ist sehr freundlich und ruhig. Die Menschen sind hilfsbereit und es gibt viele Grünflächen und Parks in der Umgebung. Es gibt auch eine gute Auswahl an Geschäften und Restaurants in der Nähe. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.