Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Menge
Top-Angebote
Produkte zum Begriff Menge:
-
Menge 2020 (Bibel) - Journaling Edition, FachbücherDie Menge 2020 (Bibel) – Journaling Edition präsentiert sich als ein umfassendes Fachbuch, das sich an Leserinnen und Leser richtet, die sowohl an einer tiefgehenden Auseinandersetzung mit christlicher Literatur als auch an einer persönlichen, kreativen Gestaltung interessiert sind. Diese Ausgabe umfasst drei AT-Bände und einen NT-Band, die in einem hochwertigen Schuber gebündelt sind. Das extra dicke Papier ermöglicht den Einsatz dickerer Stifte und Textmarker, während der breite Rand ausreichend Raum für Notizen und individuelle Gestaltungen bietet. Die Übersetzung besticht durch ihre schöne, würdevolle Sprache und die präzise Wiedergabe des Grundtextes. Die sorgfältige Revision der ursprünglichen Menge-Bibel von 1939, insbesondere die erweiterte Fussnotenarbeit, unterstreicht den Anspruch an Genauigkeit und Lesefreundlichkeit. Die Arbeit des Sprachenkenners, der sowohl die grundtextliche Genauigkeit als auch die flüssige Lesbarkeit in den Vordergrund stellt, macht diese Ausgabe zu einem wertvollen Begleiter für das persönliche Studium und die spirituelle Reflexion. Die Kombination aus traditioneller Bibelübersetzung und modernen Gestaltungsmöglichkeiten bietet einen einzigartigen Mehrwert für alle, die sich intensiv mit dem christlichen Glauben auseinandersetzen möchten.90,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **

Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie beeinflusst die sammelnde und verarbeitende Menge an Daten in Unternehmen und der Gesellschaft unseren Alltag? Welche Potenziale und Risiken birgt Big Data?
Die zunehmende Menge an gesammelten und verarbeiteten Daten ermöglicht personalisierte Dienstleistungen und Produkte, aber auch die Überwachung und Manipulation von Individuen. Big Data birgt das Potenzial für innovative Lösungen in Bereichen wie Gesundheitswesen und Verkehr, aber auch Risiken in Bezug auf Datenschutz und Privatsphäre. Es ist wichtig, den verantwortungsvollen Umgang mit Daten zu fördern und ethische Standards zu etablieren. **
Top-Angebote
Produkte zum Begriff Menge:
-
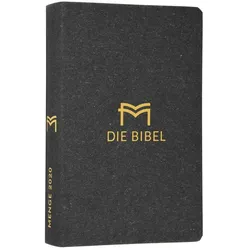
Die Bibel - Menge 2020, Fachbücher von Hermann August MengeFlexibler Umschlag, Farbschnitt 2. Auflage 2020. Die Menge-Übersetzung besticht durch ihre schöne und würdevolle Sprache und brilliert durch ihre Genauigkeit in der Wiedergabe des Grundtextes. Sie ist eine sehr gründliche Arbeit eines Sprachenkenners und gekonnten Anwenders. Seine Bemühungen um grundtextliche Genauigkeit einerseits und die sinnvolle Hinwendung zur flüssigen und damit auch verständlichen Lesbarkeit andererseits sind ihm im vollen Umfang gelungen. Die Menge 2020 ist eine gründliche Revision der Menge-Bibel von 1939. Besonders die Fussnoten wurden wesentlich erweitert!.44,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Menge 2020 (Bibel) - Journaling Edition, FachbücherDie Menge 2020 (Bibel) – Journaling Edition präsentiert sich als ein umfassendes Fachbuch, das sich an Leserinnen und Leser richtet, die sowohl an einer tiefgehenden Auseinandersetzung mit christlicher Literatur als auch an einer persönlichen, kreativen Gestaltung interessiert sind. Diese Ausgabe umfasst drei AT-Bände und einen NT-Band, die in einem hochwertigen Schuber gebündelt sind. Das extra dicke Papier ermöglicht den Einsatz dickerer Stifte und Textmarker, während der breite Rand ausreichend Raum für Notizen und individuelle Gestaltungen bietet. Die Übersetzung besticht durch ihre schöne, würdevolle Sprache und die präzise Wiedergabe des Grundtextes. Die sorgfältige Revision der ursprünglichen Menge-Bibel von 1939, insbesondere die erweiterte Fussnotenarbeit, unterstreicht den Anspruch an Genauigkeit und Lesefreundlichkeit. Die Arbeit des Sprachenkenners, der sowohl die grundtextliche Genauigkeit als auch die flüssige Lesbarkeit in den Vordergrund stellt, macht diese Ausgabe zu einem wertvollen Begleiter für das persönliche Studium und die spirituelle Reflexion. Die Kombination aus traditioneller Bibelübersetzung und modernen Gestaltungsmöglichkeiten bietet einen einzigartigen Mehrwert für alle, die sich intensiv mit dem christlichen Glauben auseinandersetzen möchten.90,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Menge
-
Gerber Bicecci, Verónica: Leere MengeLeere Menge , Lässt sich eine Affäre geometrisch darstellen? Oder eine Familie zeichnen? Können Baumringe davon erzählen, dass Mütter verschwinden? 'Leere Menge' ist die Geschichte von Verónica, einer jungen Frau, die in Mexiko-Stadt lebt. Nach ihrer Trennung von Tordo kehrt sie in die Wohnung ihrer argentinischen Mutter zurück. Dort erkundet sie die Leere, die ihre Mutter hinterließ, nachdem diese vor Jahren plötzlich verschwunden war. Zwischen verstaubten Möbeln und Pflanzenskeletten spürt sie der Einsamkeit und Ungewissheit nach, die diese Verluste mit sich bringen. Wenn Worte dafür nicht ausreichen, weichen sie Zeichnungen, Abstraktionen, Schemata. Mit Strichen und Buchstaben konstruiert die mexikanische Autorin Verónica Gerber Bicecci eine intime Geschichte rund um die Themen Exil, Verlust, Liebe und die Suche nach familiären Wurzeln. , Elektromotoren & -teile > Elektro- & Hybridautoteile , Erscheinungsjahr: 20221012, Produktform: Leinen, Autoren: Gerber Bicecci, Verónica, Übersetzung: Weilguny, Birgit, Seitenzahl/Blattzahl: 240, Keyword: Abwesenheit; Argentinien; Exil; Mexiko; Mutter; Trennung, Fachschema: Argentinische Belletristik / Roman, Erzählung~Mexikanische Belletristik / Roman, Erzählung~Mexiko / Roman, Erzählung, Region: Mexiko, Thema: Auseinandersetzen, Warengruppe: HC/Belletristik/Romane/Erzählungen, Fachkategorie: Moderne und zeitgenössische Belletristik, Thema: Entspannen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Maro Verlag, Verlag: Maro Verlag, Verlag: Maro Verlag & Druck Benno Ksmayr, Länge: 205, Breite: 139, Höhe: 22, Gewicht: 350, Produktform: Gebunden, Genre: Belletristik, Genre: Belletristik, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0070, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,24,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie beeinflusst die sammelnde und verarbeitende Menge an Daten in Unternehmen und der Gesellschaft unseren Alltag? Welche Potenziale und Risiken birgt Big Data?
Die zunehmende Menge an gesammelten und verarbeiteten Daten ermöglicht personalisierte Dienstleistungen und Produkte, aber auch die Überwachung und Manipulation von Individuen. Big Data birgt das Potenzial für innovative Lösungen in Bereichen wie Gesundheitswesen und Verkehr, aber auch Risiken in Bezug auf Datenschutz und Privatsphäre. Es ist wichtig, den verantwortungsvollen Umgang mit Daten zu fördern und ethische Standards zu etablieren. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.