Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **

Ähnliche Suchbegriffe für Krankheit
Top-Angebote
Produkte zum Begriff Krankheit:
-
Krankheit gestalten, Fachbücher von Henrik EsslerMoulagen - plastische Krankheitsdarstellungen - waren wichtige Dokumentations- und Lehrobjekte der Medizin. Die Moulagenbildner galten in der Medizingeschichte oft als skurrile Aussenseiter, deren Arbeit von alchemistisch anmutender Geheimnistuerei umgeben war. Henrik Essler widmet sich erstmals der Berufsgeschichte dieser unterschätzten Spezialisten. Dabei stellt er einerseits die Bedeutung der Moulage heraus, die weit über eine naturgetreue Nachbildung hinausging. Andererseits rückt er die Stellung der Moulagenbildner im wissenschaftlichen Arbeitsprozess in ein neues Licht: Sie waren nicht nur ausführendes Organ, sondern Kooperationspartner im Forschungszusammenhang.39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Poetisierung der Krankheit, Fachbücher von Dongyao LiuDas Fachbuch 'Poetisierung der Krankheit' bietet eine tiefgehende literaturwissenschaftliche Analyse des Schlüsselbegriffs 'Krankheit' in der deutschsprachigen Literatur des 20. Jahrhunderts. Die Studie untersucht, wie Krankheit in den Werken bedeutender Autoren der Moderne wie Gottfried Benn, Franz Kafka, Friedrich Dürrenmatt und Thomas Bernhard sowohl als Metapher als auch als Methode eingesetzt wird. Dabei wird die Krankheit nicht nur als Darstellungsform, sondern als Reflexionsfigur genutzt, um zentrale Fragen der Moderne zu verhandeln. Die Untersuchung gliedert sich in vier Dimensionen: die Ästhetisierung, die Metaphorisierung, die Parodie und die kulturelle Bedeutung der Krankheit. Durch die detaillierte Analyse literarischer Techniken wird aufgezeigt, wie Krankheitsnarrative die literarische Ästhetik der Moderne prägten und gleichzeitig kulturelle Vorstellungen von Krankheit beeinflussten. Das Buch richtet sich an Leserinnen und Leser, die an einer vertieften Auseinandersetzung mit literarischen und kulturellen Aspekten der Krankheit interessiert sind. Es bietet einen interdisziplinären Zugang, der sowohl literaturwissenschaftliche als auch kulturwissenschaftliche Perspektiven integriert.74,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff Krankheit:
-
Kind - Krankheit - Religion, FachbücherKrankheit ist eine der grundlegenden Erfahrungen, die den Alltag von Kindern prägen. Jedes Kind wird krank, manchmal schwerer oder sogar lebensbedrohlich, mit potenziell lebenslangen Folgen. Da die moderne Medizin eine Trennung von Religion und Medizin praktiziert, hat die Frage nach dem Zusammenhang zwischen Religion und Krankheit in der Regel keinen Platz, wenn man zu Hause oder in der Klinik krank ist. Die Kulturgeschichte von Krankheit und Gesundheit bis zur modernen Zeit war jedoch weitgehend auch die Geschichte der Religion, und Kinder sowie ihre Eltern stellen in diesen Situationen oft Fragen zu Gott und Glauben.55,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Krankheit gestalten, Fachbücher von Henrik EsslerMoulagen - plastische Krankheitsdarstellungen - waren wichtige Dokumentations- und Lehrobjekte der Medizin. Die Moulagenbildner galten in der Medizingeschichte oft als skurrile Aussenseiter, deren Arbeit von alchemistisch anmutender Geheimnistuerei umgeben war. Henrik Essler widmet sich erstmals der Berufsgeschichte dieser unterschätzten Spezialisten. Dabei stellt er einerseits die Bedeutung der Moulage heraus, die weit über eine naturgetreue Nachbildung hinausging. Andererseits rückt er die Stellung der Moulagenbildner im wissenschaftlichen Arbeitsprozess in ein neues Licht: Sie waren nicht nur ausführendes Organ, sondern Kooperationspartner im Forschungszusammenhang.39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Krankheit
-
Poetisierung der Krankheit, Fachbücher von Dongyao LiuDas Fachbuch 'Poetisierung der Krankheit' bietet eine tiefgehende literaturwissenschaftliche Analyse des Schlüsselbegriffs 'Krankheit' in der deutschsprachigen Literatur des 20. Jahrhunderts. Die Studie untersucht, wie Krankheit in den Werken bedeutender Autoren der Moderne wie Gottfried Benn, Franz Kafka, Friedrich Dürrenmatt und Thomas Bernhard sowohl als Metapher als auch als Methode eingesetzt wird. Dabei wird die Krankheit nicht nur als Darstellungsform, sondern als Reflexionsfigur genutzt, um zentrale Fragen der Moderne zu verhandeln. Die Untersuchung gliedert sich in vier Dimensionen: die Ästhetisierung, die Metaphorisierung, die Parodie und die kulturelle Bedeutung der Krankheit. Durch die detaillierte Analyse literarischer Techniken wird aufgezeigt, wie Krankheitsnarrative die literarische Ästhetik der Moderne prägten und gleichzeitig kulturelle Vorstellungen von Krankheit beeinflussten. Das Buch richtet sich an Leserinnen und Leser, die an einer vertieften Auseinandersetzung mit literarischen und kulturellen Aspekten der Krankheit interessiert sind. Es bietet einen interdisziplinären Zugang, der sowohl literaturwissenschaftliche als auch kulturwissenschaftliche Perspektiven integriert.74,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
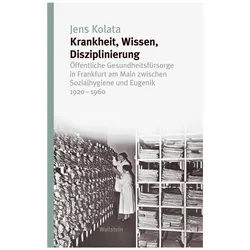
Krankheit, Wissen, Disziplinierung, Fachbücher von Jens KolataÜberwachen und disziplinieren - die Entwicklung gesundheitsfürsorgerischer Praktiken im 20. Jahrhundert anhand des Beispiels Frankfurt a. M. Ausgehend von der eugenisch geprägten Idee einer national, erbbiologisch und ideologisch definierten „Volksgemeinschaft“ wurden im nationalsozialistischen Deutschland Gesundheitsfürsorge und Sozialhygiene zu zentralen Handlungsfeldern der Politik. Jens Kolata untersucht die Praxis der öffentlichen Gesundheitsfürsorge am Beispiel von Frankfurt a. M. von 1920 bis 1960. Das städtische Gesundheitsamt bildete das Zentrum eines Netzes von Institutionen und Personen, die hauptsächlich sozial benachteiligte und am Rande der Gesellschaft stehende Menschen betreuten, überwachten, reglementierten und disziplinierten. Dabei standen die Bekämpfung von Geschlechtskrankheiten und die psychiatrische Fürsorge in engem Zusammenhang mit der Praxis der Sterilisation, der erbbiologischen Erfassung der Bevölkerung und der Unterbringung bestimmter Personengruppen in Arbeitshäusern - letzteres noch über die NS-Zeit hinaus. Auch die Perspektiven und Handlungsweisen der Betroffenen werden in dieser Studie beleuchtet. Der Band reicht über die Zäsuren von 1933 und 1945 hinaus und nimmt sowohl Radikalisierungsprozesse in der Weimarer Republik als auch Kontinuitäten in der frühen Bundesrepublik in den Blick.46,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
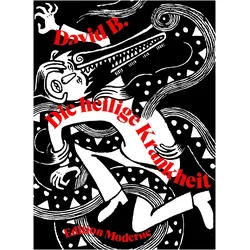
Die heilige Krankheit, Comics + Manga von David B."Die heilige Krankheit" ist ein eindringlicher Comic von David B., der die bewegende Familiengeschichte erzählt, die von der Epilepsie seines Bruders geprägt ist. Die Erzählung führt die Leser durch die verzweifelte Suche der Eltern nach Heilung, die sie zu verschiedenen Ärzten, Gurus und sogar zu Sekten und spirituellen Orten wie Lourdes führt. Inmitten dieser Herausforderungen flüchtet sich der junge David in eine Fantasiewelt, die von seltsamen Figuren und der Gewalt der Realität geprägt ist. Die dichten Schwarz-Weiss-Kompositionen von David B. verleihen der Geschichte eine besondere Tiefe und Intensität. Diese Erzählung ist nicht nur ein Bericht über Krankheit und Überleben, sondern auch eine Reflexion über die menschliche Erfahrung und die Suche nach Hoffnung in dunklen Zeiten.29,00 €*Versand: 3,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.