Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **

Ähnliche Suchbegriffe für Kind
Top-Angebote
Produkte zum Begriff Kind:
-
Some Kind, Any Kind, Fachbücher von Ana CastanhoDas Buch "Some Kind, Any Kind" bietet eine facettenreiche Erkundung der Architekturpraxis OODA über einen Zeitraum von fünfzehn Jahren. Es ist als eine Art innerer Dialog konzipiert, der die Themen "Some Kind of Romance" und "Any Kind of Existence" miteinander verwebt. Diese beiden Teile reflektieren nicht nur vergangene und zukünftige Projekte, sondern auch die Philosophie der Praxis, die Architektur als ein chronologisches und erzählerisches Element betrachtet. In Albanien wird die transformative Auseinandersetzung mit urbaner Regeneration und Identitätswiederaufbau in einem sich schnell verändernden städtischen Kontext thematisiert. In Portugal hingegen wird die Kontinuität durch Rehabilitation und Neubau untersucht, wobei Zeit, Erbe und Landschaft als aktive Materialien behandelt werden. Diese beiden Dimensionen offenbaren eine Praxis, die von Beharrlichkeit, Risiko, Zugehörigkeit und Transformation geprägt ist und die sowohl in einem bestimmten Ort verwurzelt ist als auch offen für Neuerfindung bleibt.46,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
New Kind of Machine Learning-Cellular Automata Model, Fachbücher von Dipanwita Roy Chowdhury, Adip Dutta, Parimal Pal Chaudhuri, Somshubhro Pal Choudhury, Raju HazariDas Buch "New Kind of Machine Learning-Cellular Automata Model" bietet eine umfassende Einführung in das CAML-Modell, das eine innovative Kombination aus Zellulären Automaten (CA) und Maschinellem Lernen (ML) darstellt. Dieses Modell wurde entwickelt, um effiziente Berechnungen mit minimalen Trainingsdaten und geringen Rechenressourcen zu ermöglichen. Es betrachtet zwei Hauptperspektiven: Zum einen wird CA durch ML verbessert, um komplexe nichtlineare Entwicklungen zu bewältigen, und zum anderen stärkt CA ML, indem es die lineare CA-Entwicklung nutzt, um lineare Funktionen effektiv zu verarbeiten. Das Buch beleuchtet die praktischen Anwendungen von CA, insbesondere in der Computational Biology, wo CAML Modelle von Proteinsträngen erstellt, um Mutationen vorherzusagen, die mit menschlichen Krankheiten in Verbindung stehen. Ein weiteres bedeutendes Anwendungsfeld ist die mehrsprachige Sentiment-Analyse, bei der das Modell Texte in fünf Sprachen analysiert, ohne auf vortrainierte Sprachmodelle zurückzugreifen. CAML verwendet CA-Regeln für die Modellierung von Unicode-Zeichen und bietet einen transparenten, interpretierbaren Vorhersagealgorithmus. Insgesamt zielt CAML darauf ab, industrielle und gesellschaftliche Anwendungen von CA voranzutreiben, wobei der Fokus auf transparenten Ergebnissen und effizientem Hardware-Design liegt.100,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
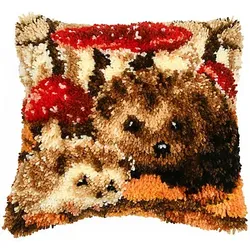
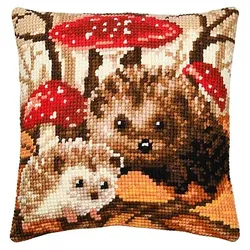
Knüpfkissen "Igelmama & Kind"Knüpfkissen Igelmama & Kind. Komplettpackung: Anleitung, Garn. Ohne Kissenrücken, Kissenfüllung, Knüpfhaken. Größe: 40 x 40 cm. Material: Stoff handbemalter Stramin 52 % Baumwolle, 48 % Polyester (ca. 18 Stiche/10 cm), Garnschnittpackungen 100 % Polyacryl.33,95 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
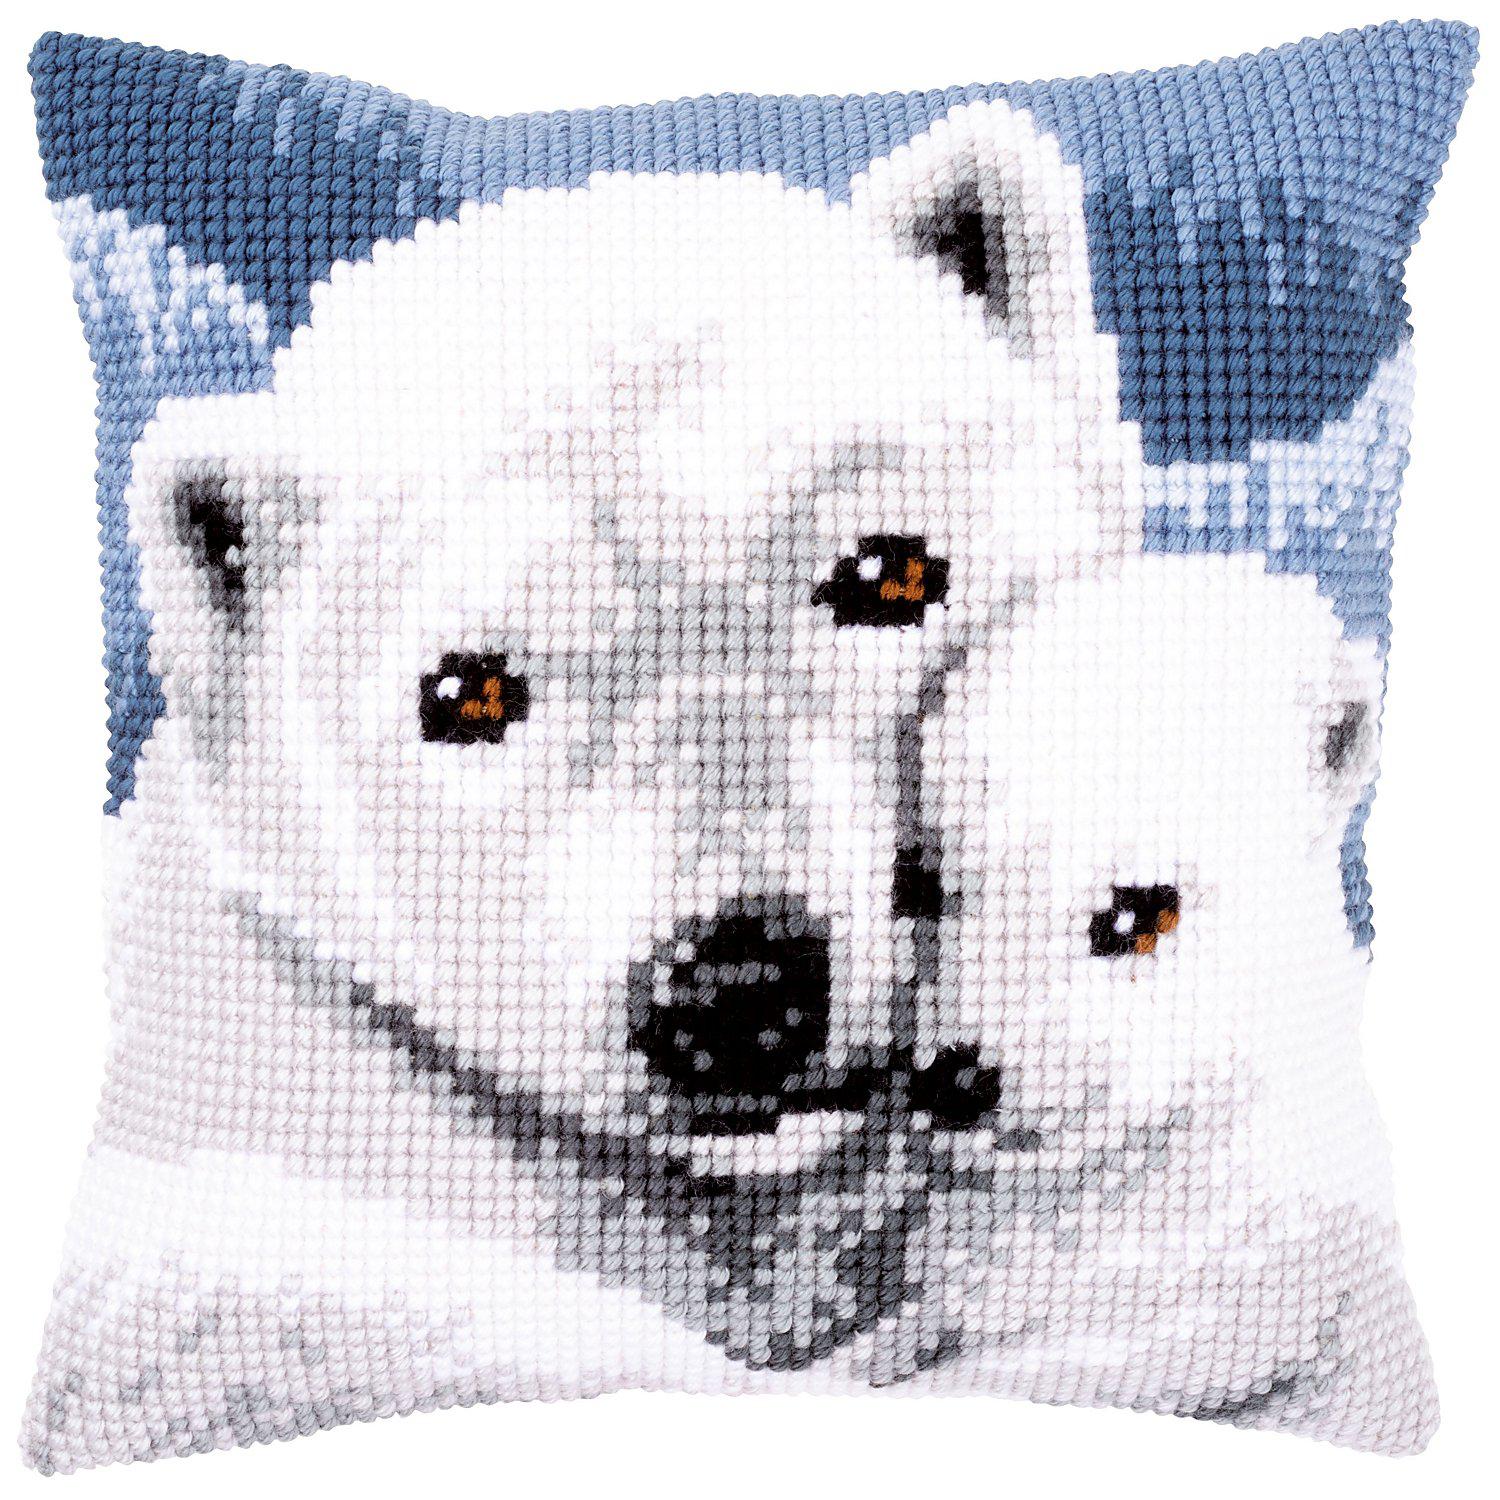
Kreuzstichkissen "Eisbärmama & Kind"Kreuzstichkissen "Eisbärmama & Kind". Superleicht zu sticken, geeignet für Kinder ab 8 Jahren. Komplettpackung: Anleitung, Garn, Sticknadel. Ohne Kissenrücken und -füllung. Größe: 40 x 40 cm. Material: Stoff handbemalter Stramin 100 % Baumwolle (ca. 18 Stiche/10 cm), Garn 100 % Polyacryl.26,95 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter

-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff Kind:
-
Machine Learning and Big Data-enabled Biotechnology, Fachbücher von Hal S. AlperDas Fachbuch 'Machine Learning and Big Data-enabled Biotechnology' bietet eine umfassende Darstellung der Anwendung von Machine Learning und Big Data in der Biotechnologie. Es gliedert sich in drei Hauptteile, die sich jeweils auf unterschiedliche Aspekte der Biotechnologie konzentrieren. Der erste Teil widmet sich der DNA, wobei Themen von der synthetischen Biologie, wie dem Design von Promotoren, bis hin zu Vorhersagen aus Genomsequenzen behandelt werden. Im zweiten Teil liegt der Fokus auf Proteinen, wobei sowohl Struktur- und Designwerkzeuge als auch die Entdeckung von Stoffwechselwegen und Retrobiosynthese thematisiert werden. Der abschliessende Teil befasst sich mit ganzen Zellen und beleuchtet Machine Learning Ansätze zur Genexpression sowie Vorhersagen von Phänotypen und der Leistung von Bioreaktoren. Das Buch bietet somit einen breiten Überblick über die Integration moderner Datenanalysemethoden in die biotechnologische Forschung und Entwicklung. Es richtet sich an Fachleute und Studierende, die an der Schnittstelle von Biotechnologie, Datenwissenschaft und Ingenieurwesen arbeiten.135,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kind of a Big Deal, Kinderbücher von Shannon Hale"Kind of a big deal" von Shannon Hale ist ein fesselndes Kinderbuch, das die Geschichte von Josie Pie erzählt, einer ehemaligen Highschool-Ikone, die ihre Träume auf Broadway verwirklichen wollte. Nach einem dramatischen Fall von Ruhm und dem Verlust ihrer sozialen Verbindungen findet sich Josie in einer aussergewöhnlichen Situation wieder: Sie kann in die Geschichten eintauchen, die sie liest. Jedes Buch, das sie aufschlägt, bringt sie in eine neue Welt, in der sie verschiedene Charaktere verkörpert, von einer Heldin in einer post-apokalyptischen Zukunft bis hin zu einer Protagonistin in einer romantischen Komödie. Während sie in diesen fantastischen Erzählungen lebt, wird Josie mit der Herausforderung konfrontiert, dass das Verweilen in einer Geschichte auch bedeutet, dass es schwieriger wird, in die Realität zurückzukehren. Dieses Buch ist nicht nur eine aufregende Reise durch verschiedene Genres, sondern auch eine tiefgründige Erkundung von Identität, Freundschaft und den Herausforderungen des Erwachsenwerdens.28,16 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Some Kind, Any Kind, Fachbücher von Ana CastanhoDas Buch "Some Kind, Any Kind" bietet eine facettenreiche Erkundung der Architekturpraxis OODA über einen Zeitraum von fünfzehn Jahren. Es ist als eine Art innerer Dialog konzipiert, der die Themen "Some Kind of Romance" und "Any Kind of Existence" miteinander verwebt. Diese beiden Teile reflektieren nicht nur vergangene und zukünftige Projekte, sondern auch die Philosophie der Praxis, die Architektur als ein chronologisches und erzählerisches Element betrachtet. In Albanien wird die transformative Auseinandersetzung mit urbaner Regeneration und Identitätswiederaufbau in einem sich schnell verändernden städtischen Kontext thematisiert. In Portugal hingegen wird die Kontinuität durch Rehabilitation und Neubau untersucht, wobei Zeit, Erbe und Landschaft als aktive Materialien behandelt werden. Diese beiden Dimensionen offenbaren eine Praxis, die von Beharrlichkeit, Risiko, Zugehörigkeit und Transformation geprägt ist und die sowohl in einem bestimmten Ort verwurzelt ist als auch offen für Neuerfindung bleibt.46,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
New Kind of Machine Learning-Cellular Automata Model, Fachbücher von Dipanwita Roy Chowdhury, Adip Dutta, Parimal Pal Chaudhuri, Somshubhro Pal Choudhury, Raju HazariDas Buch "New Kind of Machine Learning-Cellular Automata Model" bietet eine umfassende Einführung in das CAML-Modell, das eine innovative Kombination aus Zellulären Automaten (CA) und Maschinellem Lernen (ML) darstellt. Dieses Modell wurde entwickelt, um effiziente Berechnungen mit minimalen Trainingsdaten und geringen Rechenressourcen zu ermöglichen. Es betrachtet zwei Hauptperspektiven: Zum einen wird CA durch ML verbessert, um komplexe nichtlineare Entwicklungen zu bewältigen, und zum anderen stärkt CA ML, indem es die lineare CA-Entwicklung nutzt, um lineare Funktionen effektiv zu verarbeiten. Das Buch beleuchtet die praktischen Anwendungen von CA, insbesondere in der Computational Biology, wo CAML Modelle von Proteinsträngen erstellt, um Mutationen vorherzusagen, die mit menschlichen Krankheiten in Verbindung stehen. Ein weiteres bedeutendes Anwendungsfeld ist die mehrsprachige Sentiment-Analyse, bei der das Modell Texte in fünf Sprachen analysiert, ohne auf vortrainierte Sprachmodelle zurückzugreifen. CAML verwendet CA-Regeln für die Modellierung von Unicode-Zeichen und bietet einen transparenten, interpretierbaren Vorhersagealgorithmus. Insgesamt zielt CAML darauf ab, industrielle und gesellschaftliche Anwendungen von CA voranzutreiben, wobei der Fokus auf transparenten Ergebnissen und effizientem Hardware-Design liegt.100,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Kind
-
Knüpfkissen "Igelmama & Kind"Knüpfkissen Igelmama & Kind. Komplettpackung: Anleitung, Garn. Ohne Kissenrücken, Kissenfüllung, Knüpfhaken. Größe: 40 x 40 cm. Material: Stoff handbemalter Stramin 52 % Baumwolle, 48 % Polyester (ca. 18 Stiche/10 cm), Garnschnittpackungen 100 % Polyacryl.33,95 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Kreuzstichkissen "Eisbärmama & Kind"Kreuzstichkissen "Eisbärmama & Kind". Superleicht zu sticken, geeignet für Kinder ab 8 Jahren. Komplettpackung: Anleitung, Garn, Sticknadel. Ohne Kissenrücken und -füllung. Größe: 40 x 40 cm. Material: Stoff handbemalter Stramin 100 % Baumwolle (ca. 18 Stiche/10 cm), Garn 100 % Polyacryl.26,95 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Kreuzstichkissen "Igelmamam & Kind"Kreuzstichkissen Igelmamam & Kind. Komplettpackung: Anleitung, Garn, Sticknadel. Ohne Kissenrücken und -füllung. Größe: 40 x 40 cm. Material: Stoff handbemalter Stramin 100 % Baumwolle (ca. 18 Stiche/10 cm), Garn 100 % Polyacryl.26,95 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Geschirrtuch "Rentiermama & Kind"Geschirrtuch Rentiermama & Kind, zum Besticken in Stiel-, Platt-, Knötchen-, Margeritenstich und Nadelmalerei. Fertig genäht mit vorgedrucktem Motiv. Komplettpackung: Anleitung, Garn, Sticknadel. Stofffarbe: weiß. Größe: 46 x 71 cm. Material: Stoff und Garn 100 % Baumwolle.7,99 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.