Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
Ähnliche Suchbegriffe für Hörgespinste-2---Der
Top-Angebote
Produkte zum Begriff Hörgespinste-2---Der:
-
Der große Fridolin 2Der große Fridolin 2 ist die ideale Fortsetzung für junge Gitarrenschüler. Mit anspruchsvolleren Stücken aus Klassik, Blues, Flamenco und Folklore fördert dieses Gitarrenbuch das mehrstimmige Spiel und hilft dabei, fortgeschrittene Techniken wie Barré-Griffe und Lagenspiel zu erlernen.17,50 €*Versand: 4,00 €Sichere Weiterleitung zum Anbieter


-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was ist der Unterschied zwischen Deep Learning und Machine Learning?
Deep Learning ist eine spezielle Methode des Machine Learning, die auf künstlichen neuronalen Netzwerken basiert. Es ermöglicht das Lernen von hierarchischen und komplexen Merkmalsdarstellungen, um automatisch Muster und Strukturen in Daten zu erkennen. Im Gegensatz dazu ist Machine Learning ein breiterer Begriff, der verschiedene Algorithmen und Techniken umfasst, um Computermodelle zu erstellen, die aus Daten lernen und Vorhersagen treffen können. Deep Learning ist also eine Teilmenge des Machine Learning. **
-
Ist AWS der Standard im Machine Learning?
AWS ist einer der führenden Anbieter von Cloud-Computing-Diensten, einschließlich Machine Learning. Es bietet eine breite Palette von ML-Diensten und Tools wie Amazon SageMaker und Amazon Rekognition, die von vielen Unternehmen genutzt werden. Obwohl AWS als Standard angesehen werden kann, gibt es auch andere Anbieter wie Google Cloud und Microsoft Azure, die ebenfalls starke ML-Funktionen bieten. Die Wahl des richtigen Anbieters hängt von den spezifischen Anforderungen und Präferenzen des Unternehmens ab. **

Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
Top-Angebote
Produkte zum Begriff Hörgespinste-2---Der:
-
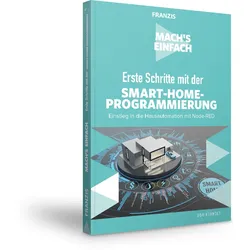
Erste Schritte mit der Smart-Home-Programmierung - Mach's EinfachEinstieg in die Hausautomation mit Node-RED Mit diesem Buch werden Sie schon nach kurzer Zeit in der Lage sein, kleine Helfer zur Unterstützung im Alltag selbst zu entwickeln - ganz ohne dass Sie sich durch spröde Materie für Nerds und Computer-Freaks quälen müssen. In diesem Sinne ist das Buch Wegbereiter und Ideengeber für eigene, gelungene Smart-Home-Lösungen unter dem Dach des ?Internet of Things?. Programmierkenntnisse und Erfahrungen in der Installation von Software sind nicht erforderlich, da jeder einzelne Schritt zur Realisierung eines Projekts detailliert beschrieben und mit Screenshots visuell unterlegt wird. Ausgehend vom industriellen Bereich, finden diese Ansätze zunehmend auch im privaten Sektor ihren Einsatz. Schlagwörter sind hier Smart Home oder Wearables. Immer kleinere in Gegenstände eingebettete Computer sollen dazu dienen, den Besitzer im Alltagsleben zu u...9,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Hörgespinste-2---Der
-
Der große Fridolin 2Der große Fridolin 2 ist die ideale Fortsetzung für junge Gitarrenschüler. Mit anspruchsvolleren Stücken aus Klassik, Blues, Flamenco und Folklore fördert dieses Gitarrenbuch das mehrstimmige Spiel und hilft dabei, fortgeschrittene Techniken wie Barré-Griffe und Lagenspiel zu erlernen.17,50 €*Versand: 4,00 €Sichere Weiterleitung zum Anbieter
-
Roco 6210179 H0 3-tlg. Set 2: Railjet der neuen Generation der ÖBB Wagenset 2 der Österreichischen BundesbahnenMit dem Railjet 2 setzten die Österreichischen Bundesbahnen ihre erfolgreiche Hochgeschwindigkeitsstrategie fort und führt eine neue Generation von Fernverkehrszügen ein, die höchsten Komfort, moderne Technik und verbesserte Energieeffizienz miteinander vereinen. Der Railjet 2 basiert auf der so genannten Viaggio Next Level-Plattform des Herstellers Siemens Transportation und wurde als Nachfolger des bewährten Railjet 1 konzipiert. Er orientiert sich dabei stärker an einem geschlossenen Zugverband mit durchgängiger Fahrgastführung und hoher Modularität. Hinweis: Zum Schalten der Innenbeleuchtung wird das Set 6210178 benötigt!329,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Spiegelhalter, David: Die Kunst der StatistikDie Kunst der Statistik , Was uns Daten wirklich sagen und wie wir dies im Alltag nutzen können , Bremsen & Bremsenteile > Motorrad- & Rollerteile & -zubehör , Erscheinungsjahr: 20200317, Produktform: Leinen, Autoren: Spiegelhalter, David, Übersetzung: Bertheau, Nikolas, Seitenzahl/Blattzahl: 381, Keyword: Bestseller USA; Daten im Alltag verstehen; Die Kunst der statistik; Sex by numbers; Spss; Stata; Statistik lernen leicht gemacht; Statistik verstehen; Statistiken lesen leren; Titanic; Virus; Wie man Statistiken liest; Zahlen nund Fakten; art of statistic; art of statistics; beschreibende statistik und wirtschaftsstatistik; bestseller; bestseller autoren; bestseller books; bestseller buch; bestseller bücher; bestseller in amazon; bestseller sachbuch; big data analytics; big data in der praxis; big data management; bigdata; corona; corona vierus; corona wirus; coronavirus; daten auswerten; datenanalyse; datenkompetenz; datenmenge; david spiegelhalter; epidemie; learning from data, Fachschema: Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik~Database~Datenbank~Analyse / Datenanalyse~Datenanalyse, Fachkategorie: Datenerfassung und -analyse, Warengruppe: HC/Wirtschaft/Sonstiges, Fachkategorie: Ökonometrie und Wirtschaftsstatistik, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Redline, Verlag: Redline, Verlag: REDLINE, Länge: 218, Breite: 149, Höhe: 28, Gewicht: 694, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, eBook EAN: 9783962671785 9783962671792, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,29,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Unterschied zwischen Deep Learning und Machine Learning?
Deep Learning ist eine spezielle Methode des Machine Learning, die auf künstlichen neuronalen Netzwerken basiert. Es ermöglicht das Lernen von hierarchischen und komplexen Merkmalsdarstellungen, um automatisch Muster und Strukturen in Daten zu erkennen. Im Gegensatz dazu ist Machine Learning ein breiterer Begriff, der verschiedene Algorithmen und Techniken umfasst, um Computermodelle zu erstellen, die aus Daten lernen und Vorhersagen treffen können. Deep Learning ist also eine Teilmenge des Machine Learning. **
-
Ist AWS der Standard im Machine Learning?
AWS ist einer der führenden Anbieter von Cloud-Computing-Diensten, einschließlich Machine Learning. Es bietet eine breite Palette von ML-Diensten und Tools wie Amazon SageMaker und Amazon Rekognition, die von vielen Unternehmen genutzt werden. Obwohl AWS als Standard angesehen werden kann, gibt es auch andere Anbieter wie Google Cloud und Microsoft Azure, die ebenfalls starke ML-Funktionen bieten. Die Wahl des richtigen Anbieters hängt von den spezifischen Anforderungen und Präferenzen des Unternehmens ab. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.