Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Fehler-Behandlung
Top-Angebote
Produkte zum Begriff Fehler-Behandlung:
-
Was ist der Fehler "Java Virtual Machine Launcher"?
Der Fehler "Java Virtual Machine Launcher" tritt auf, wenn die Java Virtual Machine (JVM) nicht gestartet werden kann. Dies kann verschiedene Ursachen haben, wie zum Beispiel eine fehlerhafte Java-Installation, eine falsche Konfiguration der JVM-Parameter oder ein Konflikt mit anderen Programmen auf dem Computer. Um den Fehler zu beheben, sollte man zunächst sicherstellen, dass Java korrekt installiert ist und die neueste Version verwendet wird. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
Was sind mögliche Konsequenzen, wenn bei einer medizinischen Behandlung ein Fehler passiert?
Mögliche Konsequenzen sind gesundheitliche Schäden beim Patienten, rechtliche Konsequenzen für den behandelnden Arzt oder das medizinische Personal und finanzielle Belastungen durch Schadensersatzforderungen oder Gerichtskosten. Es kann auch zu einem Vertrauensverlust des Patienten in das Gesundheitssystem oder den behandelnden Arzt kommen. In schwerwiegenden Fällen kann ein Behandlungsfehler sogar zum Tod des Patienten führen. **
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Top-Angebote
Produkte zum Begriff Fehler-Behandlung:
-
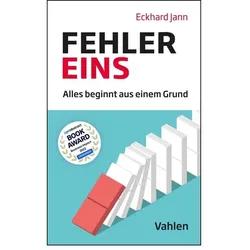
Fehler Eins, Fachbücher von Eckhard JannVorteil des Buches ist, dass es erklärt, warum wir uns oft irrational verhalten und Fehler machen. Es zeigt, was getan werden muss, um trotz unserer Unzulänglichkeiten ein sicheres Leben führen zu können. Der Leser lernt, wie man die richtigen Schlüsse aus Fehlern zieht und ungeahnte Potenziale für Verbesserungen nutzt. Zudem wird vermittelt, wie Fehlerketten unterbrochen werden können, um gravierende Fehlentscheidungen oder Unfälle zu verhindern. Das Buch erläutert, was eine echte Fehlerkultur ausmacht und wie man sie aufbaut. In einer komplexen Welt haben Fehler oft gravierende Auswirkungen. "Fehler Eins" hilft dem Leser, sein Umfeld, privat wie auch beruflich, sicherer zu gestalten. Wir ärgern uns über unsere Fehlentscheidungen und unser Fehlverhalten. Das Buch öffnet die Augen, warum wir in vielen Fällen nichts dafür können, sondern als Opfer der Umstände am Ende der Fehlerkette stehen. "Fehler Eins" ist sofort eingängig und nachvollziehbar. Es gibt weltweit kein Buch mit diesem Ansatz. Es ist praxisnah, aktuell und unterhaltsam. Der Leser lernt systematisch, Fehlerketten zu erkennen, um Fehlentscheidungen und sogar Unfälle zu verhindern. Zum Werk Wir Menschen machen Fehler. Das war schon vor 2000 Jahren der Fall, als es im alten Rom hiess "errare humanum est", Irren ist menschlich. Das ist auch heute noch so und wird immer so bleiben, egal was wir tun. Dieses Buch zeigt Ihnen, wie Unfälle entstehen, warum wir Fehler machen und warum wir uns so schwer tun, die richtigen Schlussfolgerungen daraus zu ziehen. Es gibt kein vergleichbares Buch, welches die Aspekte von Sicherheitsmanagement, Psychologie, Fehlertheorie und Untersuchungsmethoden zusammenbringt und anschaulich beschreibt. Es ist das erste Buch, welches sich methodisch mit der Analyse und Bewertung von Fehlern und Fehlerketten auseinandersetzt. Alle modernen Erkenntnisse aus der Untersuchung von Vorfällen fliessen in dieses Buch mit ein. Das Buch liefert viele Hintergründe, anschauliche Beispiele und unterhaltsame Anekdoten. Zielgruppe Da.26,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was ist der Fehler "Java Virtual Machine Launcher"?
Der Fehler "Java Virtual Machine Launcher" tritt auf, wenn die Java Virtual Machine (JVM) nicht gestartet werden kann. Dies kann verschiedene Ursachen haben, wie zum Beispiel eine fehlerhafte Java-Installation, eine falsche Konfiguration der JVM-Parameter oder ein Konflikt mit anderen Programmen auf dem Computer. Um den Fehler zu beheben, sollte man zunächst sicherstellen, dass Java korrekt installiert ist und die neueste Version verwendet wird. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
Ähnliche Suchbegriffe für Fehler-Behandlung
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Was sind mögliche Konsequenzen, wenn bei einer medizinischen Behandlung ein Fehler passiert?
Mögliche Konsequenzen sind gesundheitliche Schäden beim Patienten, rechtliche Konsequenzen für den behandelnden Arzt oder das medizinische Personal und finanzielle Belastungen durch Schadensersatzforderungen oder Gerichtskosten. Es kann auch zu einem Vertrauensverlust des Patienten in das Gesundheitssystem oder den behandelnden Arzt kommen. In schwerwiegenden Fällen kann ein Behandlungsfehler sogar zum Tod des Patienten führen. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.