Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Falsche
Top-Angebote
Produkte zum Begriff Falsche:
-
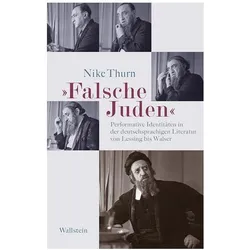
»Falsche Juden«, Fachbücher von Nike ThurnDas Fachbuch „Falsche Juden“ von Nike Thurn bietet eine tiefgehende Analyse der kulturellen Zuschreibungen und Identitäten, die mit dem Begriff „typisch jüdisch“ verbunden sind. Thurn untersucht, wie in der deutschsprachigen Literatur Figuren dargestellt werden, die entweder eine jüdische Identität vortäuschen oder fälschlicherweise als Juden angesehen werden. Durch die Analyse von fünf paradigmatischen Textpaaren, die verschiedene Epochen und Perspektiven abdecken, wird erörtert, wie sich die Darstellungen von jüdischen Identitäten vor und nach 1945 unterscheiden. Die Studie beleuchtet die Rolle von Stereotypen und hinterfragt, ob diese durch die literarische Auseinandersetzung perpetuiert oder unterlaufen werden. Thurns Werk ist eine fundierte Auseinandersetzung mit den komplexen Fragen der Identität und der kulturellen Zuschreibungen, die in der Literatur reflektiert werden.49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Falsche Fährten, Fachbücher von Peter RadelfingerDinge einander anzunähern, die nicht dafür geschaffen sind - die Fusionierung und Aktualisierung von Bild und Text, von Text und Bild, von Bild und Bild, von Text und Text zu unwahrscheinlichen Montagen, bildet die Grundlage und Strategie von falsche Fährten: eine rohe Zusammenstellung, eine irreführende Einfachheit. Zitat ist etwas, was ich schon immer hasste. Meiner Ansicht nach darf man niemals Zitate bringen. Es ist erbärmlich, pedantisch, primitiv; man wirkt wie einer, der eines Tages etwas gelesen hat, es gut findet und das zeigen will. Ich bin - so scheint mir - ein Idiot. Ein Idiot, zuerst der alten Garde, der - höchst naiv oder gar peinlich - durch sich selbst, durch ein langjähriges, ordentliches Sammeln von Texten und Bildern, das Wahre, das Vernünftige sucht und in der Folge allmählich zu einem neuen Idioten mutiert, der das Absurde und Komische als höchste Macht des Denkens.70,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Edition Spielwiese Falsche Schlangen - deutsch 302927Ihr versucht gemeinsam alle Karten in der Tischmitte umzudrehen. Zu Beginn herrscht dort tiefste Nacht und mit jeder umgedrehten Karte rückt langsam der ... 1 x Falsche Schlangen - deutsch Sprache: deutsche Version Anleitung in: Typ: Karten14,39 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter


-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie kann man in der C-Programmierung eine falsche Eingabe abfangen?
Um eine falsche Eingabe in der C-Programmierung abzufangen, kann man beispielsweise die Funktion scanf() verwenden, um die Eingabe des Benutzers einzulesen. Anschließend kann man überprüfen, ob die Eingabe den erwarteten Datentyp oder Wertebereich erfüllt. Falls die Eingabe nicht korrekt ist, kann man den Benutzer auffordern, eine gültige Eingabe zu machen oder das Programm beenden. **
Top-Angebote
Produkte zum Begriff Falsche:
-
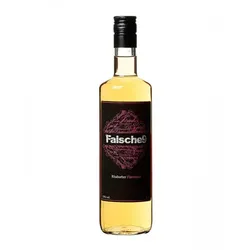
Falsche 9 RhabarberlikörFalsche 9 Rhabarberlikör Handwerkliche Perfektion und fruchtige Frische auf edlem Obstbrand In der Welt der feinen Spirituosen gibt es Entdeckungen die durch ihre unkonventionelle Art und kompromisslose Qualität sofort fesseln. Der Rhabarberlikör Falsche 9 ist genau solch eine Rarität. Entstanden aus der Leidenschaft eines visionären Erzeugers der die Grenzen zwischen traditioneller Destillationskunst und moderner Genusskultur fließend auslotet bricht diese Kreation mit klassischen Mustern....11,89 €*Versand: 13,00 €Sichere Weiterleitung zum Anbieter
-
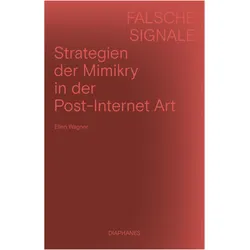
Falsche Signale, Fachbücher von Ellen WagnerSeit der 9. Berlin Biennale für zeitgenössische Kunst wird die Post-Internet Art nicht mehr bloss als „einfallslos“, sondern als geradezu „gefährlich“ eingestuft. Diese Kunst, so ihre Kritiker, stehe im Pakt mit dem Neoliberalismus und verhalte sich mutwillig verantwortungslos, d.h. offensiv unkritisch zu den standardisierten Bildsprachen von Marketing und Social Media. Statt sie jedoch als Ansammlung flacher Zitate kommerzieller Bilder zu verurteilen oder sie in einer Linie mit allegorischen Strategien der Appropriation als „kritisch“ zu legitimieren, geht es in dieser Untersuchung um den Zwischenraum von Affirmation und Kritik. Dieser wird anhand der Figur der Mimikry ausgemessen. Anders als allegorische Strategien zielt Mimikry nicht auf direkte Umwertung einzelner Bilder, sondern lässt durch die Erfüllung kapitalistischer Klischees und Normen hindurch deren Bruchbarkeit erkennen und kann eine minimale Umlenkung des Blicks initiieren.30,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
»Falsche Juden«, Fachbücher von Nike ThurnDas Fachbuch „Falsche Juden“ von Nike Thurn bietet eine tiefgehende Analyse der kulturellen Zuschreibungen und Identitäten, die mit dem Begriff „typisch jüdisch“ verbunden sind. Thurn untersucht, wie in der deutschsprachigen Literatur Figuren dargestellt werden, die entweder eine jüdische Identität vortäuschen oder fälschlicherweise als Juden angesehen werden. Durch die Analyse von fünf paradigmatischen Textpaaren, die verschiedene Epochen und Perspektiven abdecken, wird erörtert, wie sich die Darstellungen von jüdischen Identitäten vor und nach 1945 unterscheiden. Die Studie beleuchtet die Rolle von Stereotypen und hinterfragt, ob diese durch die literarische Auseinandersetzung perpetuiert oder unterlaufen werden. Thurns Werk ist eine fundierte Auseinandersetzung mit den komplexen Fragen der Identität und der kulturellen Zuschreibungen, die in der Literatur reflektiert werden.49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Falsche Fährten, Fachbücher von Peter RadelfingerDinge einander anzunähern, die nicht dafür geschaffen sind - die Fusionierung und Aktualisierung von Bild und Text, von Text und Bild, von Bild und Bild, von Text und Text zu unwahrscheinlichen Montagen, bildet die Grundlage und Strategie von falsche Fährten: eine rohe Zusammenstellung, eine irreführende Einfachheit. Zitat ist etwas, was ich schon immer hasste. Meiner Ansicht nach darf man niemals Zitate bringen. Es ist erbärmlich, pedantisch, primitiv; man wirkt wie einer, der eines Tages etwas gelesen hat, es gut findet und das zeigen will. Ich bin - so scheint mir - ein Idiot. Ein Idiot, zuerst der alten Garde, der - höchst naiv oder gar peinlich - durch sich selbst, durch ein langjähriges, ordentliches Sammeln von Texten und Bildern, das Wahre, das Vernünftige sucht und in der Folge allmählich zu einem neuen Idioten mutiert, der das Absurde und Komische als höchste Macht des Denkens.70,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Falsche
-
Edition Spielwiese Falsche Schlangen - deutsch 302927Ihr versucht gemeinsam alle Karten in der Tischmitte umzudrehen. Zu Beginn herrscht dort tiefste Nacht und mit jeder umgedrehten Karte rückt langsam der ... 1 x Falsche Schlangen - deutsch Sprache: deutsche Version Anleitung in: Typ: Karten14,39 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie kann man in der C-Programmierung eine falsche Eingabe abfangen?
Um eine falsche Eingabe in der C-Programmierung abzufangen, kann man beispielsweise die Funktion scanf() verwenden, um die Eingabe des Benutzers einzulesen. Anschließend kann man überprüfen, ob die Eingabe den erwarteten Datentyp oder Wertebereich erfüllt. Falls die Eingabe nicht korrekt ist, kann man den Benutzer auffordern, eine gültige Eingabe zu machen oder das Programm beenden. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.