Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **

Ähnliche Suchbegriffe für Erworben
Top-Angebote
Produkte zum Begriff Erworben:
-
Erworben · Besessen · Vertan, Fachbücher von Hans Georg Hiller von Gaertringen, Katrin Hiller von Gaertringen, Fried KiechleDas Buch "Erworben · Besessen · Vertan" von Fried Kiechle beleuchtet die komplexe Geschichte eines bedeutenden Kunstwerks von Ernst Ludwig Kirchner, das aus der Sammlung des jüdischen Schuhfabrikanten Alfred Hess stammt. Es thematisiert die kulturellen und historischen Spannungen, die mit der Hergabe von Kirchners Berliner Strassenszene verbunden sind, und stellt den schicksalhaften Weg des Kunstwerks in den Kontext des Niedergangs der Familie Hess. Durch eine detaillierte Dokumentation wird der Leser in die vielschichtige Thematik der Kunstsammlung und deren Verlust während der Weimarer Republik eingeführt. Das Buch bietet nicht nur einen tiefen Einblick in die Kunstgeschichte, sondern auch in die gesellschaftlichen Umstände, die zu den Konflikten um das Kunstwerk führten.45,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **


Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff Erworben:
-
Brinkmann:Altmeister-Gemälde erworben f, Fachbücher von Bodo BrinkmannDas Buch "Altmeister-Gemälde erworben für das Kunstmuseum Basel 2008-2024" von Bodo Brinkmann bietet einen tiefen Einblick in die Kunstgeschichte und die Sammlungspolitik des Kunstmuseums Basel. In diesem Erinnerungsbuch werden bedeutende Werke von Künstlern wie Lucas Cranach d. Ä., Angelika Kauffmann und der Malerfamilie Holbein vorgestellt. Brinkmann, der als Konservator tätig war, schildert die Hintergründe der Erwerbungen, insbesondere die grosszügigen Schenkungen, und gewährt den Lesern spannende Einblicke in die Abläufe des Museumsbetriebs. Das Buch kombiniert sorgfältig dokumentierte Kunstgeschichte mit unterhaltsamen Anekdoten und bietet durch grossformatige Abbildungen eine visuelle Würdigung der Altmeister-Gemälde. Es ist ein unverzichtbares Werk für Kunstliebhaber und Interessierte an der Geschichte des Kunstmuseums Basel.34,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
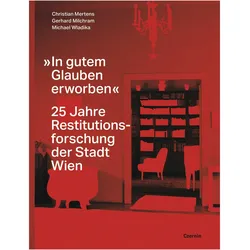
»In gutem Glauben erworben«, Fachbücher von Christian Mertens, Michael Wladika, Gerhard MilchramSeit 25 Jahren gibt es das Kunstrückgabegesetz in Österreich. Ein guter Zeitpunkt, um Bilanz zu ziehen: über erfolgte und nicht erfolgte Rückgaben, über die Provenienzforschung der Stadt Wien und über ungeklärte Restitutionsfälle. Während der NS-Herrschaft wurden tausende Kunstgegenstände geraubt, gestohlen oder bei Flucht und Deportation zurückgelassen. Sie befinden sich heute unter anderem in den Museen und Sammlungen der Stadt Wien, die sie unrechtmässig erworben haben. Ihre Rückgabe stellt die Forschung vor grosse Herausforderungen: Abseits der spektakulären Restitutionsfälle besitzt die Stadt Raubgut aus der breiten Gesellschaftsschicht. Ihre Provenienz muss minutiös erforscht, die rechtmässigen Erb:innen gefunden werden. „In gutem Glauben erworben“ stellt nicht nur 73 Restitutionsfälle und die 25-jährige Arbeit der Provenienzforschung des Wien Museums vor. Der Katalog bietet einen tiefen Einblick in die Abläufe der Beraubung der jüdischen Bevölkerung, stellt historische Eckpunkte dar und zeigt auf eindrückliche Weise zugleich einen wesentlichen Teil der Wiener Sozial- und Kulturgeschichte der ersten Hälfte des 20. Jahrhunderts. Mit Beiträgen von: Gabriele Anderl, Julia Essl, Konstantin Ferihumer, Lisa Frank, Walter Hellmich, Gertrude und Craig Klinkhoff, Christian Klösch, Gabriele Kohlbauer, Stefan Kurz, Sabine Loitfellner, Monika Löschner, Christian Mertens, Gerhard Milchram, Pia Schölnberger, Julia Unterweger, Leonhard Weidinger, Michael Wladika, August Zirner.40,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Erworben · Besessen · Vertan, Fachbücher von Hans Georg Hiller von Gaertringen, Katrin Hiller von Gaertringen, Fried KiechleDas Buch "Erworben · Besessen · Vertan" von Fried Kiechle beleuchtet die komplexe Geschichte eines bedeutenden Kunstwerks von Ernst Ludwig Kirchner, das aus der Sammlung des jüdischen Schuhfabrikanten Alfred Hess stammt. Es thematisiert die kulturellen und historischen Spannungen, die mit der Hergabe von Kirchners Berliner Strassenszene verbunden sind, und stellt den schicksalhaften Weg des Kunstwerks in den Kontext des Niedergangs der Familie Hess. Durch eine detaillierte Dokumentation wird der Leser in die vielschichtige Thematik der Kunstsammlung und deren Verlust während der Weimarer Republik eingeführt. Das Buch bietet nicht nur einen tiefen Einblick in die Kunstgeschichte, sondern auch in die gesellschaftlichen Umstände, die zu den Konflikten um das Kunstwerk führten.45,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Erworben
-
Grundkurs Machine Learning, Fachbücher von Paul WilmottMaschinelles Lernen – alle Grundlagen! Paul Wilmott ist für seine erhellende und unterhaltsame Darstellung angewandter Mathematik bekannt. Von der linearen Regression bis zu neuronalen Netzwerken führt er Sie durch alle Verfahren, und zwar komplett software-unabhängig. Der Vorteil dabei: Jeder Schritt ist schwarz auf weiss zu sehen, kein Framework kann etwas „verstecken“, es geht immer um die Sache selbst. Mit vielen Beispielen, Grafiken und Schritt-für-Schritt-Kästen. Für alle, die wirklich verstehen wollen, wie Maschinen lernen. Aus dem Inhalt: lineare Regression, k-nearest neighbors, naive Bayes-Klassifikatoren, k-Means-Algorithmus, Support Vector Machines, logistische Regression, selbstorganisierende Karten, Entscheidungsbäume, Reinforcement Learning, neuronale Netze.29,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning Kochbuch, Fachbücher von Chris AlbonPython-Programmierer finden in diesem Kochbuch nahezu 200 wertvolle und jeweils in sich abgeschlossene Anleitungen zu Aufgabenstellungen aus dem Bereich des Machine Learning, wie sie für die tägliche Arbeit typisch sind – von der Vorverarbeitung der Daten bis zum Deep Learning. Entwickler, die mit Python und seinen Bibliotheken einschliesslich Pandas und Scikit-Learn vertraut sind, werden spezifische Probleme erfolgreich bewältigen – wie etwa Daten laden, Text und numerische Daten behandeln, Modelle auswählen, Dimensionalität reduzieren und vieles mehr. Jedes Rezept enthält Code, den Sie kopieren, zum Testen in eine kleine Beispieldatenmenge einfügen und dann anpassen können, um Ihre eigenen Anwendungen zu konstruieren. Darüber hinaus werden alle Lösungen diskutiert und wichtige Zusammenhänge hergestellt. Dieses Kochbuch unterstützt Sie dabei, den Schritt von der Theorie und den Konzepten hinein in die Praxis zu machen. Es liefert das praktische Rüstzeug, das Sie benötigen, um funktionierende Machine-Learning-Anwendungen zu entwickeln. In diesem Kochbuch finden Sie Rezepte für: - Vektoren, Matrizen und Arrays - den Umgang mit numerischen und kategorischen Daten, Texten, Bildern sowie Datum und Uhrzeit - das Reduzieren der Dimensionalität durch Merkmalsextraktion oder Merkmalsauswahl - Modellbewertung und -auswahl - lineare und logistische Regression, Bäume und Wälder und k-nächste Nachbarn - Support Vector Machine (SVM), naive Bayes, Clustering und neuronale Netze - das Speichern und Laden von trainierten Modellen Chris hat den Kochbuchcharakter seines Buchs genutzt, um nicht nur eine Referenz für erfahrene Profis zu bieten, sondern auch eine leicht zugängliche Reihe von kleinen Tutorials, die Anfänger schätzen werden. Dieses Buch ist eine wertvolle Ressource, egal ob man sein Wissen vor einem Vorstellungsgespräch als Data Scientist auffrischen möchte oder eine prägnante und dennoch gründliche Referenz für den Schreibtisch sucht.36,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.