Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Entzündungsmarkern
Top-Angebote
Produkte zum Begriff Entzündungsmarkern:
-
Smoke Factory Data II 2,6KW Fog MachineSmoke Factory Data II 2,6KW Fog Machine, Data II 2,6KW Fog Machine. Die neue Generation der "klassischen" Power- Nebelmaschinen. Digitale Powernebelmaschine mit zwei Pumpen. 230 V/ 2600 W. Externer Ausgang für optionalen Lüfter für max. 800 W, extrem starker Nebelausstoß, Mengenre - gulierung zwischen 1 % und 99 %. DMX, Timer und Schlauchblende serienmäßig. Dauer - nebel bei reduziertem Ausstoß. Achtung: Bitte verwenden Sie nur das original Smoke Factory Fluid. Andere Fluide führen zum Verstopfen des Gerätes und ein GARANTIE Anspruch erlischt in diesem Fall!1225,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **

Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff Entzündungsmarkern:
-
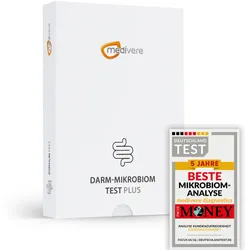
Darm-Mikrobiom Test Plus – Stuhltest mit Zonulin & erweiterten EntzündungsmarkernDarm-Mikrobiom Test Plus – Stuhltest inklusive Zonulin Ein gesunder Darm ist für dein Wohlbefinden von großer Bedeutung – Abwehrkräfte, Stoffwechsel und viele weitere Körperfunktionen hängen eng mit der Gesundheit deiner Verdauungsorgane zusammen. Mit diesem erweiterten Test erfährst du mittels DNA-Sequenzierung sowie mikrobiologischer und laborchemischer Verfahren mehr über deine Darmflora – ergänzt um Zonulin als Hinweis auf eine mögliche erhöhte Durchlässigkeit der Darmschleimhaut (Leaky-Gut). Dieser Test ist sinnvoll bei chronischer Verstopfung, länger anhaltendem Durchfall, Bauchschmerzen, Blähbauch oder Reizdarm, bei chronisch-entzündlichen Erkrankungen wie Morbus Crohn, bei Verdacht auf ein Leaky-Gut-Syndrom sowie zur allgemeinen Überprüfung deiner Darmgesundheit. Warum ist dieser Test sinnvoll? Neben der molekulargenetischen Analyse deines Mikrobioms per Next-Generation-Sequenzierung liefert dieser Test zusätzliche mikrobiologische und laborchemische Parameter. So erhältst du nicht nur einen Überblick über die Zusammensetzung deiner Darmflora, sondern auch Hinweise auf Entzündungsprozesse, die Verdauungsleistung sowie die Barrierefunktion deiner Darmschleimhaut. Das wird analysiert Molekulargenetische Mikrobiom-Analyse (DNA-Sequenzierung) Biodiversität (Shannon-Index) – Vielfalt der Mikroorganismen als Basis für ein stabiles Gleichgewicht Firmicutes/Bacteroidetes-Ratio Butyratproduktion (u. a. Faecalibacterium prausnitzii, Eubacterium spp., Roseburia spp.) Mucindegradation (u. a. Akkermansia muciniphila, Prevotella-Spezies) pH-Wert, Laktat-, Acetat- & Propionatproduktion Prevotella spp./Bacteroides spp.-Ratio LPS-tragende Bakterien Enterotyp deiner Stuhlprobe Mikrobiologische Untersuchung Aerobe & anaerobe Leitkeime Pilze: Schimmelpilze & Hefepilze Verdauungs- & Entzündungsmarker Verdauungsrückstände α-1-Antitrypsin – Hinweis auf Entzündungsprozesse Calprotectin – Marker für Entzündungen der Darmschleimhaut Gallensäuren – relevant für die Fettverdauung Pankreas-Elastase – Hinweis auf die Funktion der Bauchspeicheldrüse Sekretorisches IgA – Teil der Schleimhautimmunität Zonulin – Marker für die Durchlässigkeit der Darmschleimhaut (Leaky-Gut) Durchführung des Tests Nach deiner Bestellung erhältst du das Testset mit allen notwendigen Materialien und einer ausführlichen Anleitung. In dieser Anleitung erfährst du detailliert, wann und wie du die Stuhlprobe entnehmen solltest. Lies dir das Dokument unbedingt vorher sorgfältig durch. Anschließend nimmst du die Probe ab und sendest sie mit dem beiliegenden vorausgefüllten Rücksendeumschlag kostenlos an unser deutsches Partnerlabor. Versende die Probe möglichst von Montag bis Donnerstag, damit sie zügig bearbeitet werden kann. Auswertung und Befund Nach etwa 14 Werktagen erhältst du einen ausführlichen und leicht verständlichen Befund, der dir aufzeigt, welche Werte im Normbereich liegen und wo Auffälligkeiten bestehen – inklusive individueller Infografiken zur Verteilung der Bakterienstämme in deinem Darm. So bekommst du einen klaren Überblick über deine persönlichen Ergebnisse. Deine Privatsphäre ist uns wichtig Die Entnahme der Probe für den Test kannst du diskret zu Hause durchführen. Wir und unser deutsches Partnerlabor, das mit der Durchführung der Analysen beauftragt wird, nehmen den Schutz deiner Daten sehr ernst. Deshalb hast du den alleinigen Zugang zu diesen Informationen. Sie werden niemals an nicht autorisierte Dritte weitergegeben. Zudem werden alle Proben unmittelbar nach der Analyse entsorgt.249,50 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Entzündungsmarkern
-
Smoke Factory Data II 2,6KW Fog MachineSmoke Factory Data II 2,6KW Fog Machine, Data II 2,6KW Fog Machine. Die neue Generation der "klassischen" Power- Nebelmaschinen. Digitale Powernebelmaschine mit zwei Pumpen. 230 V/ 2600 W. Externer Ausgang für optionalen Lüfter für max. 800 W, extrem starker Nebelausstoß, Mengenre - gulierung zwischen 1 % und 99 %. DMX, Timer und Schlauchblende serienmäßig. Dauer - nebel bei reduziertem Ausstoß. Achtung: Bitte verwenden Sie nur das original Smoke Factory Fluid. Andere Fluide führen zum Verstopfen des Gerätes und ein GARANTIE Anspruch erlischt in diesem Fall!1225,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wendougee DATA-S Dual Boiler Espresso Machine · White/SilverPrecision for your Taste. With the Wendougee DATA-S, you precisely control pressure and flow via a gear pump. Save your brewing profiles in the E-Bar app. The saturated brew group and PID control ensure a constant temperature. Two boilers and the choice between tank and direct water connection make this espresso machine the centerpiece of your coffee station. Gear pump with pressure profiling and flow-priority mode 0.8-liter brew boiler and 1.8-liter steam boiler 1.5-liter water tank or direct water connection Stainless steel casing, steam wand, and hot water spout Tablet optional, not included in standard delivery.3499,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.