Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für DDR-Repression
Top-Angebote
Produkte zum Begriff DDR-Repression:
-
Machine Learning and Big Data-enabled Biotechnology, Fachbücher von Hal S. AlperDas Fachbuch 'Machine Learning and Big Data-enabled Biotechnology' bietet eine umfassende Darstellung der Anwendung von Machine Learning und Big Data in der Biotechnologie. Es gliedert sich in drei Hauptteile, die sich jeweils auf unterschiedliche Aspekte der Biotechnologie konzentrieren. Der erste Teil widmet sich der DNA, wobei Themen von der synthetischen Biologie, wie dem Design von Promotoren, bis hin zu Vorhersagen aus Genomsequenzen behandelt werden. Im zweiten Teil liegt der Fokus auf Proteinen, wobei sowohl Struktur- und Designwerkzeuge als auch die Entdeckung von Stoffwechselwegen und Retrobiosynthese thematisiert werden. Der abschliessende Teil befasst sich mit ganzen Zellen und beleuchtet Machine Learning Ansätze zur Genexpression sowie Vorhersagen von Phänotypen und der Leistung von Bioreaktoren. Das Buch bietet somit einen breiten Überblick über die Integration moderner Datenanalysemethoden in die biotechnologische Forschung und Entwicklung. Es richtet sich an Fachleute und Studierende, die an der Schnittstelle von Biotechnologie, Datenwissenschaft und Ingenieurwesen arbeiten.135,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Hybrid Transnationalism and Repression, Fachbücher von Ihsan Yilmaz, Bulent Kenes"Hybrid Transnationalism and Repression" ist ein Fachbuch, das sich mit der Diaspora der Türkei unter dem Einfluss autoritärer islamistischer Regime auseinandersetzt. Verfasst von Bulent Kenes und Ihsan Yilmaz, bietet das Buch eine tiefgehende Analyse der sozialen und politischen Dynamiken, die die türkische Diaspora prägen. Es untersucht die Herausforderungen, denen sich diese Gemeinschaften gegenübersehen, und beleuchtet die Mechanismen der Repression, die von autoritären Regierungen ausgehen. Das Werk ist in englischer Sprache verfasst und richtet sich an Leserinnen und Leser, die sich für Sozialwissenschaften, insbesondere für die Themen Politik und Staat, interessieren. Mit 319 Seiten bietet es umfassende Einblicke in die komplexen Wechselwirkungen zwischen Transnationalismus und Repression im Kontext der türkischen Diaspora.143,30 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie lautet das Verb zur Substantivform "Repression"?
Das Verb zur Substantivform "Repression" lautet "reprimieren". Es bedeutet, jemanden oder etwas zu unterdrücken, zu unterdrücken oder zu bestrafen, insbesondere in politischem oder sozialem Kontext. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was ist der Unterschied zwischen Inhibition und Repression?
Inhibition bezieht sich auf die Hemmung oder Unterdrückung eines Verhaltens oder einer Reaktion aufgrund äußerer oder innerer Einflüsse. Repression hingegen bezieht sich auf den unbewussten Prozess der Unterdrückung von unangenehmen Gedanken, Erinnerungen oder Impulsen, um psychische Konflikte zu vermeiden. Während Inhibition eine bewusste Handlung sein kann, ist Repression ein unbewusster Abwehrmechanismus. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Top-Angebote
Produkte zum Begriff DDR-Repression:
-
Repression, Haft und Geschlecht, Fachbücher von Alexander BastianDas Fachbuch "Repression, Haft und Geschlecht" von Alexander Bastian beleuchtet die U-Haftanstalt Magdeburg-Neustadt als zentrales Instrument politischer Repression im Bezirk Magdeburg. Durch die innovative Verknüpfung von Genderforschung mit Sozial- und Kulturgeschichte eröffnet der Autor neue Perspektiven und Fragestellungen, die über die bisherigen institutionengeschichtlichen Ansätze hinausgehen. Dieses Werk ist der erste Band der Reihe "Studien zur Geschichte und Kultur Mitteldeutschlands", die herausragende Forschungsarbeiten aus den Universitäten Magdeburg, Halle und Jena präsentiert. Die umfassende Analyse der U-Haft und deren gesellschaftliche Implikationen bietet wertvolle Einblicke in die Mechanismen der politischen Verfolgung und deren Auswirkungen auf Geschlechterverhältnisse. Die detaillierte Untersuchung ist sowohl für Fachleute als auch für Interessierte an der Geschichte der politischen Repression von Bedeutung.49,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Machine Learning and Big Data-enabled Biotechnology, Fachbücher von Hal S. AlperDas Fachbuch 'Machine Learning and Big Data-enabled Biotechnology' bietet eine umfassende Darstellung der Anwendung von Machine Learning und Big Data in der Biotechnologie. Es gliedert sich in drei Hauptteile, die sich jeweils auf unterschiedliche Aspekte der Biotechnologie konzentrieren. Der erste Teil widmet sich der DNA, wobei Themen von der synthetischen Biologie, wie dem Design von Promotoren, bis hin zu Vorhersagen aus Genomsequenzen behandelt werden. Im zweiten Teil liegt der Fokus auf Proteinen, wobei sowohl Struktur- und Designwerkzeuge als auch die Entdeckung von Stoffwechselwegen und Retrobiosynthese thematisiert werden. Der abschliessende Teil befasst sich mit ganzen Zellen und beleuchtet Machine Learning Ansätze zur Genexpression sowie Vorhersagen von Phänotypen und der Leistung von Bioreaktoren. Das Buch bietet somit einen breiten Überblick über die Integration moderner Datenanalysemethoden in die biotechnologische Forschung und Entwicklung. Es richtet sich an Fachleute und Studierende, die an der Schnittstelle von Biotechnologie, Datenwissenschaft und Ingenieurwesen arbeiten.135,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Hybrid Transnationalism and Repression, Fachbücher von Ihsan Yilmaz, Bulent Kenes"Hybrid Transnationalism and Repression" ist ein Fachbuch, das sich mit der Diaspora der Türkei unter dem Einfluss autoritärer islamistischer Regime auseinandersetzt. Verfasst von Bulent Kenes und Ihsan Yilmaz, bietet das Buch eine tiefgehende Analyse der sozialen und politischen Dynamiken, die die türkische Diaspora prägen. Es untersucht die Herausforderungen, denen sich diese Gemeinschaften gegenübersehen, und beleuchtet die Mechanismen der Repression, die von autoritären Regierungen ausgehen. Das Werk ist in englischer Sprache verfasst und richtet sich an Leserinnen und Leser, die sich für Sozialwissenschaften, insbesondere für die Themen Politik und Staat, interessieren. Mit 319 Seiten bietet es umfassende Einblicke in die komplexen Wechselwirkungen zwischen Transnationalismus und Repression im Kontext der türkischen Diaspora.143,30 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Wie lautet das Verb zur Substantivform "Repression"?
Das Verb zur Substantivform "Repression" lautet "reprimieren". Es bedeutet, jemanden oder etwas zu unterdrücken, zu unterdrücken oder zu bestrafen, insbesondere in politischem oder sozialem Kontext. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
Ähnliche Suchbegriffe für DDR-Repression
-
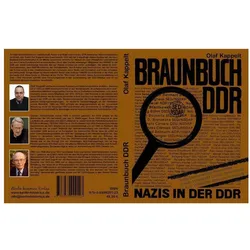
Braunbuch DDR - Nazis in der DDR, Fachbücher von Olaf KappeltAn allen Schaltstellen von Gesellschaft, Partei und Staat waren in der DDR ehemalige Nationalsozialisten vertreten. Der Autor Olaf Kappel kam ihnen bereits 1981 mit der Erstauflage dieses Buches auf die Spur. Staatssicherheitsminister Erich Mielke persönlich erklärte ihn daraufhin zum Staatsfeind und trachtete ihn durch eine Sondereinheit auszuschalten. Doch das Treiben ehemaliger Mitglieder der NSDAP in der DDR war damit keineswegs beendet. Bis zur Wende konnten sie weiter aufsteigen. Sie sassen im SED-Zentralkomitee, dem DDR-Ministerrat, der Volkskammer, den Schulen und Hochschulen, bei der Armee, der Polizei sowie in den Chefredaktionen der Zeitungen, beim Radio und Fernsehen und in der volkseigenen Wirtschaft. Einige dieser Ex-Nazis retteten Ämter und Einfluss 1989/90 durch Eintritt in die PDS und bis heute sind diese Leute im Ältestenrat der Partei Die Linke vertreten.49,80 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Unterschied zwischen Inhibition und Repression?
Inhibition bezieht sich auf die Hemmung oder Unterdrückung eines Verhaltens oder einer Reaktion aufgrund äußerer oder innerer Einflüsse. Repression hingegen bezieht sich auf den unbewussten Prozess der Unterdrückung von unangenehmen Gedanken, Erinnerungen oder Impulsen, um psychische Konflikte zu vermeiden. Während Inhibition eine bewusste Handlung sein kann, ist Repression ein unbewusster Abwehrmechanismus. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.