Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Crawl-Datenbank
Top-Angebote
Produkte zum Begriff Crawl-Datenbank:
-
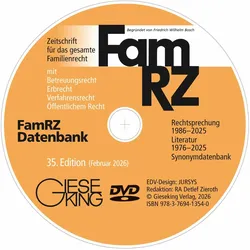
Various Publishers, Zeitschriften Abo, FamRZ DatenbankDie FamRZ Datenbank bietet ein umfassendes Zeitschriften-Abo, das sich auf das Familienrecht spezialisiert hat. Dieses Produkt liefert den Volltext der letzten 39 Jahrgänge der renommierten Zeitschrift FamRZ, die sich mit Betreuungsrecht, Erbrecht, Verfahrensrecht und öffentlichem Recht auseinandersetzt. Die Datenbank ist auf DVD verfügbar und ermöglicht den Zugriff auf eine authentische Sammlung juristischer Fachinformationen. Dank der eingehenden Verschlagwortung und einer Synonymdatenbank können Nutzer schnell und präzise relevante Informationen finden. Die komfortablen Suchfunktionen erleichtern die Navigation durch die umfangreichen Inhalte, während die Offline-Verfügbarkeit eine unabhängige Nutzung ohne Internetzugang ermöglicht. Die FamRZ Datenbank ist technisch sicher und stets nachhaltig verfügbar, was sie zu einer zuverlässigen Ressource für Fachleute im Familienrecht macht. Dieses Produkt bietet eine einzigartige Kombination aus historischer Tiefe und moderner Suchtechnologie, die den Zugang zu juristischen Informationen effizient und benutzerfreundlich gestaltet.279,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
ABB ITS-DR-CSV Driver, CSV Datenbank2CQG150502S4061 ITS-DR-CSV Der Treiber ITS-DR-CSV wird für die Einbindung von CSV Datenbanken benutzt. Dieser Treiber benötigt als Voraussetzung mindestens eine Grundvariante vom Integra Supervisor (IST-XXX-SUP).1491,75 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter
-
ABB ITS-DR-MYSQL Driver, MySQL Datenbank2CQG150503S4061 ITS-DR-MYSQL Der Treiber ITS-DR-MYSQL wird für die Einbindung von MySQL Datenbanken benutzt. Dieser Treiber benötigt als Voraussetzung mindestens eine Grundvariante vom Integra Supervisor (IST-XXX-SUP).1491,75 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter



-
Was ist der Unterschied zwischen einer Datenbank und einem Data Warehouse?
Eine Datenbank ist eine strukturierte Sammlung von Daten, die für den täglichen Betrieb eines Unternehmens verwendet wird. Sie dient der Speicherung, Verwaltung und Abfrage von Daten. Ein Data Warehouse ist hingegen eine spezielle Art von Datenbank, die große Mengen an Daten aus verschiedenen Quellen sammelt, integriert und für Analysen und Berichterstattung optimiert. Es dient dazu, Daten aus verschiedenen Quellen zu konsolidieren und eine einheitliche Sicht auf die Daten zu ermöglichen. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **


Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Top-Angebote
Produkte zum Begriff Crawl-Datenbank:
-
Various Publishers, Zeitschriften Abo, FamRZ DatenbankDie FamRZ Datenbank bietet ein umfassendes Zeitschriften-Abo, das sich auf das Familienrecht spezialisiert hat. Dieses Produkt liefert den Volltext der letzten 39 Jahrgänge der renommierten Zeitschrift FamRZ, die sich mit Betreuungsrecht, Erbrecht, Verfahrensrecht und öffentlichem Recht auseinandersetzt. Die Datenbank ist auf DVD verfügbar und ermöglicht den Zugriff auf eine authentische Sammlung juristischer Fachinformationen. Dank der eingehenden Verschlagwortung und einer Synonymdatenbank können Nutzer schnell und präzise relevante Informationen finden. Die komfortablen Suchfunktionen erleichtern die Navigation durch die umfangreichen Inhalte, während die Offline-Verfügbarkeit eine unabhängige Nutzung ohne Internetzugang ermöglicht. Die FamRZ Datenbank ist technisch sicher und stets nachhaltig verfügbar, was sie zu einer zuverlässigen Ressource für Fachleute im Familienrecht macht. Dieses Produkt bietet eine einzigartige Kombination aus historischer Tiefe und moderner Suchtechnologie, die den Zugang zu juristischen Informationen effizient und benutzerfreundlich gestaltet.279,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was ist der Unterschied zwischen einer Datenbank und einem Data Warehouse?
Eine Datenbank ist eine strukturierte Sammlung von Daten, die für den täglichen Betrieb eines Unternehmens verwendet wird. Sie dient der Speicherung, Verwaltung und Abfrage von Daten. Ein Data Warehouse ist hingegen eine spezielle Art von Datenbank, die große Mengen an Daten aus verschiedenen Quellen sammelt, integriert und für Analysen und Berichterstattung optimiert. Es dient dazu, Daten aus verschiedenen Quellen zu konsolidieren und eine einheitliche Sicht auf die Daten zu ermöglichen. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
Ähnliche Suchbegriffe für Crawl-Datenbank
-
ABB ITS-DR-CSV Driver, CSV Datenbank2CQG150502S4061 ITS-DR-CSV Der Treiber ITS-DR-CSV wird für die Einbindung von CSV Datenbanken benutzt. Dieser Treiber benötigt als Voraussetzung mindestens eine Grundvariante vom Integra Supervisor (IST-XXX-SUP).1491,75 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter
-
ABB ITS-DR-MYSQL Driver, MySQL Datenbank2CQG150503S4061 ITS-DR-MYSQL Der Treiber ITS-DR-MYSQL wird für die Einbindung von MySQL Datenbanken benutzt. Dieser Treiber benötigt als Voraussetzung mindestens eine Grundvariante vom Integra Supervisor (IST-XXX-SUP).1491,75 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter
-
Baumeister, Inge: Access für Einsteiger - Schritt für Schritt zur DatenbankAccess für Einsteiger - Schritt für Schritt zur Datenbank , Die verständliche Anleitung für die Versionen 2024, 2021 & Microsoft 365 , Servopumpen > Sportfederung , Erscheinungsjahr: 20220316, Produktform: Kartoniert, Autoren: Baumeister, Inge, Seitenzahl/Blattzahl: 450, Keyword: 2010; 2013; 2016; 2019; 2021; 365; Access; Datenbank; MS-Access; Microsoft; Microsoft-Access, Fachschema: Access 2016~Datenbank / Relational~Datenverarbeitung / Anwendungen / Betrieb, Verwaltung, Fachkategorie: Unternehmensanwendungen, Warengruppe: HC/Anwendungs-Software, Fachkategorie: Relationale Datenbanken, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: BILDNER Verlag, Verlag: BILDNER Verlag, Verlag: BILDNER Verlag, Länge: 239, Breite: 188, Höhe: 29, Gewicht: 926, Produktform: Kartoniert, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Vorgänger: 2026948, Vorgänger EAN: 9783832803896 9783832801748, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0018, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,34,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wilmott, Paul: Grundkurs Machine LearningGrundkurs Machine Learning , Aus der Buchreihe »Informatik verstehen«. Ideal zum Selbststudium , Querlenker > Sportfederung , Erscheinungsjahr: 20200724, Produktform: Kartoniert, Titel der Reihe: Rheinwerk Computing##, Autoren: Wilmott, Paul, Seitenzahl/Blattzahl: 256, Themenüberschrift: COMPUTERS / General, Keyword: Hand-Buch Bücher lernen Studium Grundlagen Kurse Workshops Tutorials Wissen Anleitung Training Ausbildung; Robotik; Informatik verstehen; Programmierung programmieren; KI-Welt AI; Künstliche Intelligenz; Software-Entwicklung; Coder Coden; Neuronale Netze; Deep Learning; Mathematik, Fachschema: Informatik~Programmiersprachen~EDV / Theorie / Allgemeines, Fachkategorie: Informatik~Informationstechnik (IT), allgemeine Themen, Sprache: Deutsch, Warengruppe: HC/Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Länge: 228, Breite: 175, Höhe: 17, Gewicht: 480, Produktform: Klappenbroschur, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 232715029,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.