Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Code-Set
Top-Angebote
Produkte zum Begriff Code-Set:
-
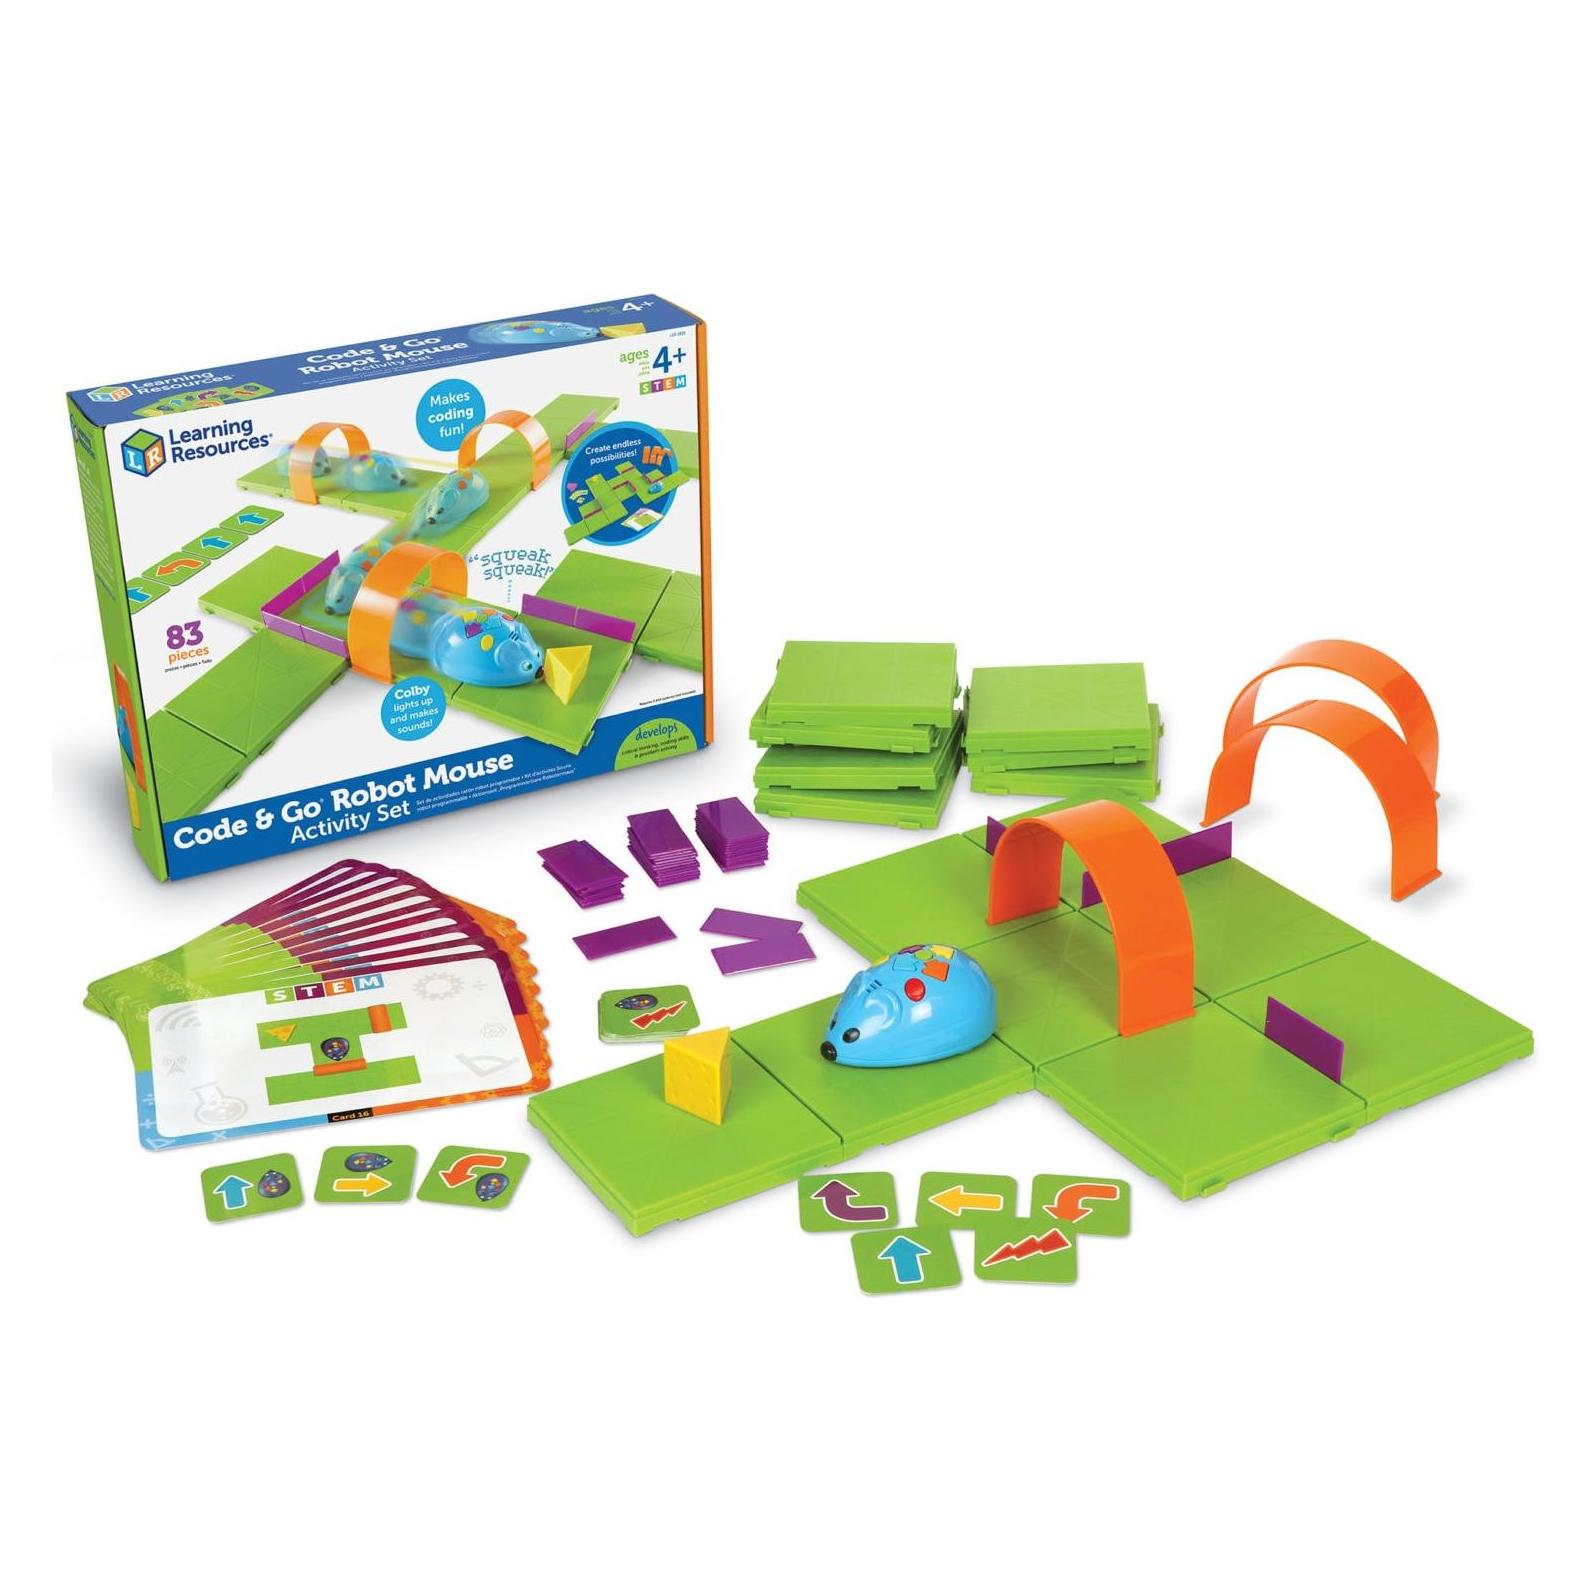
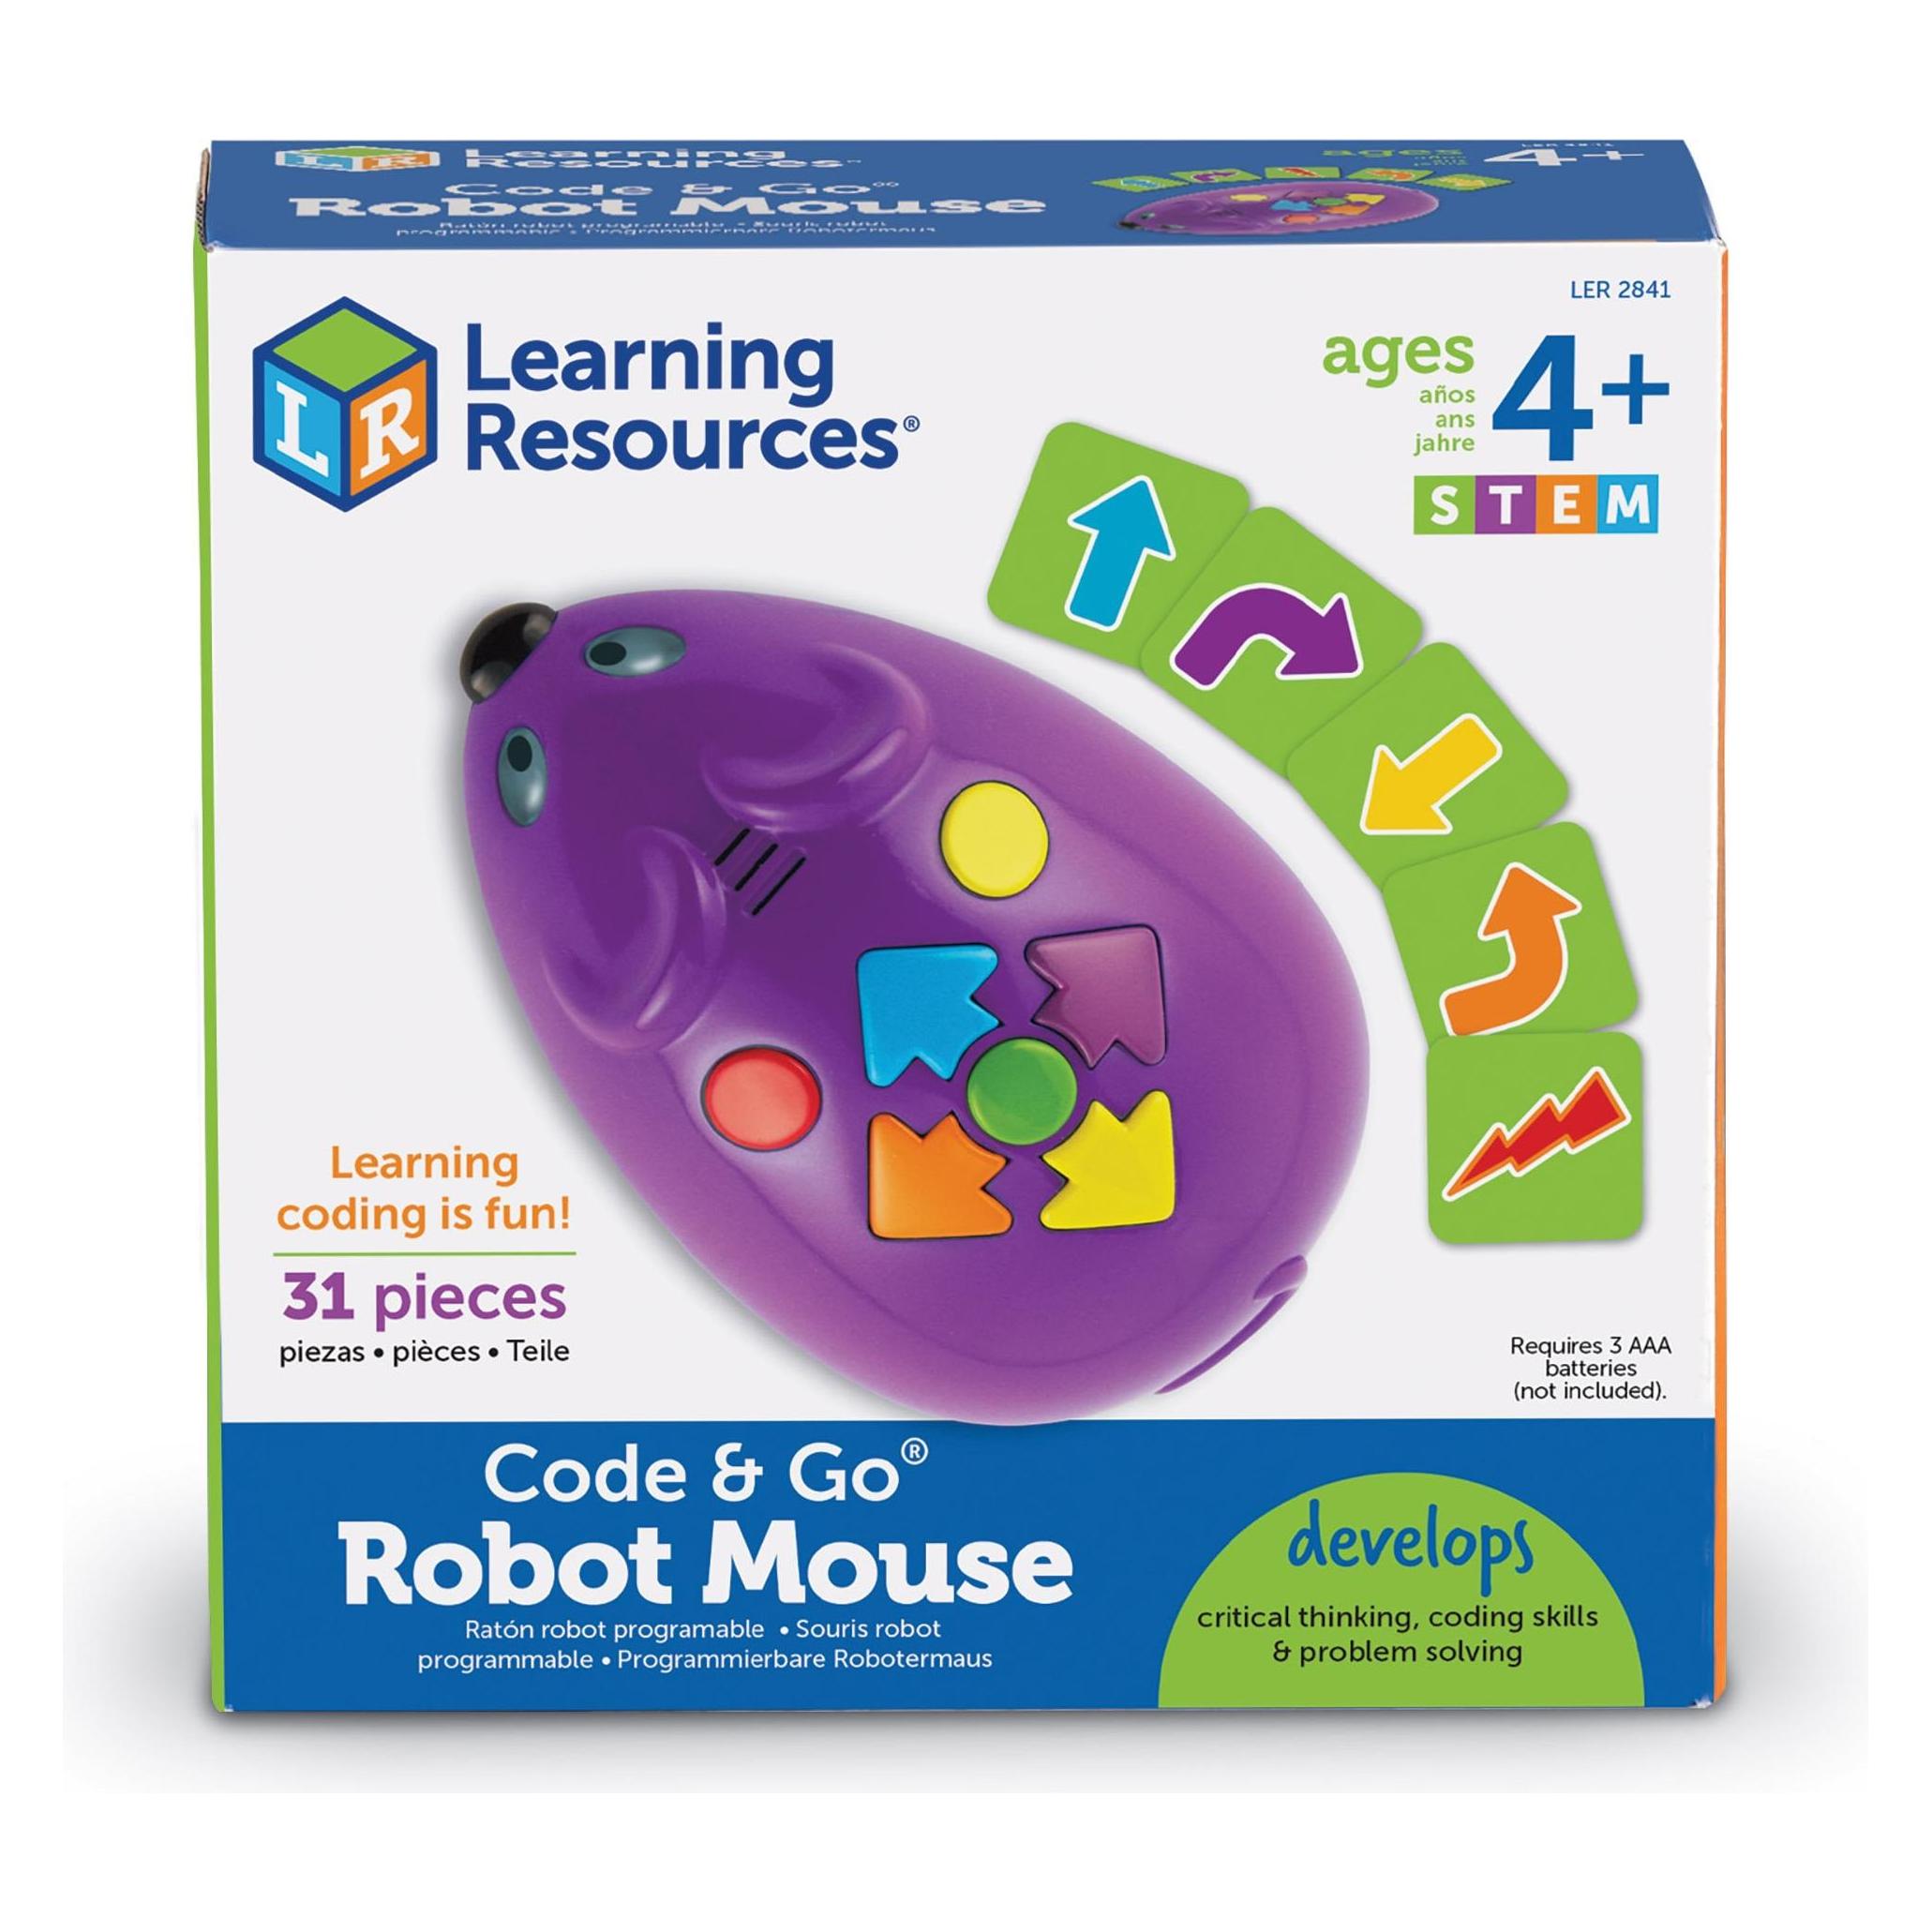
Learning Resources Code & Go, Robotik Kit, MehrfarbigFühren Sie Ihr Kind mit dem Code & Go® Robot Mouse Activity Set in die spannende Welt der MINT-Fächer ein. Dieses ansprechende und farbenfrohe Set wurde speziell entwickelt, um Grundschüler in die Bereiche Wissenschaft, Technologie, Technik und Mathematik einzuführen. Mit Colby, der Robotermaus, können junge Menschen die grundlegenden Konzepte des Programmierens spielerisch erkunden. Kinder werden ihre Freude daran haben, Colby so zu programmieren, dass er durch verschiedene Labyrinthe navigiert, um den Käse zu erreichen. Das Set enthält 16 Gitterteile, 22 Labyrinthwände, 3 Tunnelteile, 30 doppelseitige Kodierkarten, 10 doppelseitige Labyrinth-Aktivitätskarten, ein Käsestück aus Plastik und eine Anleitung, die endlose Möglichkeiten für kreative Problemlösungen und Lernen bietet. Colby ist 10 cm lang und benötigt 3 AAA-Batterien (nicht im Lieferumfang enthalten). Dieses Lernspielzeug ist für Kinder ab 4 Jahren geeignet und ist somit ein perfektes Geschenk, um das Interesse an MINT zu wecken.76,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Gibt es alte Louis Vuitton Taschen ohne Data Code?
Ja, es gibt alte Louis Vuitton Taschen, die keinen Data Code haben. Der Data Code wurde erst ab den 1980er Jahren eingeführt, daher können ältere Taschen davor keinen haben. Es ist jedoch wichtig zu beachten, dass das Fehlen eines Data Codes nicht unbedingt bedeutet, dass die Tasche gefälscht ist, da es viele andere Faktoren gibt, die bei der Authentifizierung einer Louis Vuitton Tasche berücksichtigt werden sollten. **
-
Was ist der Data Code von Louis Vuitton 2?
Es tut mir leid, aber ich kann keinen spezifischen Data Code für Louis Vuitton 2 finden. Der Data Code ist normalerweise eine Kombination aus Buchstaben und Zahlen, die in Louis Vuitton-Produkten eingestanzt sind und Informationen über das Herstellungsdatum und den Produktionsort geben. Es ist möglich, dass es verschiedene Data Codes für verschiedene Produkte oder Kollektionen gibt. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **

Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Top-Angebote
Produkte zum Begriff Code-Set:
-
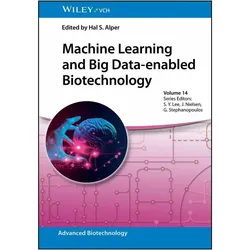
Machine Learning and Big Data-enabled Biotechnology, Fachbücher von Hal S. AlperDas Fachbuch 'Machine Learning and Big Data-enabled Biotechnology' bietet eine umfassende Darstellung der Anwendung von Machine Learning und Big Data in der Biotechnologie. Es gliedert sich in drei Hauptteile, die sich jeweils auf unterschiedliche Aspekte der Biotechnologie konzentrieren. Der erste Teil widmet sich der DNA, wobei Themen von der synthetischen Biologie, wie dem Design von Promotoren, bis hin zu Vorhersagen aus Genomsequenzen behandelt werden. Im zweiten Teil liegt der Fokus auf Proteinen, wobei sowohl Struktur- und Designwerkzeuge als auch die Entdeckung von Stoffwechselwegen und Retrobiosynthese thematisiert werden. Der abschliessende Teil befasst sich mit ganzen Zellen und beleuchtet Machine Learning Ansätze zur Genexpression sowie Vorhersagen von Phänotypen und der Leistung von Bioreaktoren. Das Buch bietet somit einen breiten Überblick über die Integration moderner Datenanalysemethoden in die biotechnologische Forschung und Entwicklung. Es richtet sich an Fachleute und Studierende, die an der Schnittstelle von Biotechnologie, Datenwissenschaft und Ingenieurwesen arbeiten.135,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Learning Resources Code & Go, Robotik Kit, MehrfarbigFühren Sie Ihr Kind mit dem Code & Go® Robot Mouse Activity Set in die spannende Welt der MINT-Fächer ein. Dieses ansprechende und farbenfrohe Set wurde speziell entwickelt, um Grundschüler in die Bereiche Wissenschaft, Technologie, Technik und Mathematik einzuführen. Mit Colby, der Robotermaus, können junge Menschen die grundlegenden Konzepte des Programmierens spielerisch erkunden. Kinder werden ihre Freude daran haben, Colby so zu programmieren, dass er durch verschiedene Labyrinthe navigiert, um den Käse zu erreichen. Das Set enthält 16 Gitterteile, 22 Labyrinthwände, 3 Tunnelteile, 30 doppelseitige Kodierkarten, 10 doppelseitige Labyrinth-Aktivitätskarten, ein Käsestück aus Plastik und eine Anleitung, die endlose Möglichkeiten für kreative Problemlösungen und Lernen bietet. Colby ist 10 cm lang und benötigt 3 AAA-Batterien (nicht im Lieferumfang enthalten). Dieses Lernspielzeug ist für Kinder ab 4 Jahren geeignet und ist somit ein perfektes Geschenk, um das Interesse an MINT zu wecken.76,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Gibt es alte Louis Vuitton Taschen ohne Data Code?
Ja, es gibt alte Louis Vuitton Taschen, die keinen Data Code haben. Der Data Code wurde erst ab den 1980er Jahren eingeführt, daher können ältere Taschen davor keinen haben. Es ist jedoch wichtig zu beachten, dass das Fehlen eines Data Codes nicht unbedingt bedeutet, dass die Tasche gefälscht ist, da es viele andere Faktoren gibt, die bei der Authentifizierung einer Louis Vuitton Tasche berücksichtigt werden sollten. **
Ähnliche Suchbegriffe für Code-Set
-
Learning Resources Big Feelings Pineapple Deluxe SetKinder verwenden die 40 Gesichtsteile und 3 Armpaare, während sie lernen, wie Gesichtsausdrücke und Körperhaltungen zeigen, wie Menschen sich fühlen. Dieses Set umfasst 50 Teile, darunter eine doppelseitige Ananas, die es den Kindern ermöglicht, kontrastierende Gesichtsausdrücke zu gestalten. Sie können den enthaltenen Spiegel nutzen, um ihre eigenen Gesichtsausdrücke zu sehen. Das Set beinhaltet ausserdem ein erweitertes Poster über Gefühle und einen mehrsprachigen Leitfaden zu Aktivitäten. Bitte beachten Sie, dass es kleine Teile enthält und nicht für Kinder unter 3 Jahren empfohlen wird.65,50 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Data Code von Louis Vuitton 2?
Es tut mir leid, aber ich kann keinen spezifischen Data Code für Louis Vuitton 2 finden. Der Data Code ist normalerweise eine Kombination aus Buchstaben und Zahlen, die in Louis Vuitton-Produkten eingestanzt sind und Informationen über das Herstellungsdatum und den Produktionsort geben. Es ist möglich, dass es verschiedene Data Codes für verschiedene Produkte oder Kollektionen gibt. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.