Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **

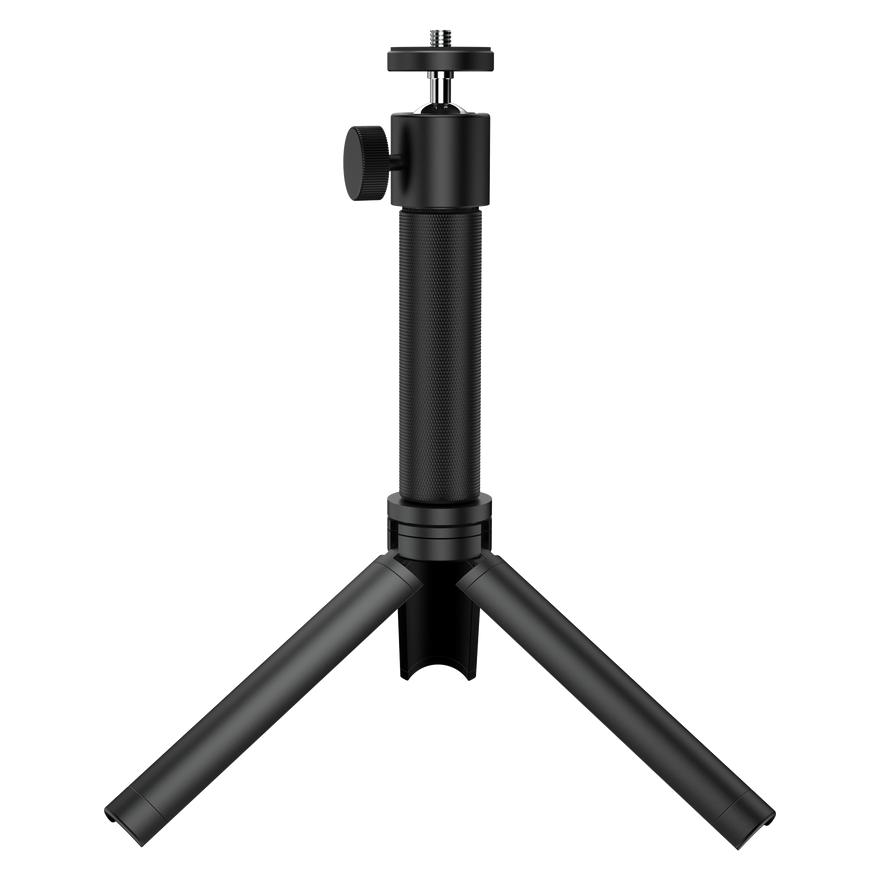
Ähnliche Suchbegriffe für 3DMakerpro-Tripod-1200100064
Top-Angebote
Produkte zum Begriff 3DMakerpro-Tripod-1200100064:
-
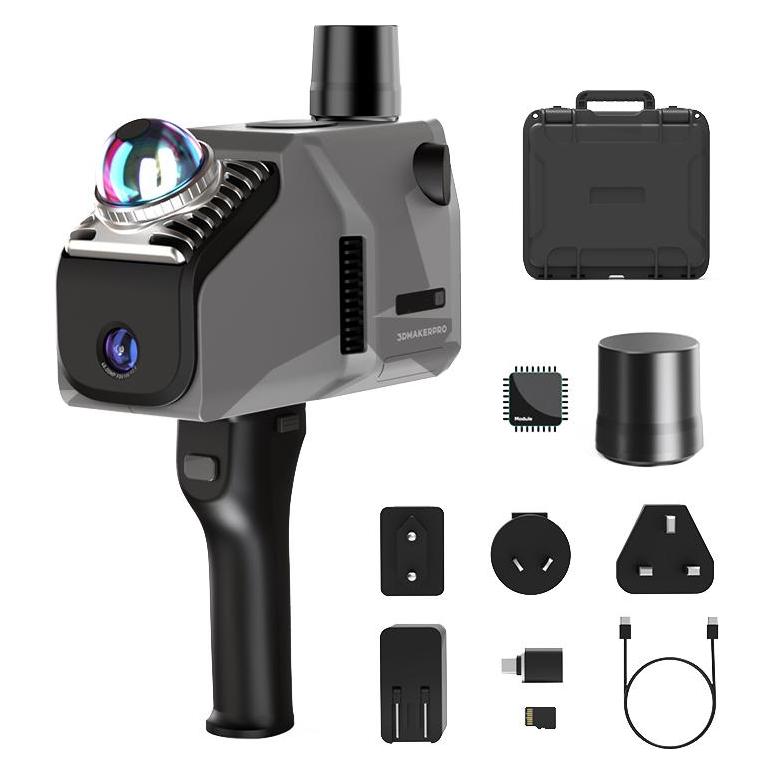
3DMakerPro Hawk 1300100241Präzision durch LiDAR-TechnologieDer Hawk liefert professionelle Präzision mit einem verbesserten LiDAR-Scansystem. Mit einer effektiven Reichweite von 80–140 Metern und einer Punktwolkenrate von 480.000 Punkten pro Sekunde werden selbst feine Details klar erfasst. Die 360° horizontale und 63,5° vertikale Scanabdeckung verhindert blinde Bereiche. Fortschrittliches Bild- und TrackingsystemMit zwei 13 MP-Kameras und einem NIR (Near-Infrared) Trackingsystem erzeugt der Hawk detailreiche Farbpunktwolken und präzise Oberflächendaten. Die 1-Zoll-Sensoren bieten eine hohe Lichtempfindlichkeit und erweiterten Dynamikumfang, ideal für komplexe Lichtverhältnisse. Robust für den Einsatz im FeldDas IP65-zertifizierte Metallgehäuse schützt effektiv vor Wasser und Staub. Die spezielle Reverse-Water-Konstruktion sorgt für zusätzliche Haltbarkeit, während das Metallgehäuse Wärme effizient ableitet und eine stabile Leistung sicherstellt. Starke Leistung und MobilitätDer 8-Kern-2,4 GH7895,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
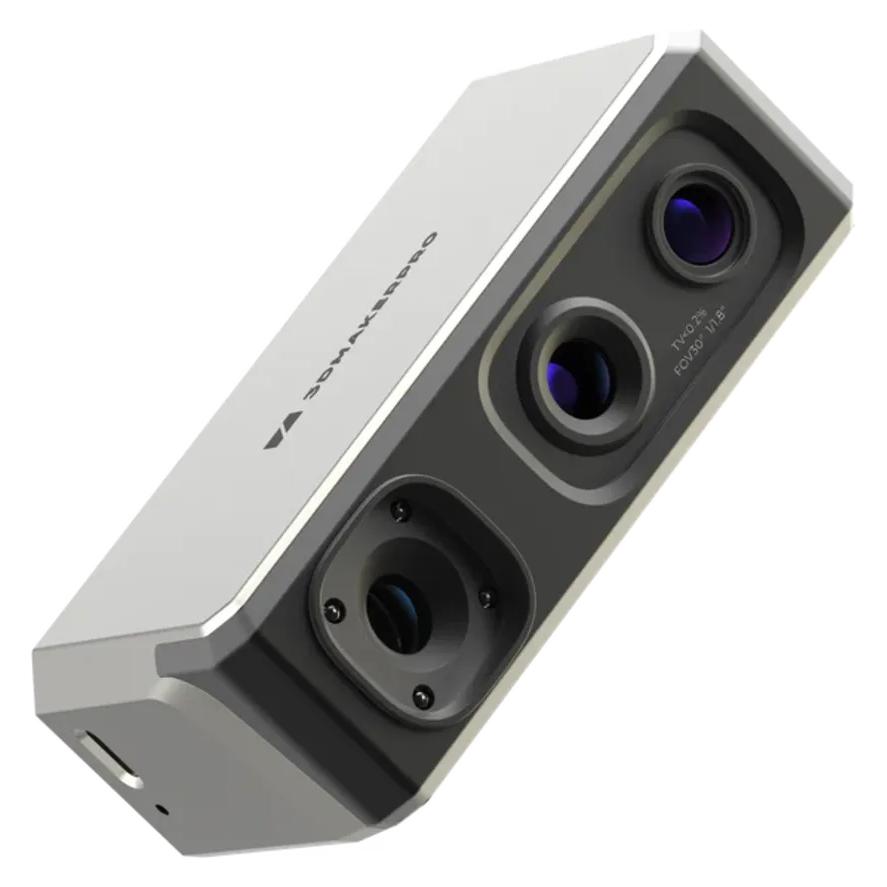
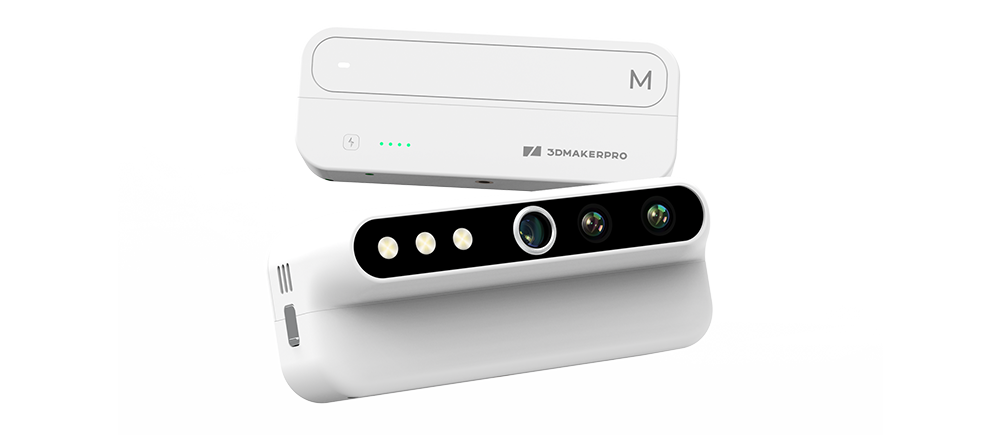
3DMakerpro Turtle 13001002783DMakerpro Turtle - Ein Scansystem für unterschiedliche ObjektgrößenDie Turtle Series von 3DMakerpro verfolgt einen modularen Ansatz beim 3D-Scanning. Statt eine einzige optische Konfiguration für alle Anwendungen zu verwenden, stehen drei austauschbare Scanmodule für unterschiedliche Arbeitsbereiche zur Verfügung. Das S Module eignet sich besonders für feine Details, das M Module für vielseitige Standardanwendungen und das L Module für deutlich größere Objekte. Das Scanmodul kann direkt an einen kompatiblen Computer angeschlossen werden. Mit dem optionalen Turtle Control Pad entsteht ein mobiler Standalone-Workflow, bei dem Scannen, Verarbeiten und Exportieren direkt auf dem Gerät erfolgen. Drei Module für drei unterschiedliche ArbeitsbereicheDie drei Turtle-Module verwenden jeweils eigene optische Konfigurationen. Dadurch kann das Modul gewählt werden, das am besten zur physischen Größe des Objekts und zum erforderlichen Detailgrad passt. S Module - Präzision für kl629,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **


Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Top-Angebote
Produkte zum Begriff 3DMakerpro-Tripod-1200100064:
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für 3DMakerpro-Tripod-1200100064
-
3DMakerPro Hawk 1300100241Präzision durch LiDAR-TechnologieDer Hawk liefert professionelle Präzision mit einem verbesserten LiDAR-Scansystem. Mit einer effektiven Reichweite von 80–140 Metern und einer Punktwolkenrate von 480.000 Punkten pro Sekunde werden selbst feine Details klar erfasst. Die 360° horizontale und 63,5° vertikale Scanabdeckung verhindert blinde Bereiche. Fortschrittliches Bild- und TrackingsystemMit zwei 13 MP-Kameras und einem NIR (Near-Infrared) Trackingsystem erzeugt der Hawk detailreiche Farbpunktwolken und präzise Oberflächendaten. Die 1-Zoll-Sensoren bieten eine hohe Lichtempfindlichkeit und erweiterten Dynamikumfang, ideal für komplexe Lichtverhältnisse. Robust für den Einsatz im FeldDas IP65-zertifizierte Metallgehäuse schützt effektiv vor Wasser und Staub. Die spezielle Reverse-Water-Konstruktion sorgt für zusätzliche Haltbarkeit, während das Metallgehäuse Wärme effizient ableitet und eine stabile Leistung sicherstellt. Starke Leistung und MobilitätDer 8-Kern-2,4 GH7895,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
3DMakerpro Turtle 13001002783DMakerpro Turtle - Ein Scansystem für unterschiedliche ObjektgrößenDie Turtle Series von 3DMakerpro verfolgt einen modularen Ansatz beim 3D-Scanning. Statt eine einzige optische Konfiguration für alle Anwendungen zu verwenden, stehen drei austauschbare Scanmodule für unterschiedliche Arbeitsbereiche zur Verfügung. Das S Module eignet sich besonders für feine Details, das M Module für vielseitige Standardanwendungen und das L Module für deutlich größere Objekte. Das Scanmodul kann direkt an einen kompatiblen Computer angeschlossen werden. Mit dem optionalen Turtle Control Pad entsteht ein mobiler Standalone-Workflow, bei dem Scannen, Verarbeiten und Exportieren direkt auf dem Gerät erfolgen. Drei Module für drei unterschiedliche ArbeitsbereicheDie drei Turtle-Module verwenden jeweils eigene optische Konfigurationen. Dadurch kann das Modul gewählt werden, das am besten zur physischen Größe des Objekts und zum erforderlichen Detailgrad passt. S Module - Präzision für kl629,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wilmott, Paul: Grundkurs Machine LearningGrundkurs Machine Learning , Aus der Buchreihe »Informatik verstehen«. Ideal zum Selbststudium , Querlenker > Sportfederung , Erscheinungsjahr: 20200724, Produktform: Kartoniert, Titel der Reihe: Rheinwerk Computing##, Autoren: Wilmott, Paul, Seitenzahl/Blattzahl: 256, Themenüberschrift: COMPUTERS / General, Keyword: Hand-Buch Bücher lernen Studium Grundlagen Kurse Workshops Tutorials Wissen Anleitung Training Ausbildung; Robotik; Informatik verstehen; Programmierung programmieren; KI-Welt AI; Künstliche Intelligenz; Software-Entwicklung; Coder Coden; Neuronale Netze; Deep Learning; Mathematik, Fachschema: Informatik~Programmiersprachen~EDV / Theorie / Allgemeines, Fachkategorie: Informatik~Informationstechnik (IT), allgemeine Themen, Sprache: Deutsch, Warengruppe: HC/Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Länge: 228, Breite: 175, Höhe: 17, Gewicht: 480, Produktform: Klappenbroschur, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 232715029,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Huyen, Chip: Designing Machine Learning SystemsDesigning Machine Learning Systems , An Iterative Process for Production-Ready Applications , > , Erscheinungsjahr: 202207, Produktform: Kartoniert, Autoren: Huyen, Chip, Themenüberschrift: COMPUTERS / Intelligence (AI) & Semantics~COMPUTERS / Enterprise Applications / Business Intelligence Tools~COMPUTERS / Data Science / Machine Learning, Fachschema: Datenverarbeitung / Anwendungen / Betrieb, Verwaltung~Intelligenz / Künstliche Intelligenz~KI~Künstliche Intelligenz - AI~Management / Strategisches Management~Strategisches Management~Unternehmensstrategie / Strategisches Management, Fachkategorie: Unternehmenssoftware~Strategisches Management, Warengruppe: TB/Informatik, Fachkategorie: Maschinelles Lernen, Text Sprache: eng, Seitenanzahl: XVI, Seitenanzahl: 367, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: O'Reilly Media, Verlag: O'Reilly Media, Länge: 229, Breite: 175, Höhe: 21, Gewicht: 678, Produktform: Kartoniert, Genre: Importe, Genre: Importe, Katalog: Gesamtkatalog, Katalog: Internationale Lagertitel, Katalog: internationale Titel, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0020, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch,53,84 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.